
AI 与工程数学 / 系统课时
用牛顿法比较一阶与二阶更新
用牛顿法比较一阶与二阶更新
梯度下降只利用斜率决定更新方向,牛顿法还利用曲率调整步长。通过一个可以手算、也可以用 Python 运行的二维二次函数,我们将比较两者的参数轨迹、收敛次数与计算成本,并理解为什么牛顿法在小问题上很快,却不一定适合直接训练大型神经网络。
学习目标
- 推导梯度下降与牛顿法的更新公式,解释 Hessian 矩阵的作用。
- 在同一个二维二次函数上实现两种算法,验证迭代次数和最终误差。
- 根据参数维度、曲率性质和计算开销判断何时适合使用二阶方法。
从同一个二次函数出发
考虑目标函数:
它的最优点是 ,最小函数值为 。其中 方向的曲率是 方向的 10 倍,因此同样的坐标变化,在两个方向上引起的函数值变化并不相同。
梯度是一阶导数组成的向量,Hessian 是二阶偏导数组成的矩阵:
这里 Hessian 的两个特征值分别为 和 ,均为正数,说明函数严格凸,具有唯一的全局最小点。条件数为 ,反映两个方向的曲率差异。
梯度下降使用统一学习率 :
牛顿法则通过求解线性方程 得到方向,再更新 。当 Hessian 可逆时,这与下面的写法等价:
在这个例子中,牛顿法沿 方向消去完整的 ,沿 方向使用曲率修正消去完整的 。从起点 出发,一次更新就到达 。这是正定二次函数使用精确 Hessian 和完整牛顿步时的特殊性质,并不意味着任意非线性函数都能一步收敛。
看清两种更新的参数轨迹
选择梯度下降学习率 ,起点 。两个坐标的更新变为:
因此第 1 次更新后,梯度下降到达 ,函数值为 ;牛顿法直接到达 ,函数值为 。之后梯度下降只能让 每次缩小 10%。
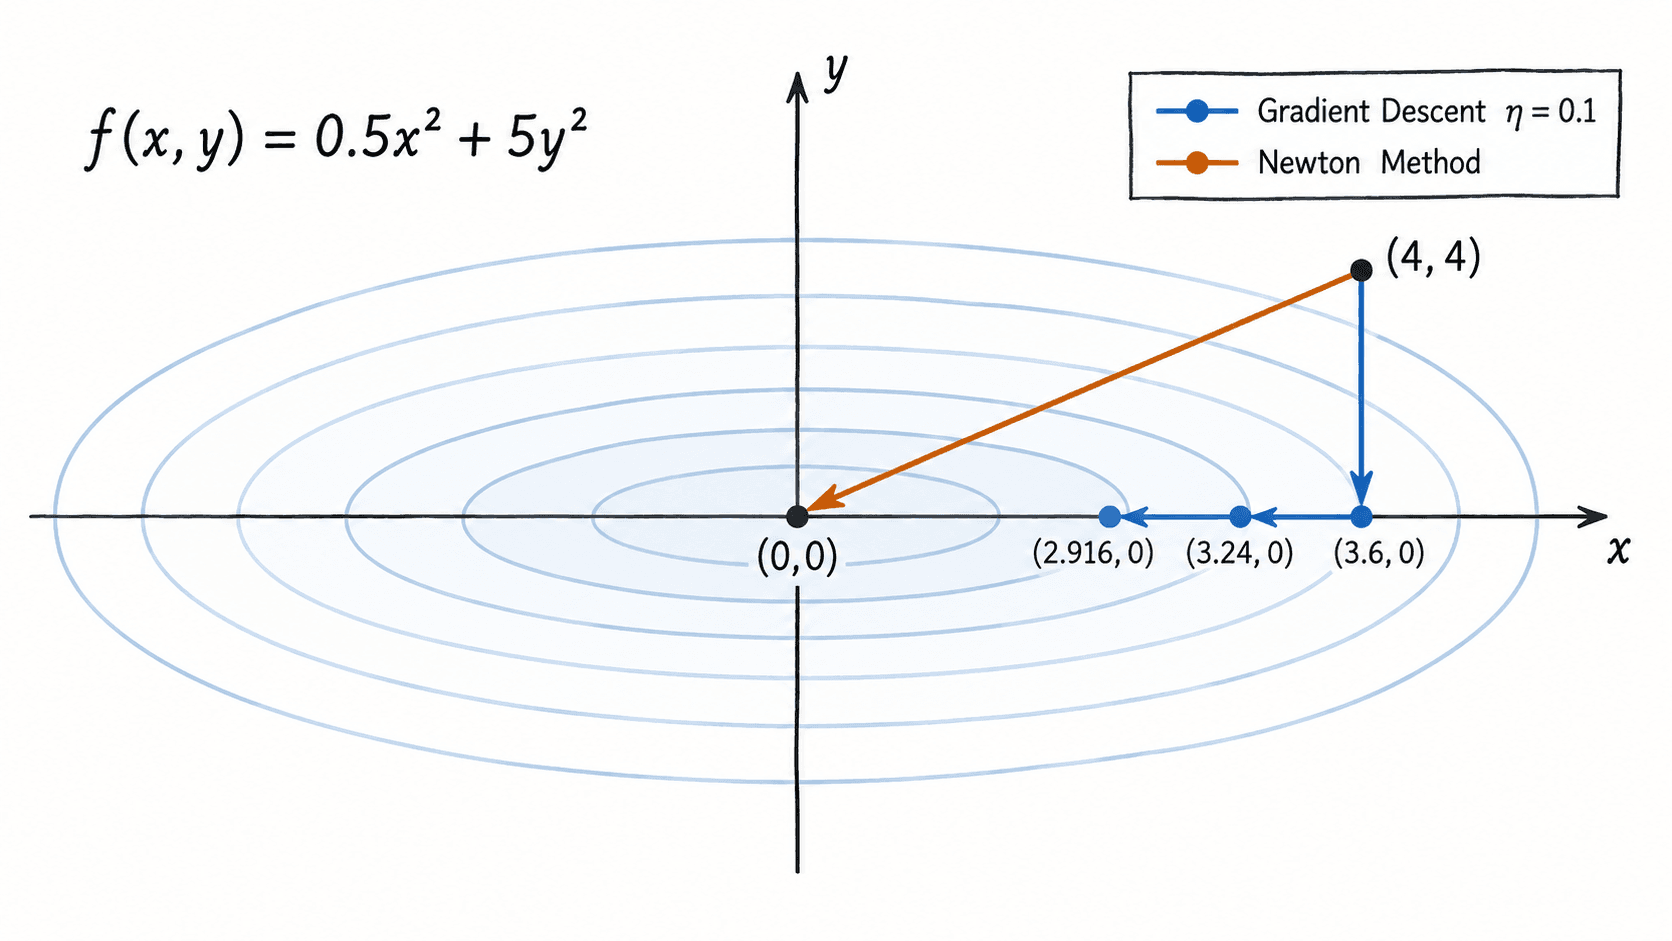
为了避免只凭轨迹判断快慢,还要统一停止条件。下面使用梯度范数小于 作为收敛标准,最多执行 300 次更新。由于初始梯度范数约为 ,两个算法都需要真正执行更新。
用 Python 实现并验证
环境要求为 Python 3.10 或更新版本,以及 NumPy 1.24 或更新版本。先安装依赖:
python -m pip install "numpy>=1.24,<3"预期结果:安装命令正常结束,终端没有报错;安装日志和版本号因环境而异。
将下面代码保存为 compare_optimizers.py。示例使用同一个函数、同一个起点、同一个收敛阈值,并统计梯度评估、Hessian 评估和线性方程求解次数。
import numpy as np

A = np.diag([1.0, 10.0])
START = np.array([4.0, 4.0])
TOL = 1e-6
MAX_STEPS = 300


def objective(w):
    return 0.5 * float(w @ A @ w)


def optimize(method):
    w = START.copy()
    counts = {"grad": 0, "hessian": 0, "solve": 0}

    for step in range(MAX_STEPS + 1):
        grad = A @ w
        counts["grad"] += 1
        if np.linalg.norm(grad) < TOL:
            return step, w, counts
        if step == MAX_STEPS:
            break

        if method == "gd":
            # 两个方向共享学习率,较小曲率方向衰减较慢。
            direction = 0.1 * grad
        else:
            # 用线性求解代替显式构造 Hessian 的逆矩阵。
            hessian = A.copy()
            counts["hessian"] += 1
            direction = np.linalg.solve(hessian, grad)
            counts["solve"] += 1
        w = w - direction

    raise RuntimeError("未在最大迭代次数内收敛")


for method in ("gd", "newton"):
    steps, solution, counts = optimize(method)
    print(f"{method}: steps={steps}, loss={objective(solution):.3e}")
    print(f"  grad={counts['grad']}, "
          f"hessian={counts['hessian']}, solve={counts['solve']}")
运行命令:
python compare_optimizers.py预期输出(浮点数最后几位可能因平台而异):
gd: steps=145, loss=1.087e-13
  grad=146, hessian=0, solve=0
newton: steps=1, loss=0.000e+00
  grad=2, hessian=1, solve=1
145 次并非人为设定,而是由收敛条件决定。因为第一次更新后 ,后续梯度范数为 。要让它小于 ,需要 ,因此最小整数更新次数是 145。
这里的 grad 统计包含最后一次停止检查,所以梯度下降执行 145 次参数更新,却进行了 146 次梯度评估。牛顿法仅进行 1 次 Hessian 评估和线性方程求解。示例中 Hessian 是常数,仍按每次牛顿更新计入一次评估;实际实现可以缓存它。
迭代少不等于计算便宜
二阶方法的优势是利用曲率信息减少更新次数,但每次更新通常更加昂贵。对于具有 个参数的密集问题,可以参考以下数量级:
| 项目 | 梯度下降 | 经典密集牛顿法 |
|---|---|---|
| 导数信息 | 梯度, 个分量 | 梯度及 Hessian |
| 额外矩阵存储 | 通常 | |
| 每次方向计算 | 向量缩放 | 一般密集线性求解约 |
| 本例更新次数 | 145 | 1 |
| 非凸问题 | 仍需调学习率 | Hessian 不定时方向可能不是下降方向 |
表中的复杂度只比较优化方向相关的典型操作,没有把模型前向、反向计算以及 Hessian 构建成本全部计入。对于特定稀疏、对角或具有特殊结构的 Hessian,可以利用结构显著降低求解成本。
例如 时,一个以 64 位浮点数密集存储的 Hessian 包含 个元素,仅矩阵数据就需要约 800 MB;还没有计算分解过程的临时内存。而梯度向量只需要约 80 KB。对于百万乃至更高维度的神经网络,直接构造完整 Hessian 往往不可行。
因此不能仅凭 145 次对 1 次就宣称牛顿法的实际运行时间一定更短。本例只有二维,执行时间容易受到 Python 调用与 NumPy 固定开销影响,不适合用来推断大型模型的性能。
牛顿法遇到非凸曲率会怎样
正定 Hessian 能保证牛顿方向是局部下降方向,但非凸函数的 Hessian 可能包含负特征值。考虑一维函数:
其导数为 ,二阶导数为 。在 时,梯度为 ,二阶导数为 ,完整牛顿更新得到:
原始函数值 ,更新后的函数值约为 ,反而增大了。原因是负曲率使完整牛顿方向变成上升方向。该函数的两个最小点实际上位于 ,函数值均为 。
面对非凸损失,工程上通常不会无条件接受完整牛顿步。可通过阻尼、信赖域或正则化 Hessian 等方法控制更新。具体而言,可以尝试求解 ,并选择足够大的 使修正矩阵正定,再配合实际损失下降检查;并不是任意正的 都能保证下降。
在 AI 训练中,一阶优化器通常更容易扩展到高维参数和小批量随机梯度;二阶或近似二阶方法则适合维度较低、曲率信息可经济获取,或确实需要快速局部收敛的场景。选择算法时应同时报告最终损失、梯度范数、更新次数、实际耗时和峰值内存,而不是只看迭代次数。