
AI 与工程数学 / 系统课时
用梯度统计识别消失与爆炸
用梯度统计识别消失与爆炸
模型训练时,损失不下降、突然变成 NaN,或者深层网络始终学不动,都可能与梯度有关。本篇通过逐层记录梯度范数、最大值和更新比例,区分梯度消失、梯度爆炸、激活饱和与学习率过大,并用可运行的 PyTorch 实验验证诊断结果。
学习目标
- 能记录连续训练步骤中的逐层梯度统计,识别异常趋势。
- 能通过梯度、激活值和参数更新量区分不同故障原因。
- 能使用梯度裁剪、激活函数调整和学习率修正验证诊断结论。
梯度统计应该记录什么
仅观察训练损失不足以判断优化器内部发生了什么。对于参数张量 ,梯度 反映损失对参数的局部敏感程度,而实际参数变化还受到优化器、学习率和权重衰减等因素影响。
建议对每个关键层记录以下指标:
| 指标 | 计算方式 | 主要用途 |
|---|---|---|
| 梯度 L2 范数 | 观察梯度整体尺度 | |
| 梯度最大绝对值 | 发现局部极大值 | |
| 梯度均方根 RMS | 比较不同大小的参数张量 | |
| 零梯度比例 | 检查大量梯度恰好为零的现象 | |
| 更新比例 | 判断参数实际改变幅度 |
不同层的参数量不同,直接比较 L2 范数容易误判。例如,一个层有 10000 个梯度元素,另一个只有 100 个,即使每个元素的 RMS 都是 0.001,二者的 L2 范数也分别约为 0.1 和 0.01。跨层比较时应同时查看 RMS。
第一次排查可以连续采样 50~200 个训练步骤,记录各层 RMS、范数以及是否出现非有限值。后续训练可每隔 50~100 步记录一次;这些采样间隔是排查起点,并非固定标准。
运行逐层梯度监控实验
下面使用 PyTorch 2.x 和 CPU 构造一个五层隐藏网络,对固定的回归数据训练 60 步。代码会记录第一层、最后一层的梯度 RMS,以及全模型梯度范数。使用 SGD 是为了让学习率对更新的影响更容易分析。
安装依赖后,将代码保存为 gradient_probe.py。
python -m pip install "torch>=2.0,<3.0"预期结果:命令成功时,pip 以安装成功信息结束;若依赖已存在,则显示 Requirement already satisfied。具体版本和安装日志随环境变化。
import math
import torch
from torch import nn

torch.manual_seed(7)
torch.set_num_threads(1)

# 使用固定数据与随机种子,便于比较不同实验设置。
x = torch.randn(128, 16)
y = x[:, :1] * 2.0 - x[:, 1:2]

layers = [nn.Linear(16, 32), nn.Tanh()]
for _ in range(4):
    layers.extend([nn.Linear(32, 32), nn.Tanh()])
layers.append(nn.Linear(32, 1))
model = nn.Sequential(*layers)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
loss_fn = nn.MSELoss()
weights = [(name, p) for name, p in model.named_parameters()
           if name.endswith("weight")]

for step in range(1, 61):
    optimizer.zero_grad(set_to_none=True)
    loss = loss_fn(model(x), y)
    loss.backward()

    # 在 optimizer.step() 之前读取原始梯度。
    stats = []
    for name, p in weights:
        g = p.grad.detach()
        rms = torch.sqrt(torch.mean(g.square())).item()
        stats.append((name, rms))

    total_norm = math.sqrt(sum(
        p.grad.detach().square().sum().item()
        for p in model.parameters() if p.grad is not None
    ))
    if step in (1, 10, 30, 60):
        print(f"step={step} loss={loss.item():.5f} "
              f"first_rms={stats[0][1]:.3e} "
              f"last_rms={stats[-1][1]:.3e} "
              f"global_norm={total_norm:.3e}")
    optimizer.step()
预期结果:控制台输出四条记录,分别对应第 1、10、30、60 步,包含 loss、first_rms、last_rms 和 global_norm 字段。由于 PyTorch 运行环境可能存在数值差异,不要求逐位一致。若训练正常,通常能看到有限的梯度数值与逐步下降的损失。
这里记录的是反向传播之后、参数更新之前的梯度。若使用梯度累积,应先明确当前统计的是单个微批次还是多个微批次累计结果,否则不同训练轮次不能直接比较。
根据层间分布识别梯度消失与爆炸
梯度消失表现为靠近输入端的层长期收到极弱的训练信号。例如连续 100 步中,第一层梯度 RMS 约为 ,输出层为 ,两者相差约一百万倍,同时第一层参数几乎不变,就值得进一步检查。
梯度爆炸则可能表现为多层梯度快速放大,全局范数从 2、8、40 增长到 600,随后损失剧烈震荡甚至出现 Inf 或 NaN。上述数值是诊断示例,并非统一的异常阈值。
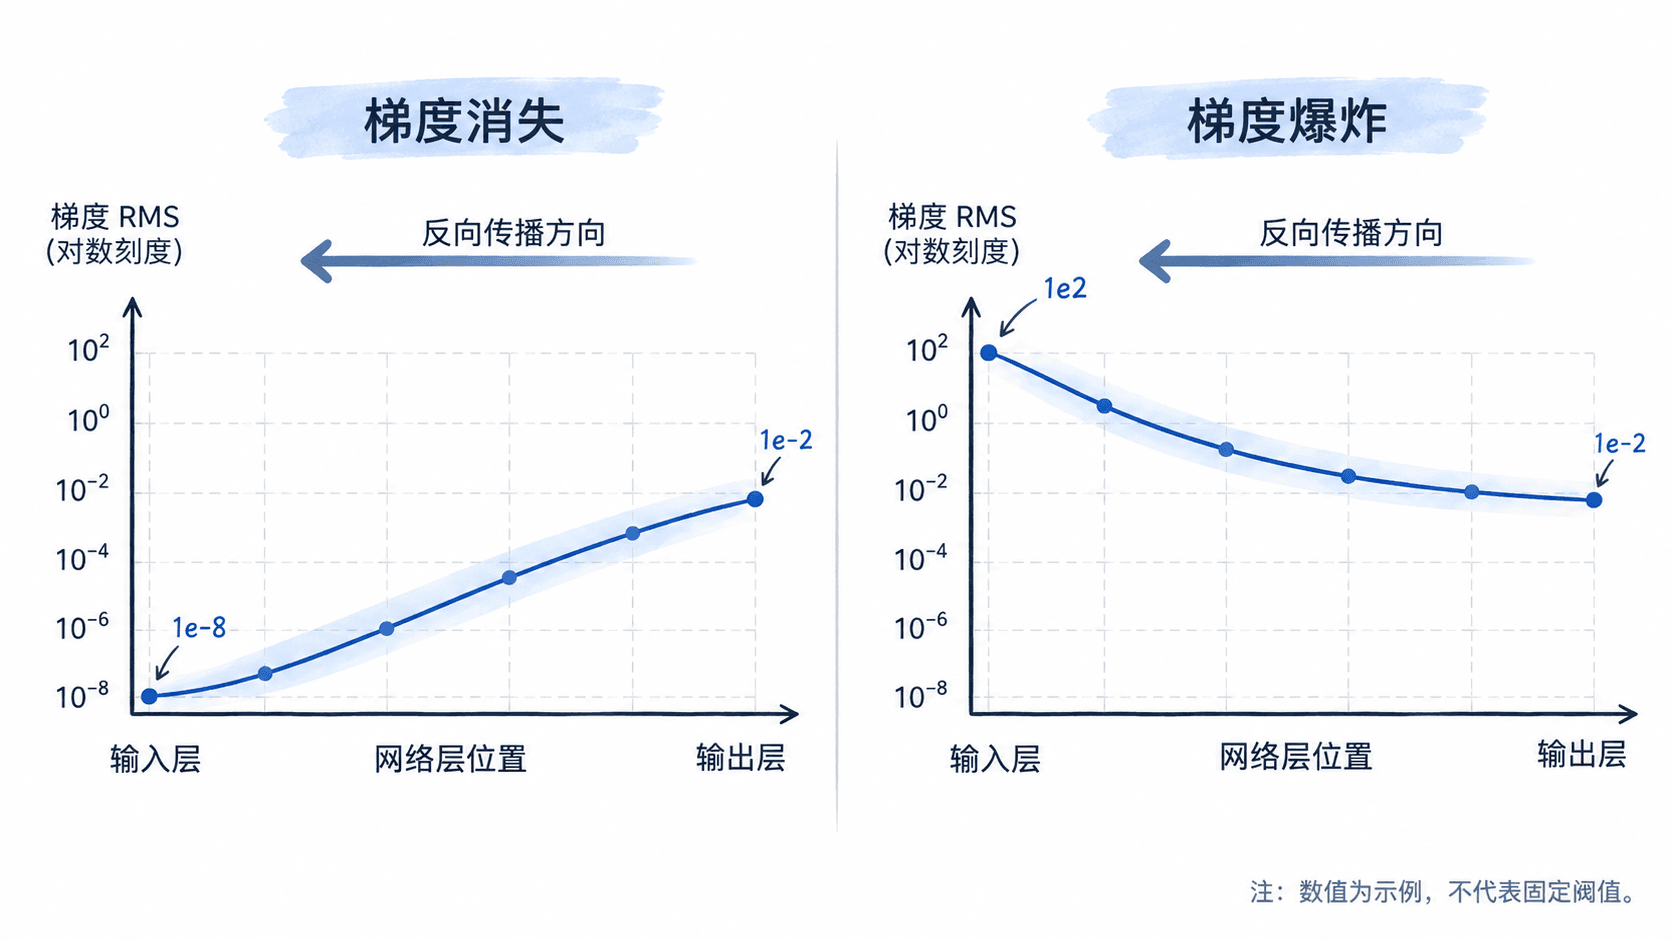
实际排查时可按以下顺序判断:
- 先检查梯度是否包含 NaN 或 Inf。如果已经存在非有限值,不能继续用普通范数大小判断趋势。
- 比较同一步不同层的 RMS,判断梯度是否沿网络深度呈持续衰减或放大。
- 比较同一层连续多步的 RMS,区分偶发尖峰与持续异常。
- 同时检查损失和参数更新比例,确认异常梯度是否真正妨碍学习。
不能简单规定 RMS 小于 就一定是梯度消失。损失函数的归约方式、参数尺度、网络结构及混合精度都会改变梯度大小。如果损失已经接近目标值,小梯度可能完全正常。
区分激活饱和和学习率过大
激活饱和是梯度变小的一种具体原因。例如 tanh 在输入绝对值较大时输出接近 -1 或 1,其导数 接近 0。若某隐藏层的激活值长期有 95% 以上满足 ,同时其前面层的梯度明显偏小,可以怀疑出现饱和。
可以为 tanh 层添加前向 Hook,记录激活绝对值超过 0.99 的比例。以下为片段示例,依赖前面已经创建的 model,应在训练循环开始之前安装 Hook,并在结束后移除。
saturation = {}
handles = []

for index, layer in enumerate(model):
    if isinstance(layer, nn.Tanh):
        def capture(module, inputs, output, key=index):
            # Hook 只记录统计值,不修改计算图或激活结果。
            saturation[key] = (output.detach().abs() > 0.99).float().mean().item()
        handles.append(layer.register_forward_hook(capture))

# 每次 model(x) 后读取 saturation;实验结束时清理 Hook。
验证方法:执行一次 model(x) 后检查 saturation 中各层的比例,数值应在 0~1 之间。完成采集后调用各句柄的 remove() 方法,避免重复注册。95% 只是可用于优先排查的示例阈值,并不能单独证明饱和是损失停滞的原因。
学习率过大则是另一类问题。即使梯度值有限且分布正常,优化器仍可能使参数跨过合适的下降区域。对于不带动量和权重衰减的普通 SGD,有 ;当学习率从 0.01 提高到 1 时,相同梯度对应的更新量扩大 100 倍。
| 观察结果 | 优先怀疑 | 验证动作 |
|---|---|---|
| 早期层 RMS 远小于末层 | 梯度消失 | 检查激活饱和、网络深度和初始化 |
| 多层范数迅速升高并伴随损失尖峰 | 梯度爆炸 | 降低学习率,检查梯度裁剪前的范数 |
| 激活大量接近 -1 或 1 | tanh 饱和 |
检查激活前输入分布,尝试缩小初始化尺度 |
| 梯度有限但更新比例过大、损失反复震荡 | 学习率过大 | 将学习率降低 10 倍后对照相同步数 |
对于 SGD,可以在更新前复制参数,更新后计算真实的 。如果使用 AdamW、动量或权重衰减,不能直接用学习率乘梯度范数代替真实更新量。
用干预实验确认根因
定位问题后,应每次只修改一项条件,并保持随机种子、数据批次、模型结构和训练步数一致,比较干预前后的损失曲线、梯度 RMS 和更新比例。
对于怀疑梯度爆炸的模型,可以在 loss.backward() 后、optimizer.step() 前增加梯度裁剪。下面是依赖前面训练脚本中 model 的片段示例,用于替换相应的更新位置。
# 返回值是裁剪前的全模型梯度范数。
raw_norm = torch.nn.utils.clip_grad_norm_(
    model.parameters(), max_norm=1.0, error_if_nonfinite=True
)
optimizer.step()
验证方法:分别比较裁剪前 raw_norm 和裁剪后重新计算的范数。当原始 L2 范数大于 1.0 时,正常情况下裁剪后约不超过 1.0;否则梯度保持原有尺度。max_norm=1.0 是常见实验起点,不是所有模型的最优值。
梯度裁剪只能限制更新所使用的梯度范数,不能修复所有数值错误。如果损失在反向传播之前已变为 NaN,必须检查输入、归一化、损失公式和混合精度流程,而不能依靠裁剪解决。
对于激活饱和,可以减少过大的输入尺度、检查初始化,或者在适合任务时比较 tanh 与 ReLU 等激活函数。对于学习率过大,先将 0.01 改成 0.001,保持其他条件不变,观察相同步数下损失尖峰是否减少。
建议将实验结果整理为四列:故障假设、修改项、修改前指标、修改后指标。例如原始梯度范数峰值为 120,启用范数裁剪后实际用于更新的范数不超过约 1.0,但损失仍没有下降,就需要继续检查更新幅度、模型表达能力和数据,而不是直接宣布问题已经解决。
最终判断应以多轮统计和可重复的干预结果为依据:梯度尺度揭示反向传播的信号,激活分布帮助解释信号为何衰减,真实参数更新量则说明优化器究竟执行了多大的更新。