
AI 与工程数学 / 系统课时
损失停滞时怎么排查训练链路
损失停滞时怎么排查训练链路
训练时损失连续多个批次几乎不变,不一定意味着模型已经收敛,也可能是梯度没有传回、优化器没有更新参数,或者日志记录了错误的指标。本篇使用 PyTorch 搭建可复现的诊断脚本,按照前向损失、反向梯度、优化器步进和参数变化的顺序定位问题,并验证修复是否有效。
学习目标
- 能区分正常收敛、训练停滞和日志显示异常。
- 能按前向计算、反向传播、优化器更新和参数变化四个环节定位故障。
- 能运行诊断脚本,通过梯度和参数差值确认训练是否真正发生。
先确认损失是否真的停滞
不要仅凭最后两个批次的损失判断训练失败。先固定训练数据和评估方式,比较至少 20~50 个更新步骤的趋势,并记录学习率、损失、梯度范数和参数变化量。
例如,某模型连续 50 步的训练损失都在 0.6931 附近,可能是二分类模型始终输出接近 0.5,也可能只是损失被保留四位小数后看起来相同。
建议先检查三项:
- 打印至少六位小数,例如
0.693147,排除显示精度造成的假停滞。 - 使用固定的一个小批次重复训练 100 步,观察模型能否记住这批数据。
- 同时记录训练损失和固定验证集损失,避免把验证集不再改善误判为参数停止更新。
如果固定小批次的损失能明显下降,说明基本训练链路大概率可用,应进一步检查数据分布、批次难度和泛化问题。如果固定小批次也完全无法下降,就要检查计算链路。
按训练链路逐段定位
一次典型的 PyTorch 训练更新包含四个关键检查点:前向计算得到有效损失、反向传播产生梯度、优化器执行更新、模型参数实际发生变化。
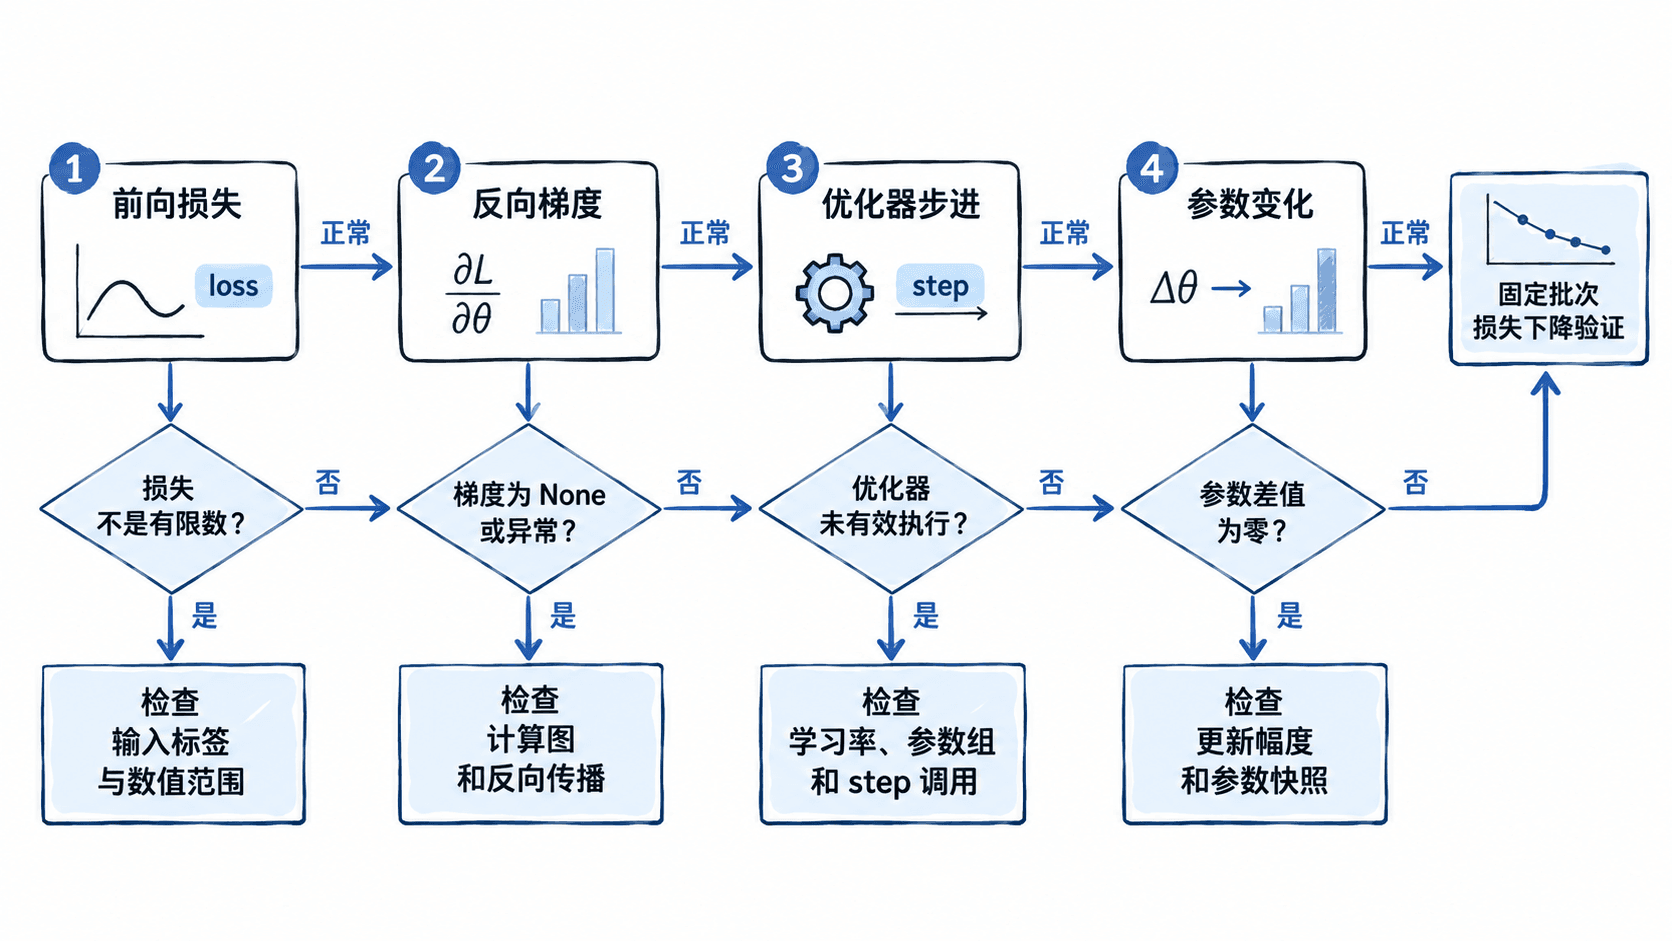
各环节可使用以下指标快速判断:
| 检查点 | 正常表现 | 异常线索 |
|---|---|---|
| 前向损失 | 标量且为有限数 | NaN、Inf、标签不匹配 |
| 反向梯度 | 应训练参数具有有效梯度 | grad is None、全零或非有限值 |
| 优化器步进 | 学习率大于零,目标参数属于参数组 | 忘记调用 step()、学习率为零 |
| 参数变化 | 至少部分目标参数产生非零差值 | 更新前后完全一致 |
注意,梯度为零不一定是错误。例如 ReLU 神经元处于负半轴时,该路径可能没有梯度;冻结的参数也可能没有梯度。判断时应结合参数职责,而不是要求所有参数的梯度都非零。
运行四阶段诊断脚本
以下示例适用于 PyTorch 2.x,使用 CPU 即可运行。环境需要 Python 3.10 或更新版本,并已安装兼容的 torch。模型学习线性关系 y = 2x + 1,故意使用零学习率制造损失停滞,再修复为正常学习率。
将以下代码保存为 diagnose_training.py:
import torch
from torch import nn

# 固定数据和初始参数,使两轮诊断可比较
torch.manual_seed(42)
x = torch.linspace(-1, 1, 32).unsqueeze(1)
y = 2 * x + 1


def train_case(lr: float):
    model = nn.Linear(1, 1)
    with torch.no_grad():
        model.weight.fill_(0.0)
        model.bias.fill_(0.0)

    optimizer = torch.optim.SGD(model.parameters(), lr=lr)
    criterion = nn.MSELoss()
    initial_loss = criterion(model(x), y).item()
    last_grad_norm = 0.0
    max_delta = 0.0

    for _ in range(100):
        optimizer.zero_grad(set_to_none=True)
        loss = criterion(model(x), y)
        if not torch.isfinite(loss).item():
            raise RuntimeError("前向损失不是有限数")

        # 检查反向传播是否为可训练参数生成梯度
        loss.backward()
        grads = [p.grad for p in model.parameters()]
        if any(g is None for g in grads):
            raise RuntimeError("存在缺失梯度的参数")
        if any(not torch.isfinite(g).all().item() for g in grads):
            raise RuntimeError("存在非有限梯度")
        last_grad_norm = torch.sqrt(
            sum(g.square().sum() for g in grads)
        ).item()

        # 更新前复制参数,避免快照和原参数共享存储
        before = [p.detach().clone() for p in model.parameters()]
        optimizer.step()
        max_delta = max(
            (p.detach() - old).abs().max().item()
            for p, old in zip(model.parameters(), before)
        )

    final_loss = criterion(model(x), y).item()
    print(f"lr={lr:.2f}")
    print(f"initial_loss={initial_loss:.6f}")
    print(f"final_loss={final_loss:.6f}")
    print(f"grad_norm={last_grad_norm:.6f}")
    print(f"parameter_delta={max_delta:.8f}")


train_case(0.0)
train_case(0.1)
运行命令:
python diagnose_training.py预期结果:两轮初始损失相同。第一轮虽然梯度非零,但学习率为零,导致参数差值为零、损失不下降;第二轮参数发生变化,损失明显下降并接近零。以下是应满足的关键结果,实际末位数值可能因运行环境略有差异:
lr=0.00
initial_loss=2.419355
final_loss=2.419355
...
parameter_delta=0.00000000
lr=0.10
initial_loss=2.419355
final_loss=0.000000
...
parameter_delta=0.00000000
这里最后一个 parameter_delta 仅代表第 100 次更新的最大参数差值;由于模型已接近最优点,在八位小数下可能显示为零。判断训练期间是否更新过参数,应额外记录整个训练过程的最大差值,或者比较初始参数与最终参数,而不能只看最后一步。
更稳妥的修改是在循环外初始化 largest_delta = 0.0,并在每次 optimizer.step() 后累计历史最大差值。若正常学习率对应的历史最大差值大于零,就能证明优化器实际改变过参数。
根据异常指标定位根因
前向损失异常
如果损失出现 NaN 或 Inf,优先检查输入是否包含非有限数、损失函数与标签是否匹配,以及是否出现数值溢出。
例如 nn.CrossEntropyLoss 通常接收未经 Softmax 的 logits;对于类别索引标签,目标张量需要使用 torch.long,取值范围是 0 到 类别数 - 1。不要先手工计算 Softmax 再当作 logits 传入,否则计算含义会改变。
梯度缺失或全零
如果损失正常但 grad is None,检查是否错误使用了 detach()、torch.no_grad(),或者参数的 requires_grad 是否被关闭。
如果梯度存在但全部为零,检查激活函数是否饱和、损失是否依赖这些参数。对于本例的线性模型,初始权重和偏置均为零时,首步梯度应非零。
优化器未更新参数
梯度正常但参数不变时,依次检查:
optimizer.param_groups中的实际学习率,不能只看配置文件里的声明。- 优化器是否在正确的模型参数上创建,尤其注意重新实例化模型后没有重建优化器的情况。
- 是否确实执行
optimizer.step(),以及是否在backward()之后、清零梯度之前执行。 - 是否启用了混合精度训练;发生梯度溢出时,梯度缩放器可能跳过本次优化器更新。
验证修复而不是只看一条日志
修复后,建议在相同数据、随机种子和初始参数条件下重新运行至少 100 步,并同时确认三个结果:
- 初始损失和最终损失具有可比较的定义,固定小批次上的最终损失明显下降。
- 至少一个预期参与训练的参数,其初始值和最终值不同。
- 梯度、损失始终为有限数,且优化器实际使用的学习率符合预期。
对本例而言,学习率从 0.0 改为 0.1 后,固定批次的均方误差应从约 2.419355 降到接近零;权重逐渐接近 2,偏置逐渐接近 1。这比单独看到 optimizer.step() 被调用更能说明训练链路有效。
如果梯度和参数都在正常变化,但训练损失依然长期不下降,再检查学习率是否过大、梯度方向是否被错误修改、数据标签是否错位,以及模型容量是否不足。不要在确认更新链路之前盲目增大模型或延长训练时间。