
AI 与工程数学 / 系统课时
验证损失回升时如何选择早停
验证损失回升时如何选择早停
训练损失持续下降并不代表模型还在变好:验证损失连续回升通常意味着继续拟合训练样本已经不能改善泛化。本篇用验证集损失设置 patience,区分短期波动与持续恶化,并在训练过程中始终保存验证指标最好的参数。
学习目标
- 根据训练集、验证集曲线判断是否出现过拟合,而不是看到一次回升就停止
- 用
patience与min_delta写出可执行的早停判断 - 保存并恢复验证损失最低时的参数,而不是直接使用最后一轮参数
从两条损失曲线判断停止位置
假设训练 12 个 epoch 后得到以下验证损失:0.62, 0.51, 0.44, 0.39, 0.36, 0.35, 0.351, 0.354, 0.358, 0.363, 0.369, 0.376。第 6 轮达到最低值 0.35,之后虽然训练损失仍可能继续下降,但验证损失已经连续恶化。
不能把“验证损失第一次增加”直接等同于过拟合。小批量训练、数据增强和验证样本量有限时,单轮上下浮动很常见。例如 0.350 → 0.352 → 0.347 实际又出现了新最佳值。如果 patience=1,模型会过早停止;若 patience=3,则允许连续 3 轮没有显著改善后再退出。
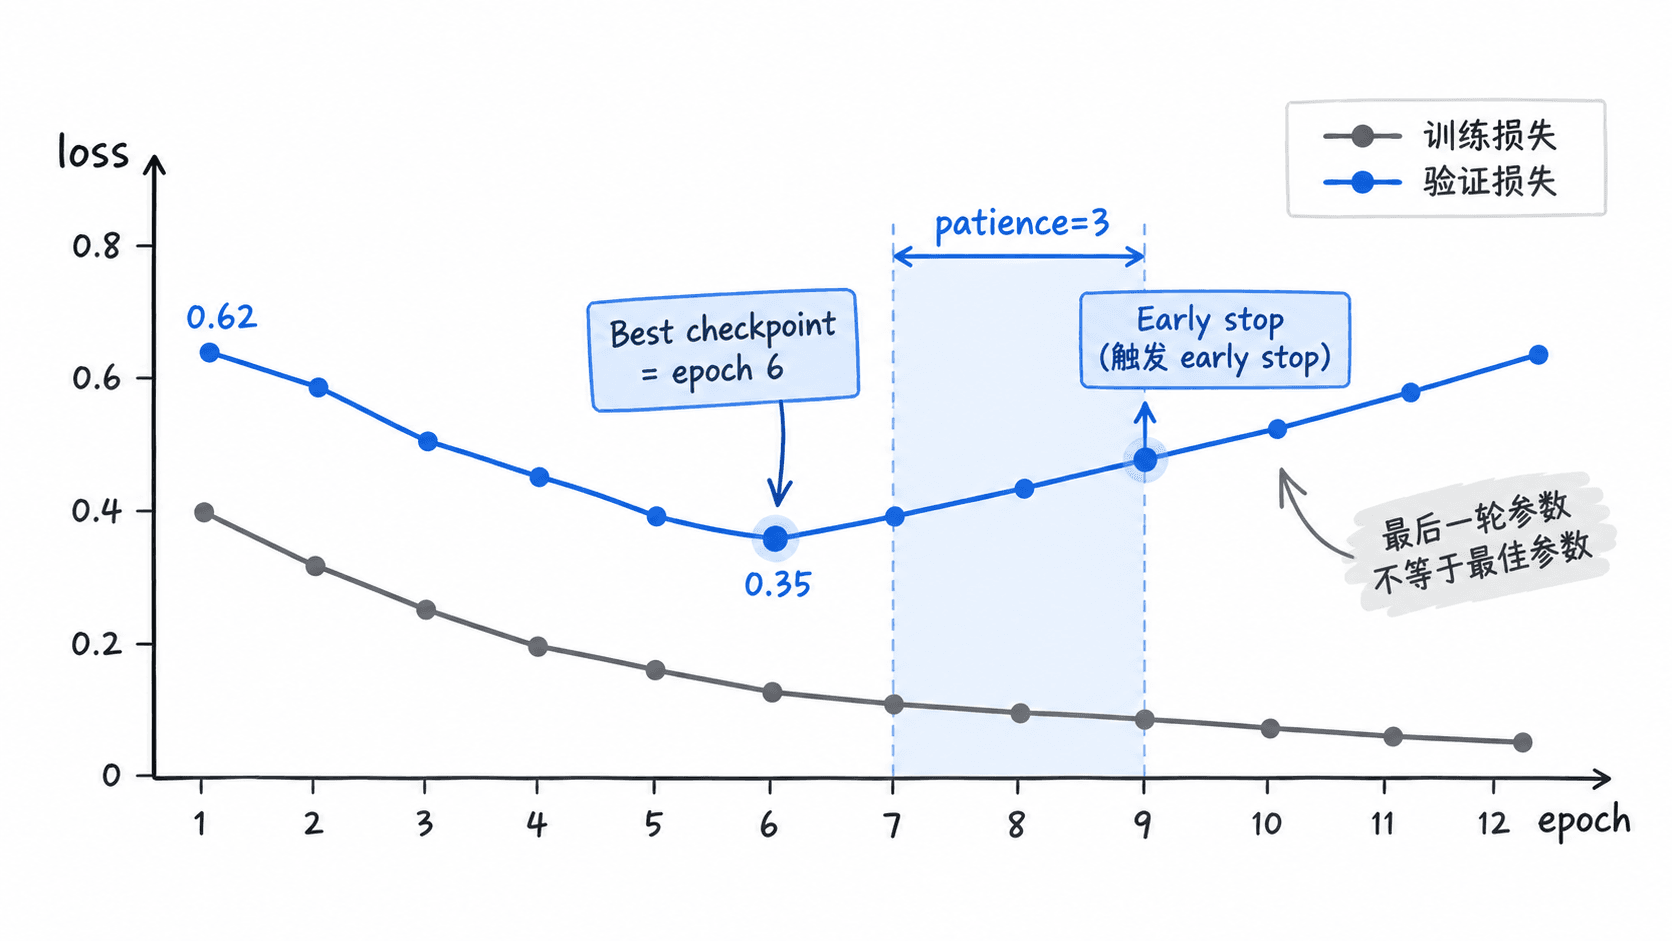
实际检查时可以同时看两件事:训练损失是否仍在下降,以及验证损失是否在若干轮内无法刷新最低值。两条曲线开始明显分叉,比单看某一个 epoch 的验证损失更可靠。
用 patience 和 min_delta 定义“没有改善”
patience 表示允许连续多少个 epoch 未刷新最佳指标,min_delta 则规定改善至少要有多大才算有效。若当前最佳验证损失为 0.3500,设置 min_delta=0.001,那么新值必须小于 0.3490 才算真正改善;0.3496 虽然数值更低,但不会重置等待计数器。
一个实用起点是:验证曲线较平滑时使用 patience=3~5;噪声较大的小数据集可从 5~10 开始。min_delta 应结合损失量级,例如交叉熵约在 0.1~1 时可以先试 1e-3,而不是机械套用固定数值。
下面的 Python 示例模拟验证损失监控,并在每次出现真正的新最佳值时保存参数快照。这里用一个标量 weight 代表模型参数,真实项目中对应的是完整的模型权重。
val_losses = [0.62, 0.51, 0.44, 0.39, 0.36, 0.35,
              0.351, 0.354, 0.358, 0.363, 0.369, 0.376]

patience = 3
min_delta = 0.001
best_loss = float("inf")
best_epoch = 0
best_weight = None
wait = 0

for epoch, val_loss in enumerate(val_losses, start=1):
    weight = epoch * 0.1  # 用标量模拟本轮训练后的模型参数

    if val_loss < best_loss - min_delta:
        best_loss = val_loss
        best_epoch = epoch
        best_weight = weight
        wait = 0
        print(f"epoch={epoch}: save checkpoint, val_loss={val_loss:.3f}")
    else:
        wait += 1
        print(f"epoch={epoch}: no improvement, wait={wait}/{patience}")

    if wait >= patience:
        print(f"early stop at epoch={epoch}")
        break

print(f"restore epoch={best_epoch}, val_loss={best_loss:.3f}, weight={best_weight:.1f}")
预期输出:
epoch=1: save checkpoint, val_loss=0.620
epoch=2: save checkpoint, val_loss=0.510
epoch=3: save checkpoint, val_loss=0.440
epoch=4: save checkpoint, val_loss=0.390
epoch=5: save checkpoint, val_loss=0.360
epoch=6: save checkpoint, val_loss=0.350
epoch=7: no improvement, wait=1/3
epoch=8: no improvement, wait=2/3
epoch=9: no improvement, wait=3/3
early stop at epoch=9
restore epoch=6, val_loss=0.350, weight=0.6
这里真正用于推理或后续微调的是 epoch 6 的参数,而不是触发停止时 epoch 9 的参数。
保存最佳参数而不是最后参数
早停包含两个相互独立的动作:判断何时停止,以及记录历史最佳模型。如果只实现前者,训练虽然会在 epoch 9 退出,却可能把已经退化三轮的参数当成最终模型。
在 PyTorch、Keras 等框架中都应围绕同一个验证指标执行“比较 → 保存最佳权重 → 增加等待计数 → 达到 patience 后停止”。若优化目标是最小化 val_loss,比较方向就是更小;若监控准确率、F1 等越大越好的指标,则比较方向必须反过来。
保存时还要明确检查点内容。只做最终推理,保存模型参数通常足够;需要中断后继续训练,则还应同时保存优化器状态、当前 epoch 和学习率调度器状态,否则恢复后动量、Adam 的一二阶矩等内部状态会丢失。
用验证集而不是测试集决定早停
早停参数本身也是模型选择过程的一部分,因此判断依据必须来自验证集,不能每轮查看测试集再决定何时停止。典型数据拆分可以是训练集 80%、验证集 10%、测试集 10%;数据较少时比例可以调整,但测试集应保留到模型与超参数都确定之后再做一次最终评估。
如果同一份验证集被反复用于比较大量模型和超参数,也会逐渐产生对验证集的间接过拟合。实际项目可限制试验次数,或在数据充足时额外保留最终评估集。
最后验收早停配置时,应确认三个结果同时成立:日志中能看到最佳 epoch,停止发生在连续若干轮无改善之后,加载检查点后重新计算验证损失能够回到最佳值附近。只看到训练提前结束,而没有验证最佳参数被恢复,仍然不算完整的早停实现。