
AI 与工程数学 / 系统课时
凸目标为什么更易判断全局最优
凸目标为什么更易判断全局最优
训练模型时,优化算法找到一个梯度为零的点,并不代表损失已经达到全局最低。对于可微凸函数,这个判断却可以成立。本课通过几何直觉、一阶最优性条件和具体损失函数,建立判断全局最优的实用方法,并理解它在 AI 模型训练中的适用边界。
学习目标
- 理解凸函数的几何性质及其与局部最优、全局最优的关系。
- 使用一阶最优性条件判断可微凸目标的全局最优解。
- 识别常见凸损失,并区分损失函数凸性与模型训练目标凸性。
凸函数为什么没有坏的局部最优点
设优化目标为 ,凸函数要求定义域是凸集,并且对任意两点 和 ,满足:
几何上,函数图像上任意两点之间的连线不会落到图像下方。对于单变量函数,可以把它理解为没有向下凹陷的山谷隔断;但严格判断仍应使用上述定义或导数条件。
以 为例,最低点位于 ,函数值为 。无论从左侧还是右侧接近该点,都不会发现另一个更低的谷底。
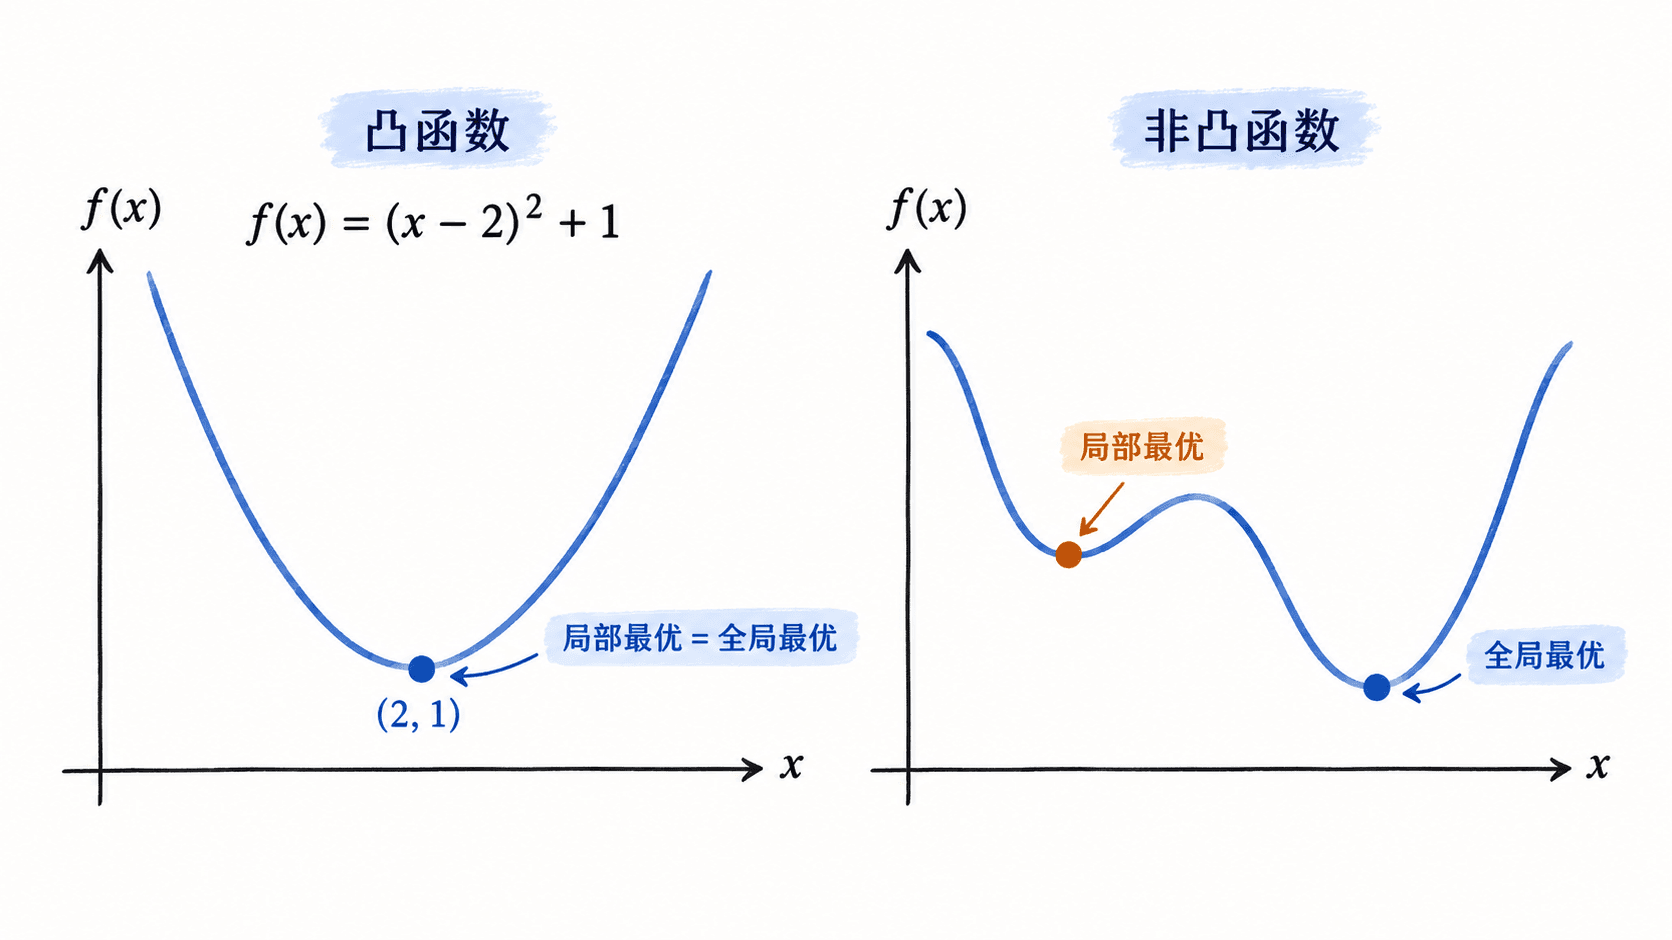
凸函数有一条重要结论:定义在凸集上的凸函数,任何局部最小点都是全局最小点。这里的局部最小指在该点附近的可行区域内,没有其他点具有更小函数值。
但凸性不保证最优解唯一。例如常数函数 在所有点都达到全局最优。即使目标严格凸,也还需要最小值确实能够取到,才能谈论唯一最优解。
一阶最优性条件如何证明全局最优
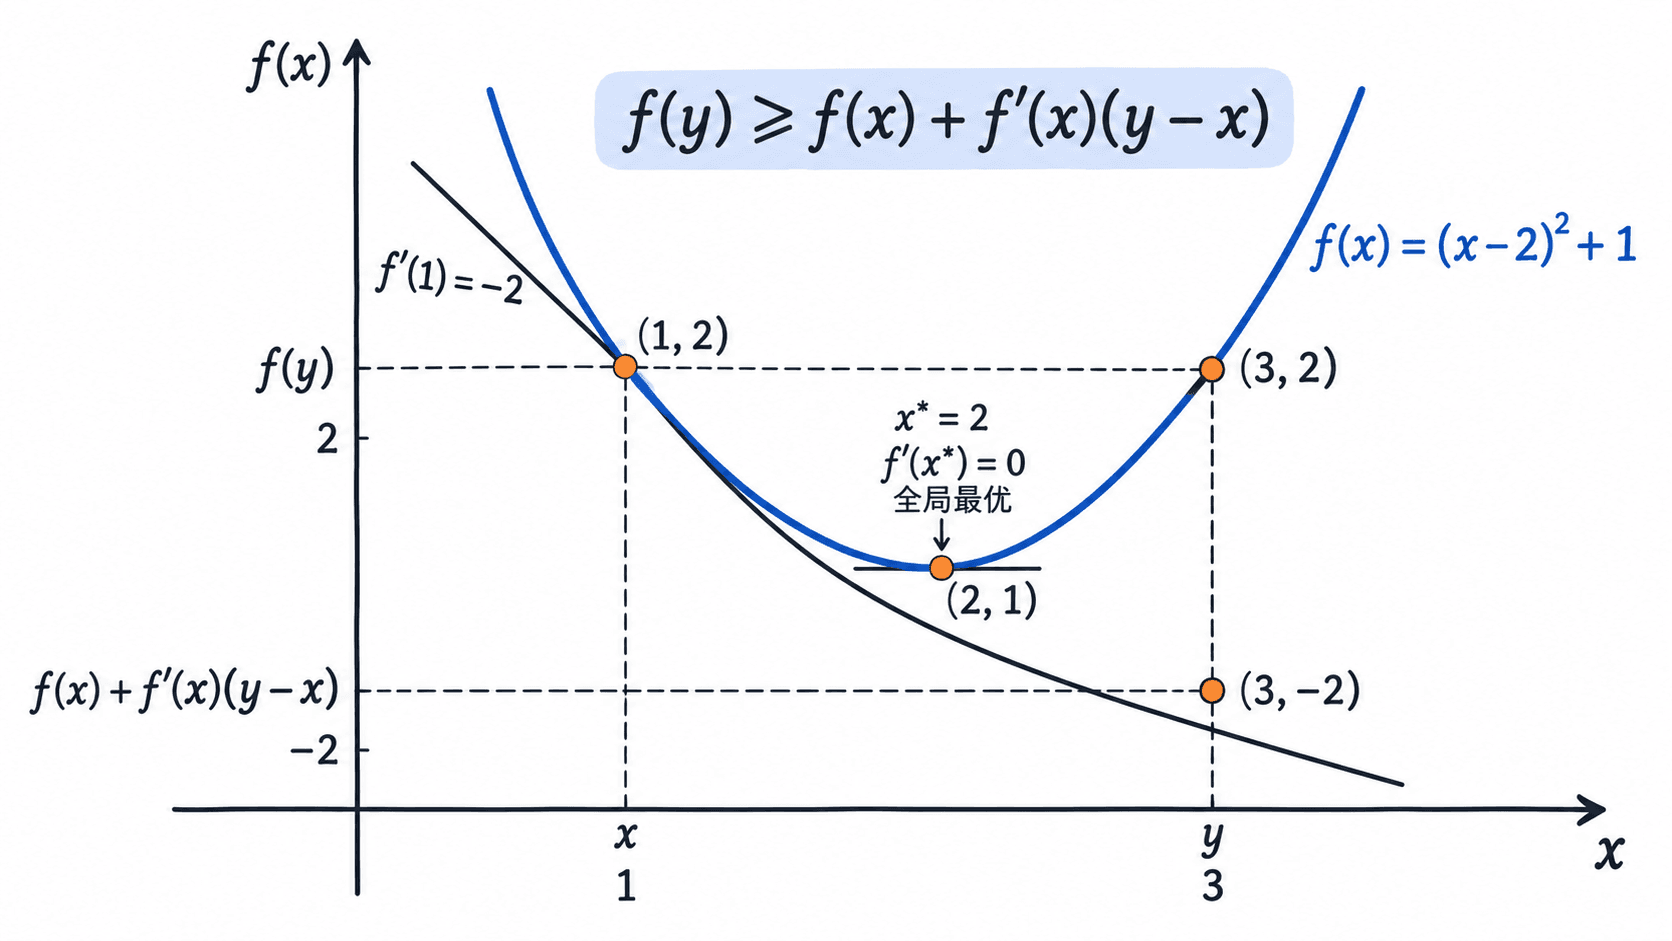
对于定义在开放凸集上的可微凸函数,任意两点 满足一阶支撑不等式:
其中 为梯度。这个公式说明,在点 处作出的切线或切平面始终位于函数图像下方。
如果找到 ,使得 ,则对任意可行点 都有:
因此, 就是全局最优解。这是凸优化容易判断最优性的关键:只需检查一阶条件,而不必逐一比较所有候选点。
以 为例:
令 ,得到 ,代回原式得到 。由于二阶导数 对所有 成立,函数严格凸,因此 是唯一全局最优点。
对于非凸函数,梯度为零只是驻点条件。例如 在 处导数为零,但该点既不是局部最小点,也不是全局最小点。
常见 AI 损失怎样判断凸性
判断凸性必须明确优化变量。机器学习通常优化参数 ,因此要判断完整目标函数关于 是否凸,不能只看损失对预测值是否凸。
| 损失或目标 | 典型表达式 | 凸性判断 |
|---|---|---|
| 平方误差 | 对预测值 凸;线性模型的平方误差和对参数凸 | |
| 绝对误差 | $ | \hat y-y |
| 二分类 Logistic 损失 | , | 对分数 凸;当 时对参数凸 |
| Hinge 损失 | 对分数 凸;在线性分数下对参数凸,但不可处处求导 |
以线性回归为例,预测值为 ,平均平方误差为:
因为每个误差都是参数的仿射函数,平方后的 Hessian 矩阵半正定,所以整体目标凸。若设计矩阵列不满秩,最优参数可能不唯一,但达到的最小损失值相同。
再看神经网络:即使输出层使用平方误差,隐藏层权重经过多层非线性变换后,整体损失通常不再关于全部网络参数凸。不能凭平方误差本身是凸函数,就断言神经网络训练是凸优化问题。
实际检查时,可按以下顺序操作:
- 明确优化变量是预测值、模型分数,还是全部模型参数。
- 检查变量到损失输入的映射是否为仿射映射,或是否满足其他已知的凸性复合规则。
- 对二阶可微目标,检查 Hessian 在凸定义域内是否处处半正定。
- 如果添加正则项,确认正则项凸且系数非负;例如非负系数的 L2 正则不会破坏原有凸性。
用 Python 验证凸二次目标
下面用 NumPy 实现梯度下降,求解前面的凸二次函数。示例适用于 Python 3.10+,需要安装 NumPy,可先执行 python -m pip install numpy。
import numpy as np

# 凸二次函数的梯度为 2x-4,学习率 0.2 小于该问题的稳定上界 1
x = 0.0
learning_rate = 0.2

for _ in range(30):
    gradient = 2 * x - 4
    x -= learning_rate * gradient

# 同时核对目标值和一阶最优性条件
loss = x**2 - 4 * x + 5
print(f"x = {x:.4f}")
print(f"loss = {loss:.4f}")
print(f"gradient = {2 * x - 4:.6f}")
预期输出:
x = 2.0000
loss = 1.0000
gradient = -0.000001
梯度的数值接近零,并不是数学意义上的精确零。程序采用固定步数迭代,随着迭代次数增加,结果逐渐接近解析解 。此例可利用已证明的凸性,将近似驻点解释为接近全局最优。
对于一般凸目标,数值梯度很小只能作为近似最优的线索,还应结合优化容差、可行性和目标值下界判断精度。不能仅凭优化器报告收敛就断言求得精确最优解。
凸优化为什么仍可能训练困难
凸性排除了劣质局部最小点,却不意味着优化过程一定快速。考虑二维二次函数:
它的 Hessian 是对角矩阵 ,两个方向的曲率相差 倍。沿 方向学习率过大容易震荡,沿 方向又可能收敛缓慢。
例如固定学习率 ,沿 方向的更新因子为 ,参数的绝对值会扩大;改用学习率 时,该方向更新因子为 ,但 方向每次仅乘以 ,下降较慢。
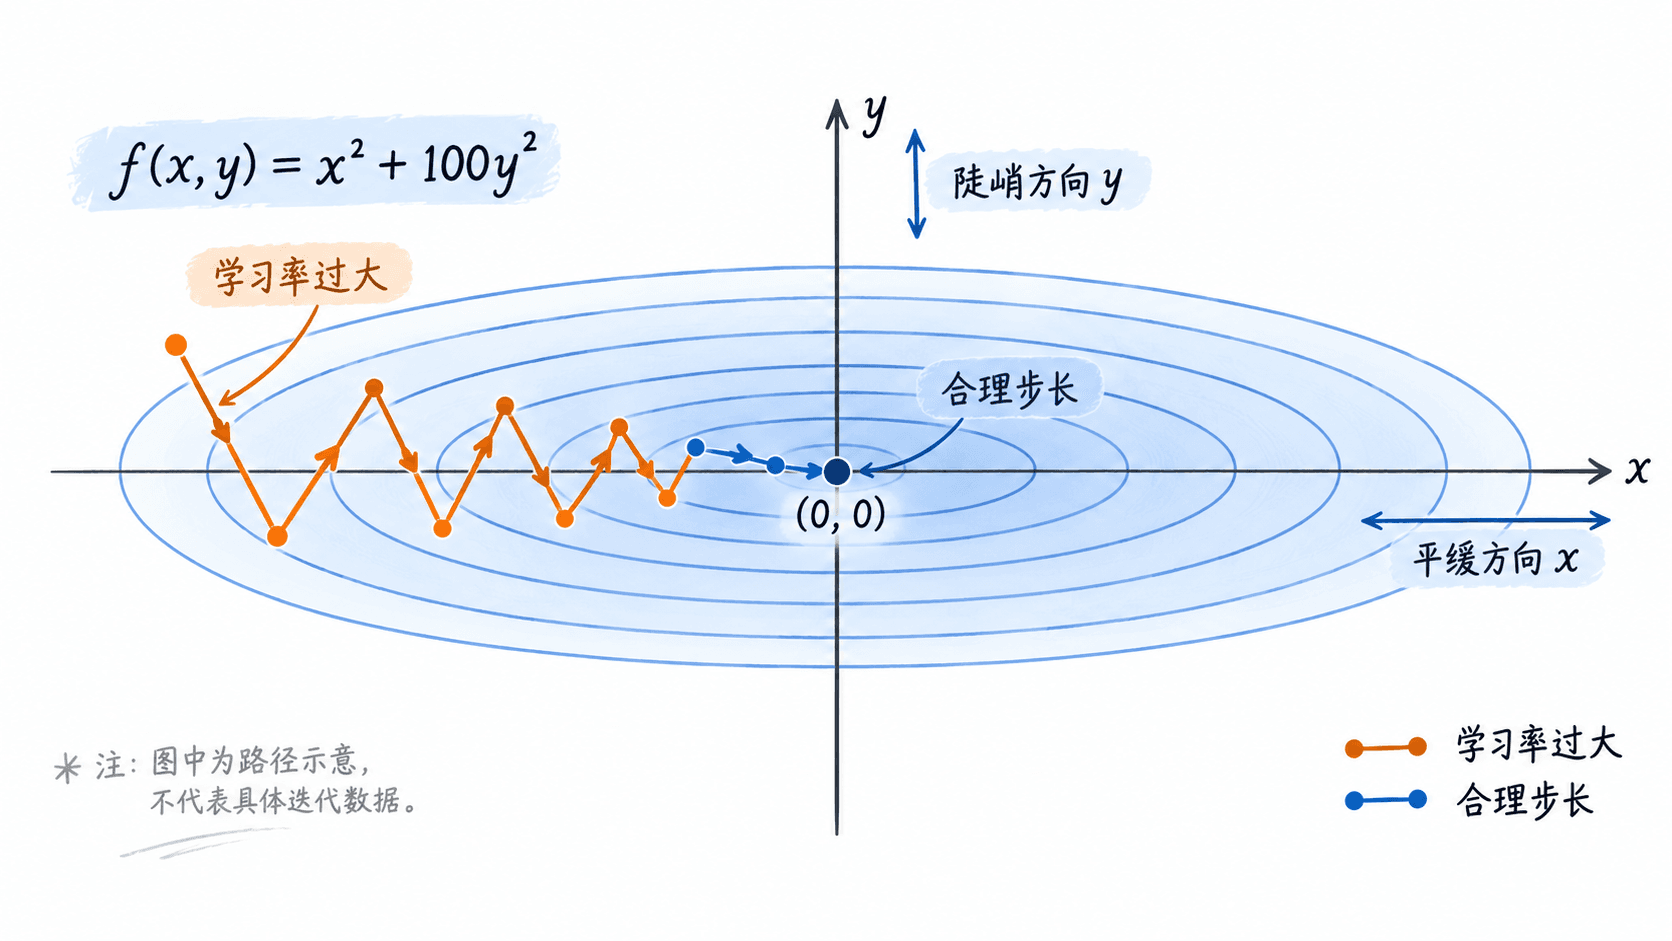
因此,在凸优化中仍需考虑学习率、特征缩放、条件数和停止准则。对于非凸神经网络训练,还要进一步面对鞍点、不同初始化和复杂的参数空间。
面对一个新的训练目标,优先确认其关于模型参数的凸性;若凸且找到满足适当最优性条件的点,就能给出全局最优保证。若只是非凸目标中的梯度接近零,则还需要更多证据判断解的质量。