
AI 与工程数学 / 系统课时
动量法如何减少更新方向震荡
动量法如何减少更新方向震荡
在不同方向曲率相差很大的损失面上,普通 SGD 容易横跨狭长谷底反复摆动,同时沿谷底前进得很慢。动量法把过去若干步的更新方向累积起来,削弱高频反向震荡,并保留长期一致的下降趋势。
学习目标
- 写出 SGD 与 Momentum 的参数更新式,并理解速度变量的作用。
- 在狭长二次函数上比较两种方法的迭代轨迹与震荡次数。
- 根据动量系数和学习率判断常见的过冲与收敛问题。
狭长谷底为什么容易产生之字形路径
考虑二维目标函数:
梯度为 。沿 方向的曲率是沿 方向的 100 倍,因此只要当前位置的 不为 0,梯度在 方向的分量通常会远大于 方向。
普通 SGD 使用
若从 出发并取 ,第一次更新得到 、。下一步 又会被梯度推回正侧,于是轨迹不断横穿谷底;而 每次只缩小约 1.5%,沿谷底方向的推进明显更慢。
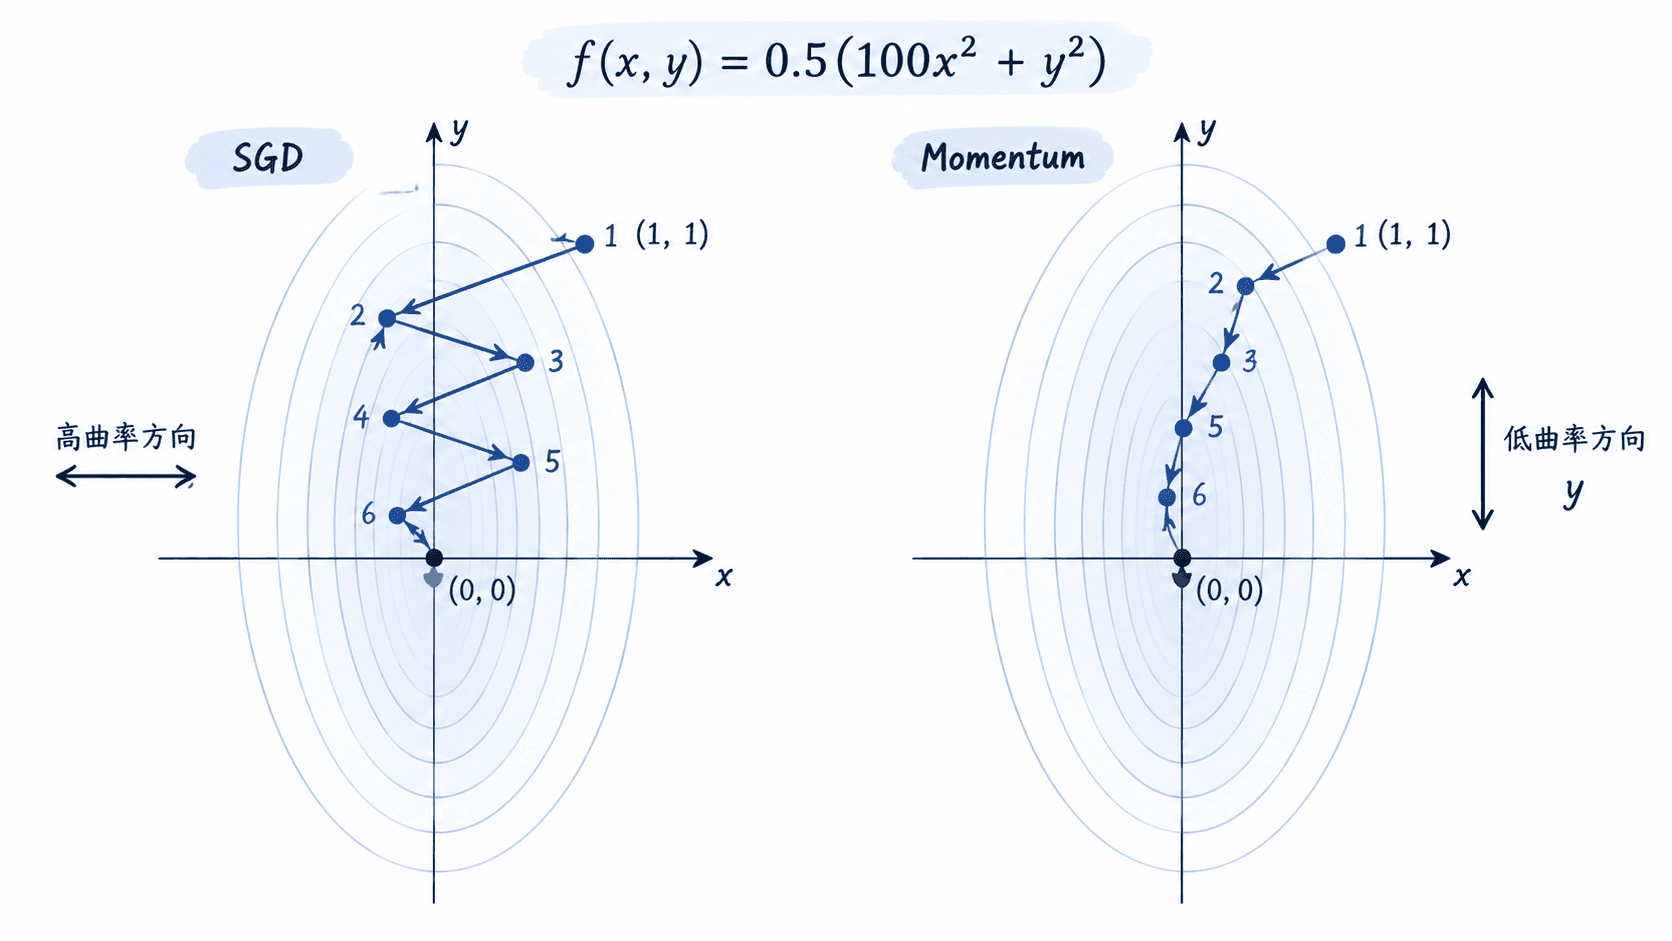
Momentum 用历史速度抵消高频震荡
经典 Heavy-Ball Momentum 为每个参数维护速度 :
其中 是动量系数,常见起点为 0.9。如果某个方向连续多步梯度同号,速度会逐步累积;如果梯度每一步都换号,当前梯度会与先前速度部分抵消。因此在狭长谷底中,横向的快速正负切换被抑制,而沿谷底长期同向的分量得以保留。
例如连续两步某方向梯度分别为 +10、-10,取 、。没有动量时两次位移分别是 -0.10 与 +0.10;使用 Momentum 后,第一步速度为 -0.10,第二步速度变为 0.9×(-0.10)+0.10=0.01,反向位移只剩 +0.01。
用数值实验比较两种路径
下面的 Python 示例不依赖第三方库,在同一个二次函数上运行 100 步。为使两种算法处于各自稳定的步长范围,SGD 使用学习率 0.015,Momentum 使用学习率 0.0015 和动量系数 0.9。程序还统计 方向更新位移发生符号反转的次数,用它近似观察横穿谷底的震荡频率。
def optimize(method, steps=100):
    x, y = 1.0, 1.0
    vx, vy = 0.0, 0.0
    previous_dx = None
    direction_flips = 0

    for _ in range(steps):
        gx, gy = 100.0 * x, y

        if method == "SGD":
            eta = 0.015
            dx, dy = -eta * gx, -eta * gy
        else:
            eta = 0.0015
            beta = 0.9
            vx = beta * vx - eta * gx
            vy = beta * vy - eta * gy
            dx, dy = vx, vy

        # 统计高曲率 x 方向的更新是否再次反向。
        if previous_dx is not None and dx * previous_dx < 0:
            direction_flips += 1
        previous_dx = dx

        x += dx
        y += dy

    loss = 0.5 * (100.0 * x * x + y * y)
    return x, y, loss, direction_flips


for name in ("SGD", "Momentum"):
    x, y, loss, flips = optimize(name)
    print(f"{name}: x={x:.6f}, y={y:.6f}, loss={loss:.6f}, flips={flips}")
预期输出:
SGD: x=0.000000, y=0.220609, loss=0.024334, flips=99
Momentum: x=-0.002343, y=0.204312, loss=0.021146, flips=12
这里 SGD 的 几乎每一步都改变更新方向,共出现 99 次反转;Momentum 只有 12 次。最终损失也略低,但这个结果不能理解为 Momentum 在任意相同学习率下都一定更快,因为两种方法的稳定学习率范围并不相同。
调整动量时重点看过冲和阻尼
beta=0.9 是常用起点,但不是固定答案。较大的 会让历史速度保留更久:在稳定方向上可以加速,在接近最优点时也可能因为惯性继续冲过谷底。若把 从 0.9 提高到 0.99,历史速度的衰减速度会明显变慢,通常需要重新降低学习率。
排查时可以按两个现象判断:如果损失连续增大甚至出现 inf,先把学习率降低 2~10 倍;如果损失总体下降,但最优点附近长期往返且振幅衰减很慢,则同时尝试降低学习率或把动量从 0.9 调到 0.8。反过来,如果轨迹稳定却沿平坦方向推进缓慢,可以在保持损失不发散的前提下逐步提高动量或学习率。
动量真正减少的是更新方向中的高频反转,而不是保证每一步都直接朝最优点移动。判断它是否有效,应同时观察损失曲线、参数轨迹和方向反转,而不是只看最后一次迭代的参数值。