
AI 与工程数学 / 系统课时
用 PyTorch 自动微分核对手算
用 PyTorch 自动微分核对手算
训练模型时,损失值正常下降并不代表梯度计算一定正确。本篇使用同一组线性回归数据,分别通过 NumPy 手写导数和 PyTorch autograd 自动微分求梯度,再逐项比较数值,帮助你验证损失函数、参数更新和计算图是否符合预期。
学习目标
- 推导线性回归均方误差对权重和偏置的梯度。
- 使用 PyTorch autograd 计算梯度,并与 NumPy 结果逐项比较。
- 定位梯度不一致、梯度累积和计算图断开等常见问题。
建立可手算的回归问题
考虑只有一个输入特征的线性模型:
使用三个样本:
| 样本 | ||
|---|---|---|
| 1 | 1 | 2 |
| 2 | 2 | 4 |
| 3 | 3 | 6 |
令初始权重 、偏置 ,预测值为 ,预测误差 为 。
定义损失为所有样本平方误差的平均值:
代入三个样本,可以得到:
这里使用均值而非平方误差总和,也没有额外乘以 。后续两种实现必须保持这个定义一致,否则梯度会相差固定倍数。
推导权重与偏置的梯度
对损失函数分别求 和 的偏导数。应用链式法则得到:
将当前误差 代入,权重梯度为:
偏置梯度为:
因此预期梯度为 、。两个值均为负数,意味着在当前参数位置执行梯度下降时,权重和偏置都会增加。
如果实际计算得到 、,应首先检查是否把 mean 错写成了 sum,因为这组数值恰好相差样本数 3。
使用 NumPy 和 autograd 逐项验证
以下示例适用于安装了 NumPy 2.x 和 PyTorch 2.x 的 Python 3.10 及以上兼容环境。可在终端使用当前环境对应的 Python 解释器安装依赖:
python -m pip install numpy torch预期结果:安装命令成功退出,随后可以使用 import numpy 和 import torch 导入依赖。实际安装日志及下载文件因平台而异。
创建 check_gradient.py,先通过 NumPy 按公式求导,再使用 PyTorch 的 requires_grad=True 建立可微参数,执行 backward() 计算同一损失的梯度。
import numpy as np
import torch

# 使用 float64 减少浮点舍入对梯度比较的影响
x = np.array([1.0, 2.0, 3.0], dtype=np.float64)
y = np.array([2.0, 4.0, 6.0], dtype=np.float64)
w0, b0 = 1.0, 0.0

# NumPy 手写均方误差梯度
error = w0 * x + b0 - y
loss_np = np.mean(error ** 2)
dw_np = 2.0 * np.mean(error * x)
db_np = 2.0 * np.mean(error)

# PyTorch 在相同数据和参数上建立计算图
xt = torch.tensor(x, dtype=torch.float64)
yt = torch.tensor(y, dtype=torch.float64)
w = torch.tensor(w0, dtype=torch.float64, requires_grad=True)
b = torch.tensor(b0, dtype=torch.float64, requires_grad=True)

prediction = w * xt + b
loss = torch.mean((prediction - yt) ** 2)
loss.backward()

dw_torch = w.grad.item()
db_torch = b.grad.item()

print(f"loss numpy={loss_np:.6f}, torch={loss.item():.6f}")
print(f"dw numpy={dw_np:.6f}, torch={dw_torch:.6f}")
print(f"db numpy={db_np:.6f}, torch={db_torch:.6f}")

# 用容差比较,不直接比较浮点数是否完全相等
assert np.isclose(loss_np, loss.item(), rtol=1e-10, atol=1e-12)
assert np.isclose(dw_np, dw_torch, rtol=1e-10, atol=1e-12)
assert np.isclose(db_np, db_torch, rtol=1e-10, atol=1e-12)
print("Gradient check passed")
运行命令:
python check_gradient.py预期输出:
loss numpy=4.666667, torch=4.666667
dw numpy=-9.333333, torch=-9.333333
db numpy=-4.000000, torch=-4.000000
Gradient check passed
最后一行出现说明损失、权重梯度和偏置梯度都通过了容差检查。由于使用的是双精度浮点数,两套实现的结果能够非常接近,但不应把格式化后的小数位相同作为唯一判据。
理解 autograd 如何传递梯度
PyTorch 会记录涉及可求导张量的运算关系。当前示例中,权重和偏置先参与线性预测,预测值再参与误差及平方运算,最后经过求平均得到标量损失。
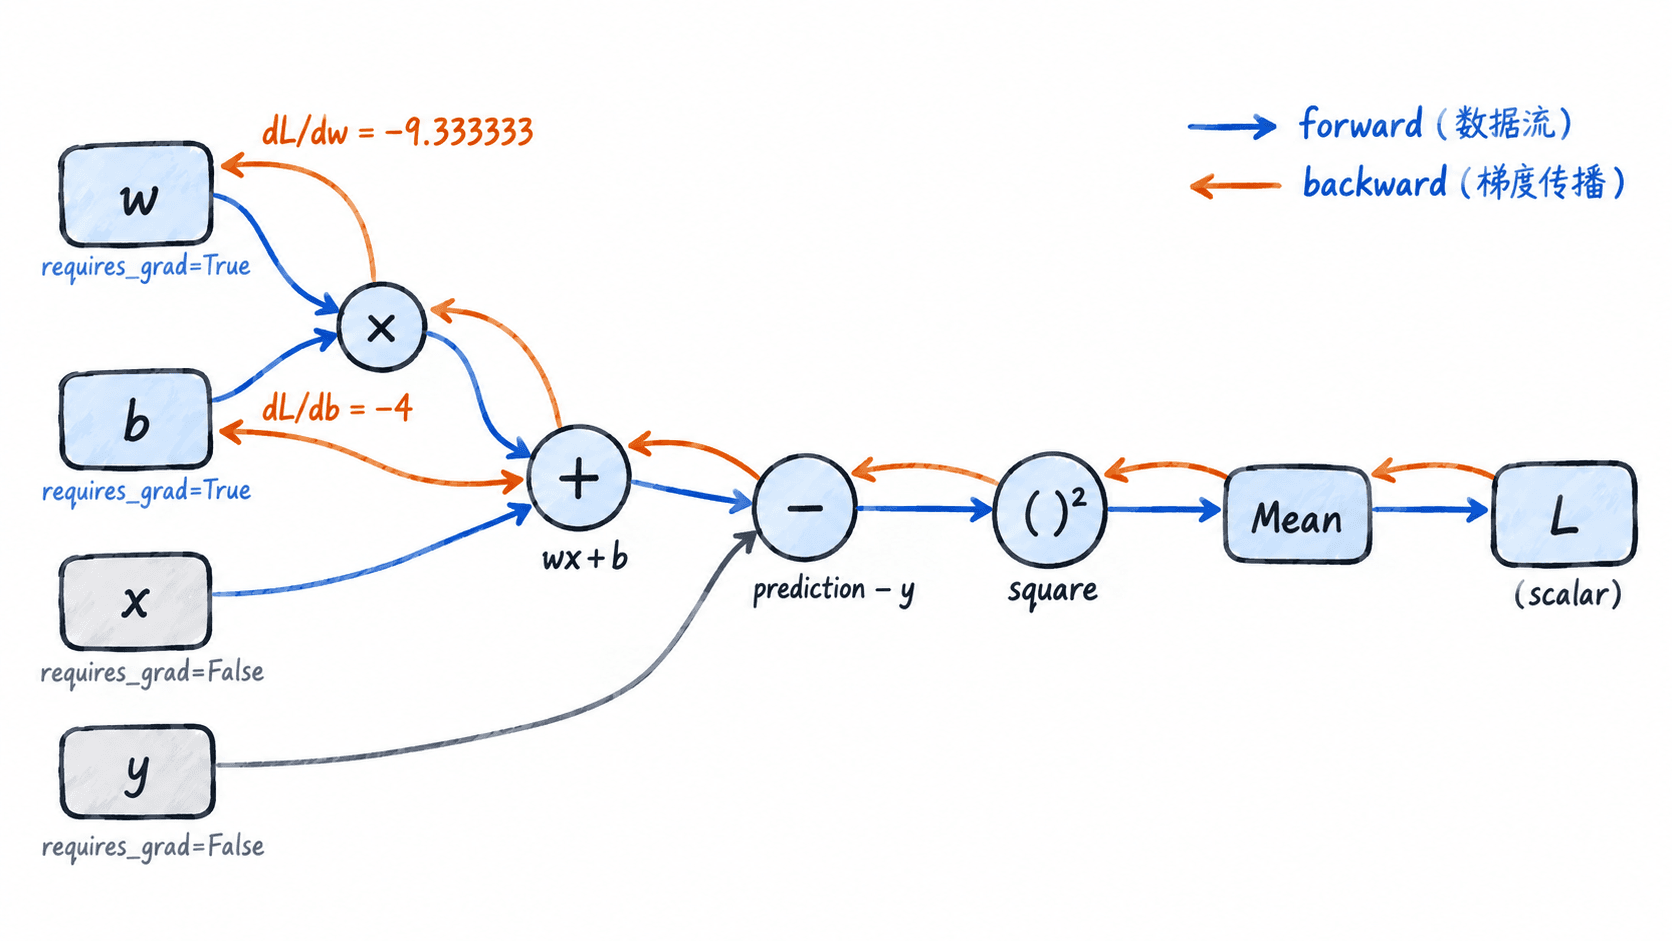
这张图对应三个需要区分的行为:
requires_grad=True使叶子参数参与梯度追踪,并允许其.grad接收梯度。loss.backward()从标量损失开始,按链式法则反向计算梯度。- 梯度累积到叶子张量
w.grad和b.grad,而不是自动修改参数值。
特别注意,调用 backward() 并不会完成梯度下降。实际训练还需要使用优化器,例如 torch.optim.SGD,执行参数更新。
排查梯度不一致的常见原因
当手写梯度与 autograd 不一致时,先比较损失,再比较各参数梯度,最后检查计算图。不要直接调整学习率来掩盖梯度计算错误。
| 现象 | 常见原因 | 检查与修正 |
|---|---|---|
| 梯度相差 3 倍 | sum 和 mean 混用 |
确认是否除以样本数 3 |
| 梯度相差 2 倍 | 损失一侧包含 系数 | 统一损失定义 |
梯度为 None |
张量未参与损失计算或计算图被断开 | 检查 requires_grad、detach() 与数据转换 |
| 第二次梯度翻倍 | 未清除已有梯度 | 每次新一轮反向计算前清零 |
| 小数末位不同 | 浮点精度和运算顺序 | 使用一致的 float64 和合理容差 |
验证梯度累积
PyTorch 的叶子参数梯度默认采用累加行为。以下独立示例重复计算同一个损失,用来观察清零前后的变化:
import torch

w = torch.tensor(1.0, requires_grad=True)

# 每次都创建新的计算图,梯度仍累积到同一叶子参数
for step in range(2):
    loss = (w - 3.0) ** 2
    loss.backward()
    print(f"step={step}, grad={w.grad.item():.1f}")

# 清除已有梯度后重新计算
w.grad = None
loss = (w - 3.0) ** 2
loss.backward()
print(f"after reset, grad={w.grad.item():.1f}")
预期输出:
step=0, grad=-4.0
step=1, grad=-8.0
after reset, grad=-4.0
在标准训练循环中,通常调用 optimizer.zero_grad(),然后执行前向计算、loss.backward() 和 optimizer.step()。如果使用 zero_grad(set_to_none=True),未收到新梯度的参数可能保留 grad=None,这与数值为零的梯度不同。
另外,若在构建损失的过程中对中间张量调用 detach(),或者通过 .item() 把可微张量转换为普通 Python 数值后重新创建张量,原有梯度连接就可能被切断。此时必须回到前向计算的位置恢复可微操作,而不是手动给 .grad 填一个猜测值。
用有限差分增加一道独立检查
NumPy 手写公式与 autograd 一致,能够说明两种实现相符,但仍可能存在双方使用了同一个错误损失定义的问题。对于少量参数,可以增加中心有限差分检查:
选取 。在本例中,直接使用 NumPy 计算扰动前后的损失:
import numpy as np

x = np.array([1.0, 2.0, 3.0], dtype=np.float64)
y = np.array([2.0, 4.0, 6.0], dtype=np.float64)

def loss_fn(w, b):
    return np.mean((w * x + b - y) ** 2)

h = 1e-5
w, b = 1.0, 0.0

# 中心差分分别扰动一个参数,避免参数间相互干扰
dw_fd = (loss_fn(w + h, b) - loss_fn(w - h, b)) / (2 * h)
db_fd = (loss_fn(w, b + h) - loss_fn(w, b - h)) / (2 * h)

print(f"dw finite difference={dw_fd:.6f}")
print(f"db finite difference={db_fd:.6f}")
预期输出:
dw finite difference=-9.333333
db finite difference=-4.000000
有限差分需要额外进行函数计算,适合测试和排障,不应代替大规模模型训练中的反向传播。扰动 太大时截断误差明显,太小时浮点舍入误差会被放大;对于本例的双精度计算, 是合理的验证起点。
实际项目中,建议先用 3~5 个样本、双精度和固定参数检查损失与梯度,再扩展到批量数据。遇到梯度异常时保留一组可复现的输入和预期数值,比直接观察训练曲线更容易定位错误。