
AI 与工程数学 / 系统课时
推导 Adam 优化器的偏差修正
推导 Adam 优化器的偏差修正
Adam 同时维护梯度的一阶矩与二阶矩指数移动平均,但训练刚开始时两者都从 0 初始化,会系统性地偏向 0。本篇从期望值推导修正因子,并用具体梯度完成一次参数更新,验证修正前后数值差异。
学习目标
- 推导 与 两个偏差修正因子的来源。
- 按 Adam 的标准公式计算 、、、 和参数更新量。
- 用可运行 Python 代码核对前两步迭代结果。
为什么刚开始的矩估计会偏小
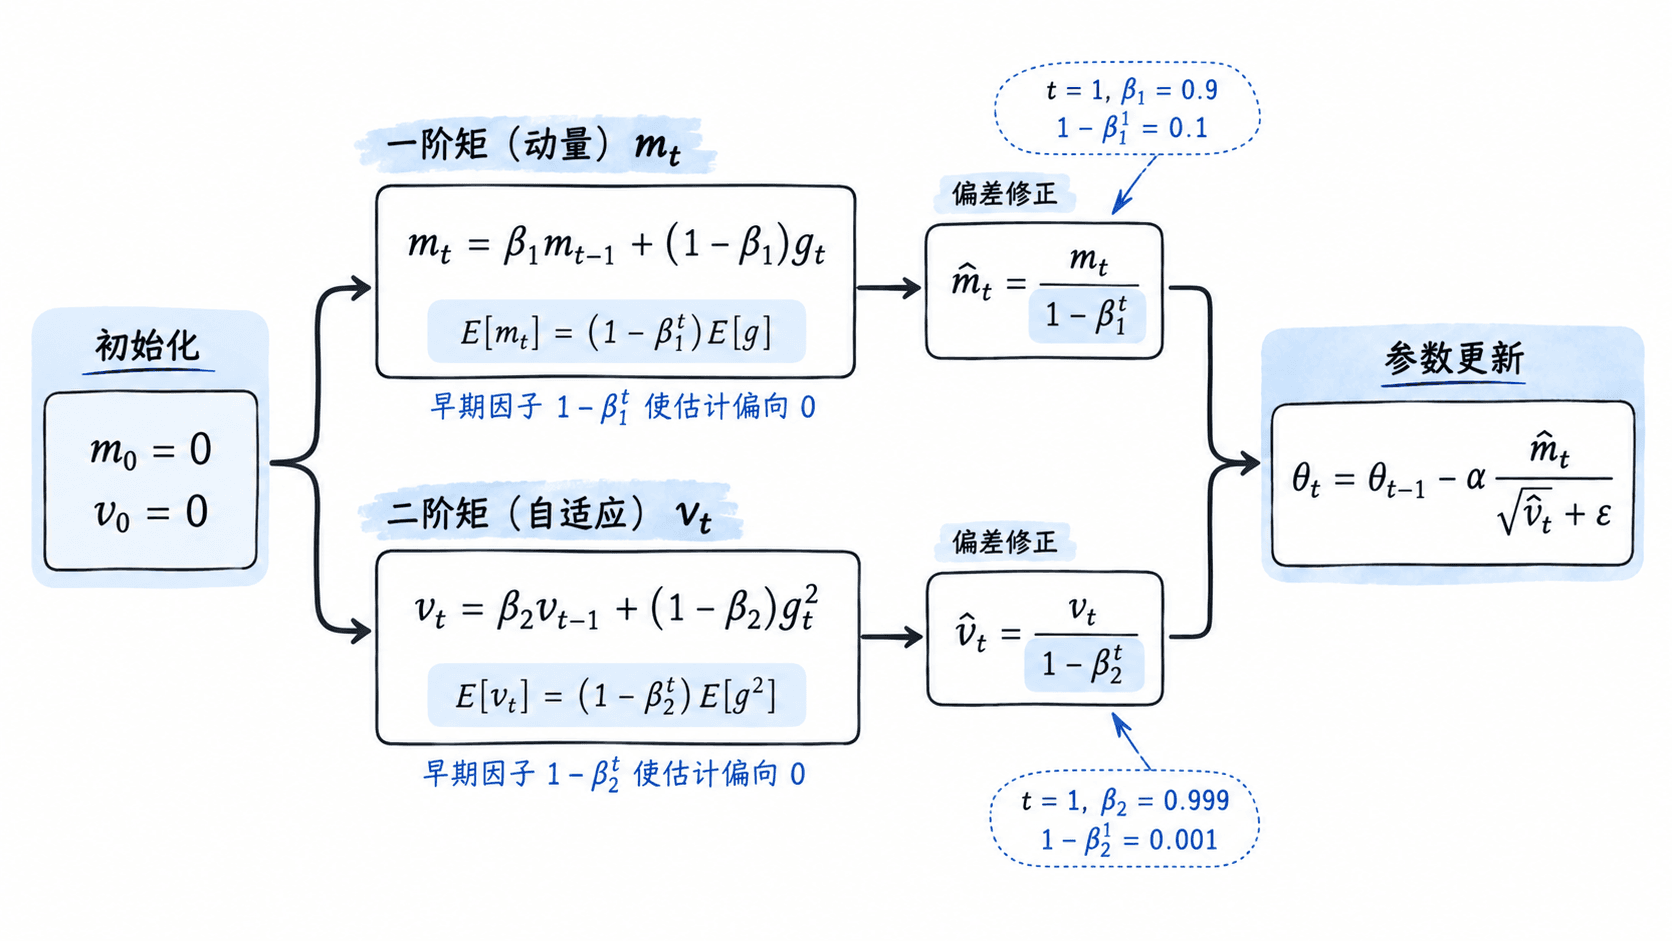
设第 步梯度为 ,Adam 的一阶矩和二阶矩递推为:
标准初始化取 、。假设前几步梯度来自均值近似不变的分布,记 。展开一阶矩可得:
对两边取期望:
因此 并不是直接估计 ,而是少乘了一个接近 0 到 1 之间的系数 。当 且 时,这个系数只有 ,第一步的一阶矩只有真实均值尺度的约十分之一。
二阶矩完全同理。若记 ,则:
当 Adam 常用 时,第 1 步只有 的尺度,未经修正的 会尤其小。
用偏差修正恢复正确尺度
要消除零初始化造成的早期缩小,只需除掉刚才推导出的系数:
然后使用修正后的矩完成 Adam 更新:
取一组常见超参数:、、、。若第 1 步梯度 ,则:
未经修正时, 和 都明显受到零初始化影响。修正后:
它们恰好恢复为当前梯度 及其平方 的尺度。
完成一次 Adam 参数更新
设初始参数 。代入修正后的矩:
因此:
下面的 Python 程序继续加入第二个梯度 ,便于同时检查时间步 是否正确进入修正因子。
import math

beta1 = 0.9
beta2 = 0.999
learning_rate = 0.001
epsilon = 1e-8

theta = 1.5
m = 0.0
v = 0.0
gradients = [0.2, -0.1]

for t, g in enumerate(gradients, start=1):
    # 先更新指数移动平均,再使用当前时间步 t 做偏差修正。
    m = beta1 * m + (1.0 - beta1) * g
    v = beta2 * v + (1.0 - beta2) * g * g

    m_hat = m / (1.0 - beta1 ** t)
    v_hat = v / (1.0 - beta2 ** t)

    step = learning_rate * m_hat / (math.sqrt(v_hat) + epsilon)
    theta -= step

    print(
        f"t={t} m={m:.8f} v={v:.8f} "
        f"m_hat={m_hat:.8f} v_hat={v_hat:.8f} "
        f"step={step:.11f} theta={theta:.11f}"
    )
预期输出:
t=1 m=0.02000000 v=0.00004000 m_hat=0.20000000 v_hat=0.04000000 step=0.00099999995 theta=1.49900000005
t=2 m=0.00800000 v=0.00004996 m_hat=0.04210526 v_hat=0.02499250 step=0.00026633702 theta=1.49873366303
第二步的一阶矩变为 ,但偏差修正后的 ;二阶矩同样从 修正到 。这说明修正不是只在第一步使用,而是每一步都按照当前 重新计算。
容易写错的三个细节
第一个错误是把时间步固定成 1。正确实现中,第一次参数更新使用 ,第二次使用 ,否则 始终不变,后续矩估计会被过度放大。
第二个错误是先修正旧的 、,再加入当前梯度。标准 Adam 的顺序应当是先由 得到 和 ,再计算 与 ,最后更新参数。
第三个错误是把 放进平方根。经典 Adam 写法使用 ;若实现成 ,数值行为并不完全相同。阅读具体框架源码或论文实现时,应核对这一位置而不是只比较超参数名称。
在 很大时, 与 都趋近于 0,修正因子逐渐趋近 1,所以偏差修正主要影响训练早期。它解决的是指数移动平均从零开始造成的初始化偏差,并不意味着 和 是没有统计误差的真实总体矩。