
AI 与工程数学 / 系统课时
非凸目标如何遇到局部极小与鞍点
非凸目标如何遇到局部极小与鞍点
训练神经网络时,损失函数通常不是一个简单的碗形曲面。梯度下降可能进入局部低谷,也可能在梯度接近零的鞍点附近减速。本篇通过可计算的函数、曲面示意图和 Python 实验,区分三种驻点,并理解不同初始位置为何会产生不同的优化结果。
学习目标
- 区分局部极小值、局部极大值和鞍点,理解它们与梯度为零的关系。
- 使用一阶导数和 Hessian 矩阵判断典型非凸函数的驻点性质。
- 运行梯度下降实验,观察初始化与曲率对优化路径的影响。
为什么梯度为零不代表找到最优解
对于可微函数 ,如果某点满足 ,只能说明该点是一阶驻点,不能直接断定它是最小值。
考虑一个非凸函数:
它的一阶导数为:
令导数等于零,得到三个驻点:、 和 。
再计算二阶导数:
代入三个位置,可以明确判断曲率。
| 驻点 | 函数值 | 二阶导数 | 类型 |
|---|---|---|---|
| 局部极小值 | |||
| 局部极大值 | |||
| 局部极小值 |
这里的两个局部极小值也都是全局极小值,因为函数可以写成 ,所以它不可能小于 。
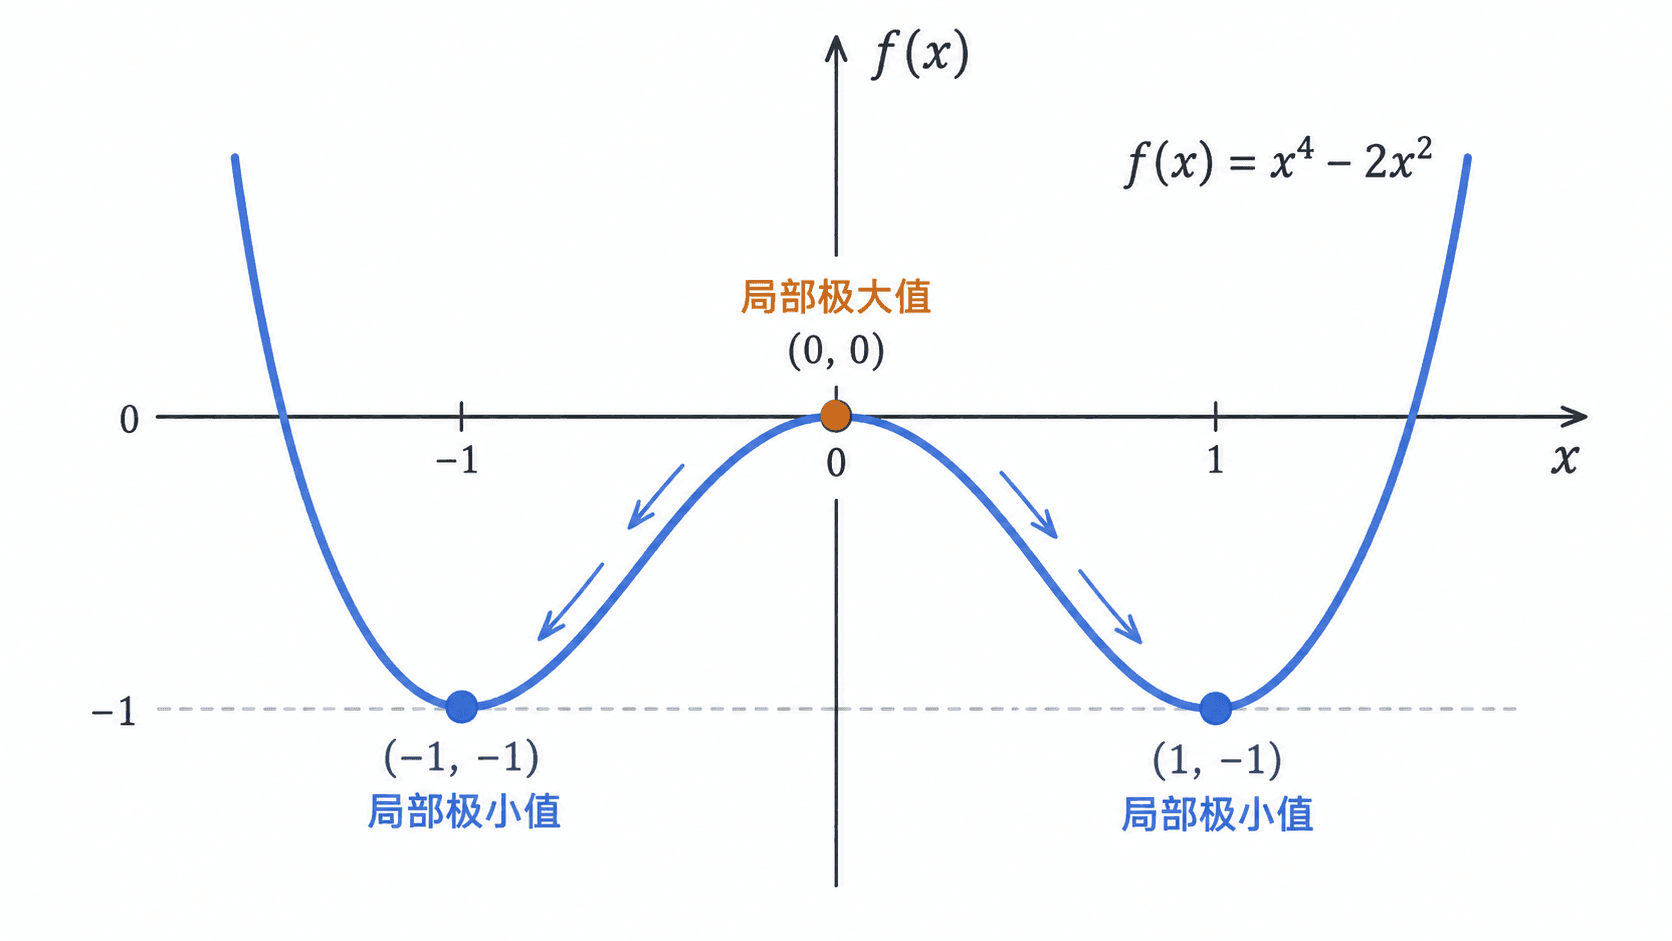
这个例子还说明:非凸不等于所有局部极小值都很差。局部极小值可能恰好也是全局最优,但一般的非凸问题无法仅凭局部导数保证这一点。
局部极小值为什么可能不是全局最小值
局部极小值只要求在某个足够小的邻域内,函数值不低于该点;全局极小值则要求在整个定义域内都找不到更低的值。
例如,考虑一个不对称的双谷函数:
线性项 将左侧谷底压低、右侧谷底抬高。数值求解 ,可以得到以下近似结果。
| 位置 | 函数值(约) | 性质 |
|---|---|---|
| 全局极小值 | ||
| 局部极大值 | ||
| 非全局局部极小值 |
由于函数在 趋向无穷大时趋向正无穷大,比较全部驻点的函数值即可确定全局最低点。
假设采用固定学习率 的梯度下降:
当初始值取 时,迭代通常会进入右侧局部低谷,最终接近 ,而不会自动跨过中间的高点到达更低的左侧谷底。若初始化在左侧吸引区域,则可能收敛至 附近。
鞍点与局部极大值有什么不同
一维函数容易观察峰顶和谷底,但神经网络的参数空间是高维的。一个位置可能沿某个方向呈现谷底,沿另一个方向却呈现山顶,这就是典型的鞍点。
考虑二维函数:
梯度为:
在 处,两个偏导数都为零,因此原点是驻点。但沿不同方向观察,会得到相反结论。
- 固定 ,得到 ,原点是这个方向的最低点。
- 固定 ,得到 ,原点是这个方向的最高点。
所以原点不是局部极小值,也不是局部极大值,而是鞍点。
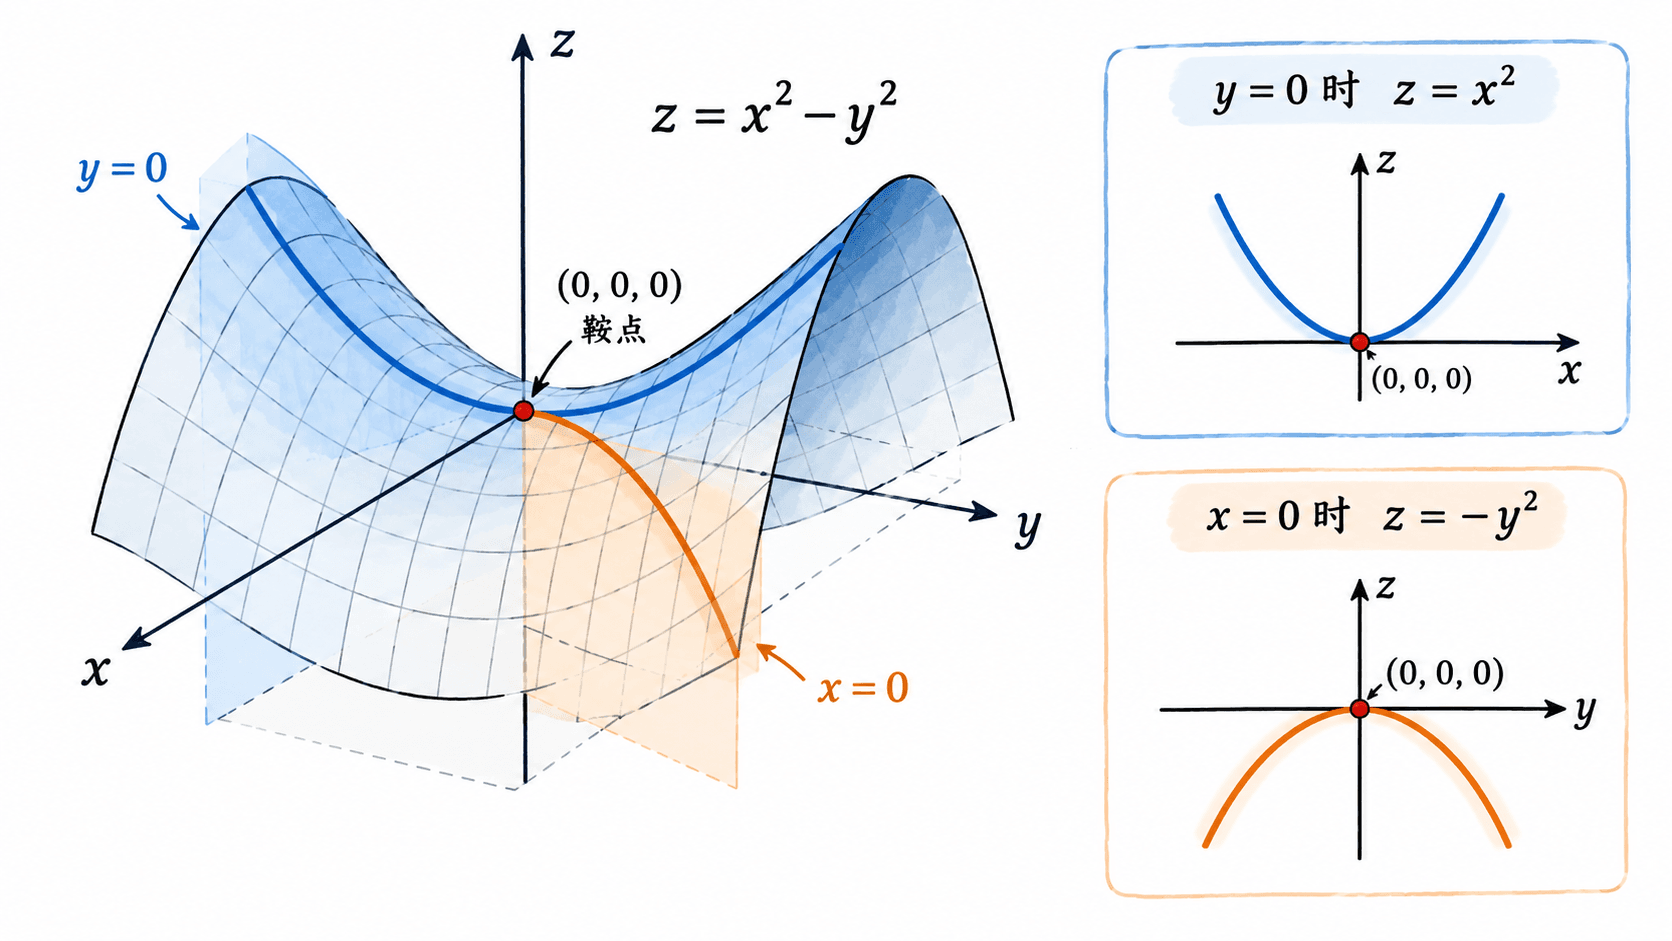
二维函数的二阶信息由 Hessian 矩阵描述。对于这个函数:
其特征值为 和 ,一正一负,表明不同方向的曲率符号相反。
在梯度为零的驻点处,若 Hessian 所有特征值均为正,则是严格局部极小值;全部为负,则是严格局部极大值;同时存在正负特征值,则是鞍点。如果存在零特征值,这些二阶条件可能无法完成分类,需要进一步分析。
用 Python 观察梯度下降的两种行为
下面使用 Python 3.10+ 和 NumPy、Matplotlib 复现不对称双谷及鞍点附近的迭代。先安装依赖:
python -m pip install numpy matplotlib预期结果:命令正常结束,NumPy 和 Matplotlib 可以成功导入;下载进度和安装日志取决于环境,不需要与其他机器一致。
创建 nonconvex_demo.py,运行完整示例:
import numpy as np
import matplotlib.pyplot as plt


def g(x):
    return x**4 - 2 * x**2 + 0.3 * x


def grad_g(x):
    return 4 * x**3 - 4 * x + 0.3


def descend(x0, lr=0.05, steps=200):
    x = x0
    history = [x]
    for _ in range(steps):
        # 每次只根据当前位置的梯度更新
        x -= lr * grad_g(x)
        history.append(x)
    return np.array(history)


fig, axes = plt.subplots(1, 2, figsize=(11, 4))
xs = np.linspace(-1.6, 1.6, 500)
axes[0].plot(xs, g(xs), color="black", label="loss")

for start, color in [(-1.5, "tab:blue"), (1.5, "tab:orange")]:
    path = descend(start)
    axes[0].scatter(path[::10], g(path[::10]), s=13,
                    color=color, label=f"start={start}")
    print(f"start={start:+.1f}, final={path[-1]:+.3f}, "
          f"loss={g(path[-1]):+.3f}")

axes[0].set_title("Asymmetric double well")
axes[0].set_xlabel("x")
axes[0].set_ylabel("loss")
axes[0].legend()

# 鞍点附近:x 方向收缩,y 方向远离原点
x, y, lr = 0.2, 0.02, 0.1
trajectory = [(x, y)]
for _ in range(25):
    x, y = x - lr * 2 * x, y + lr * 2 * y
    trajectory.append((x, y))
trajectory = np.array(trajectory)
axes[1].plot(trajectory[:, 0], trajectory[:, 1], "o-")
axes[1].scatter([0], [0], color="red", label="saddle")
axes[1].set_title("Saddle-point trajectory")
axes[1].set_xlabel("x")
axes[1].set_ylabel("y")
axes[1].legend()

plt.tight_layout()
plt.show()
预期输出:
start=-1.5, final=-1.035, loss=-1.305
start=+1.5, final=+0.960, loss=-0.705
数值按三位小数显示。程序还会弹出包含两幅子图的窗口:左图呈现两个不同初始化对应的低谷,右图呈现迭代点在 方向逐渐接近零、在 方向远离零的轨迹。
右图使用的更新规律为 、。因此,只要初始 不为零,沿负曲率方向的偏移就会增大;如果恰好从原点出发,梯度下降会停在原点。如果初始 ,迭代则可能沿这一特殊方向趋向鞍点。
神经网络训练中该如何应对
非凸损失在神经网络训练中很常见,但不同局部极小值未必都导致糟糕的模型。实际训练更关注验证集指标、收敛速度和结果稳定性,通常不会要求证明找到了全局最优解。
可以使用以下实验方案评估初始化对结果的影响:
- 固定数据集划分、网络结构、优化器和训练轮数,例如 Adam、学习率 、训练 个 epoch。
- 使用 个不同随机种子训练,记录每次的最终训练损失与最佳验证损失。
- 比较验证指标的均值与波动。如果不同种子差异明显,检查初始化、学习率、数据顺序及训练稳定性。
- 当梯度范数很小且损失停滞时,同时观察参数更新、验证损失和局部曲率证据,不能仅凭梯度小就断言遇到了局部极小值或鞍点。
对于局部低谷,可以尝试不同初始化或合理调整优化器;对于鞍点,随机扰动和随机梯度噪声在一定条件下有助于离开负曲率区域,但不保证每次都能成功。若学习率过大导致震荡,则应优先检查更新幅度,而不是把震荡解释成非凸问题本身。
还要区分鞍点与平坦区域:两者都可能出现梯度很小,但平坦区域的 Hessian 特征值可能接近零,收敛缓慢也可能源于病态曲率、梯度尺度或数值精度。判断优化困难时,至少结合损失曲线、梯度范数和多次初始化实验,而不是只看一条训练轨迹。