
AI 与工程数学 / 系统课时
RMSProp 如何调整各参数步长
RMSProp 如何调整各参数步长
RMSProp 会为每个参数单独记录近期梯度平方的指数移动平均,并用它缩放当前梯度。同一个全局学习率下,经常出现大梯度的维度会被压小步长,梯度较小的维度则保留更大的有效步长,从而减少狭长谷底中的来回震荡。
学习目标
- 写出 RMSProp 的平方梯度累积与参数更新公式,并理解每个量的作用。
- 用二维数值例子比较两个参数在相同学习率下得到的不同有效步长。
- 用 Python 跑通一次 RMSProp 更新,核对中间状态与最终参数。
从梯度平方得到逐维缩放因子
设第 步梯度为 ,RMSProp 对每个参数分别维护平方梯度的指数移动平均:
随后按下面的公式更新参数:
其中 是基础学习率, 控制历史平方梯度的保留程度, 用于避免分母为零。常见起点可以取 、、;实际训练仍需结合模型和批量大小调节。
假设两个参数当前梯度分别为 、,初始 ,并取 。第一次更新后:,。若 ,忽略极小的 ,两个参数的更新幅度分别约为 和 。这说明第一次更新时,梯度大小被对应的平方均值同步归一化。
真正体现“自适应”的是后续历史。当某一维长期保持大梯度时,它的 会维持较大,从而持续降低这一维的有效步长;另一维若长期梯度较小,分母也较小,不会被同样程度压缩。
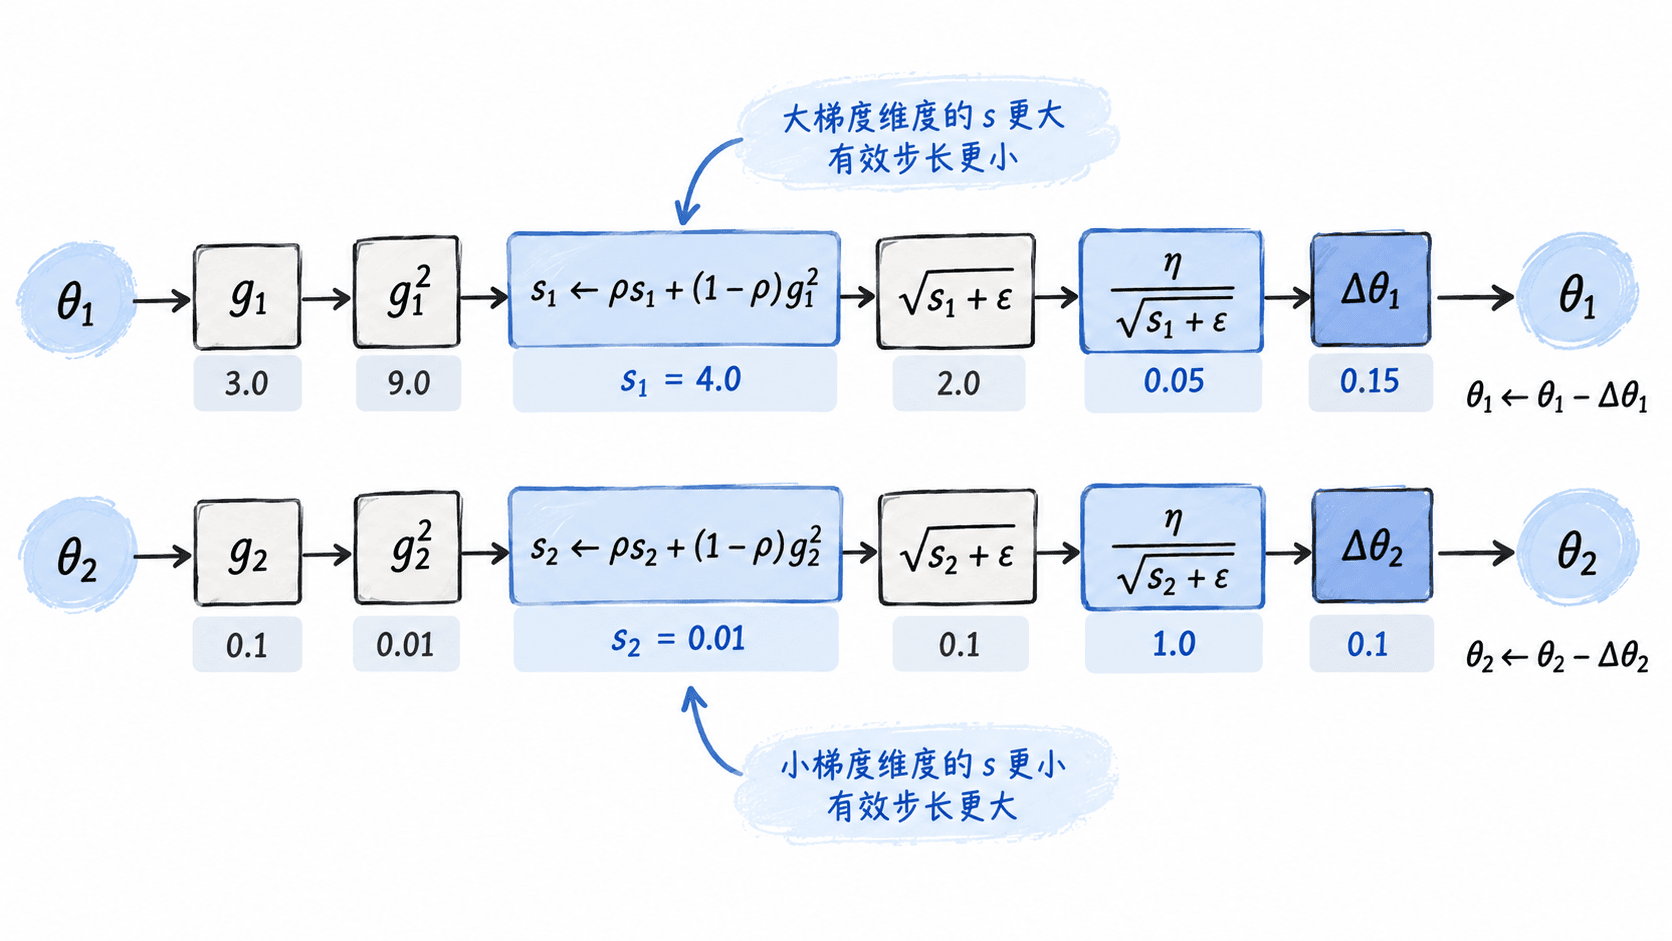
用连续两步看出不同参数的步长差异
考虑两个参数 ,使用 、、。假设第一步梯度为 ,第二步梯度变成 。
第一步后的平方均值为 。第二步继续累积后:
第二步中, 的更新幅度约为 ; 的更新幅度约为 。虽然 RMSProp 会按历史尺度归一化梯度,但更新量并不会被强制变成完全相同;当前梯度与历史平方均值会共同决定结果。
| 维度 | 当前梯度 | 平方均值 | 第二步更新幅度 |
|---|---|---|---|
| 10 | 19.000 | 0.02294 | |
| 0.1 | 0.091 | 0.00331 |
这个例子也说明一个常见误解:RMSProp 不是简单地“让所有参数每次走一样远”,而是根据每个维度近期梯度的尺度调整归一化强度。
用 Python 核对一次 RMSProp 更新
下面不依赖深度学习框架,直接按公式执行两步更新。这样可以同时检查参数值和内部状态 是否符合推导。
import math

rho = 0.9
lr = 0.01
eps = 1e-8

params = [1.0, 1.0]
square_avg = [0.0, 0.0]
grad_steps = [
    [10.0, 1.0],
    [10.0, 0.1],
]

for step, grads in enumerate(grad_steps, start=1):
    for i, grad in enumerate(grads):
        # 每个参数独立累积自己的梯度平方历史。
        square_avg[i] = rho * square_avg[i] + (1.0 - rho) * grad * grad
        update = lr * grad / (math.sqrt(square_avg[i]) + eps)
        params[i] -= update

    print(
        f"step={step} "
        f"s=({square_avg[0]:.6f}, {square_avg[1]:.6f}) "
        f"params=({params[0]:.6f}, {params[1]:.6f})"
    )
预期输出:
step=1 s=(10.000000, 0.100000) params=(0.968377, 0.968377)
step=2 s=(19.000000, 0.091000) params=(0.945435, 0.965063)
第二步后,两个参数虽然使用同一个 lr=0.01,但实际更新量已经不同。检查 RMSProp 实现时,不应只观察原始梯度,还应同时记录对应维度的平方移动平均和最终更新量。
参数设置与常见异常
rho 太小会让算法过度依赖最近几个梯度,缩放因子变化较快;例如从 0.9 降到 0.5 后,旧梯度只保留一半,遇到梯度尺度突然变化时响应更快,但更新也可能更抖。rho 太接近 1 又会让历史状态变化缓慢。
epsilon 主要用于数值稳定,不宜把它误当成学习率。若某个维度的平方均值非常接近零,没有 时除法可能产生极大值甚至数值异常。实践中可从 1e-8 开始;不同框架的默认值可能不同,复现实验时应把该参数一起记录。
当损失面在不同方向上的梯度尺度相差明显时,RMSProp 的逐维归一化通常比固定学习率的普通梯度下降更容易控制震荡;但如果基础学习率本身过大,经过缩放后的更新仍可能不稳定,因此自适应缩放不能替代学习率检查。