
AI 与工程数学 / 系统课时
为什么模型训练是最小化损失
为什么模型训练是最小化损失
训练模型时,我们希望预测值尽可能接近真实值。但计算机无法直接执行“预测得更准确”这样的要求,必须将误差转化为可以计算的数值。本篇使用一个房价预测实验,把预测、损失函数、参数调整和训练目标连接起来,并用 Python 验证损失为什么会下降。
学习目标
- 理解模型参数、预测误差和损失函数之间的关系。
- 能够计算均方误差,并解释为什么训练要寻找损失较小的参数。
- 使用 Python 完成一次参数搜索,验证模型训练的基本目标。
从预测误差到训练目标
假设我们根据房屋面积预测房价。为了简化计算,面积单位设为百平方米,房价单位设为百万元。使用只有一个参数的线性模型:
其中, 是面积, 是预测房价, 是需要学习的模型参数。这个模型暂时不设置截距,目的是让参数变化与预测误差之间的关系更直观。
现有三条训练数据:
| 面积 | 真实房价 | 时的预测 | 预测误差 |
|---|---|---|---|
| 1 | 2 | 2 | 0 |
| 2 | 4 | 4 | 0 |
| 3 | 6 | 6 | 0 |
当 时,三条数据的预测全部正确。如果将参数改为 ,预测值就变成 1、2、3,对应误差为 -1、-2、-3。
这说明预测准确度并非固定属性,而是由模型参数决定的。训练的任务就是利用已知样本,找出一组能够减小预测误差的参数。
为什么不能直接相加预测误差
最直观的做法是把所有预测误差相加,但正负误差可能互相抵消。例如两个样本的误差分别为 -3 和 3,误差总和是 0,预测却都不准确。
一种常用解决方案是均方误差(Mean Squared Error,MSE),先平方每个误差,再求平均:
其中 是样本数量, 是损失函数。对于前面的三条数据,当 时:
当 时,全部预测误差为零,因此 。
平方操作使正负误差不会抵消,也让较大的误差受到更重的惩罚。需要注意,MSE 对异常值比较敏感,因此并不是所有回归任务都必须采用它。
| 参数 | 三个预测值 | MSE |
|---|---|---|
| 0 | 0、0、0 | 18.667 |
| 1 | 1、2、3 | 4.667 |
| 1.5 | 1.5、3、4.5 | 1.167 |
| 2 | 2、4、6 | 0 |
| 3 | 3、6、9 | 4.667 |
从表格可以发现,参数不是越大越好,也不是越小越好。对于这组数据, 恰好使损失达到最小值。
最小化损失究竟在寻找什么
将损失函数看作参数 的函数,训练目标可以写为:
这里的 表示寻找使函数取得最小值的参数,而不是返回损失值本身。对于当前数据:
因为平方项不可能小于零,所以最优参数是 ,最小损失是 0。
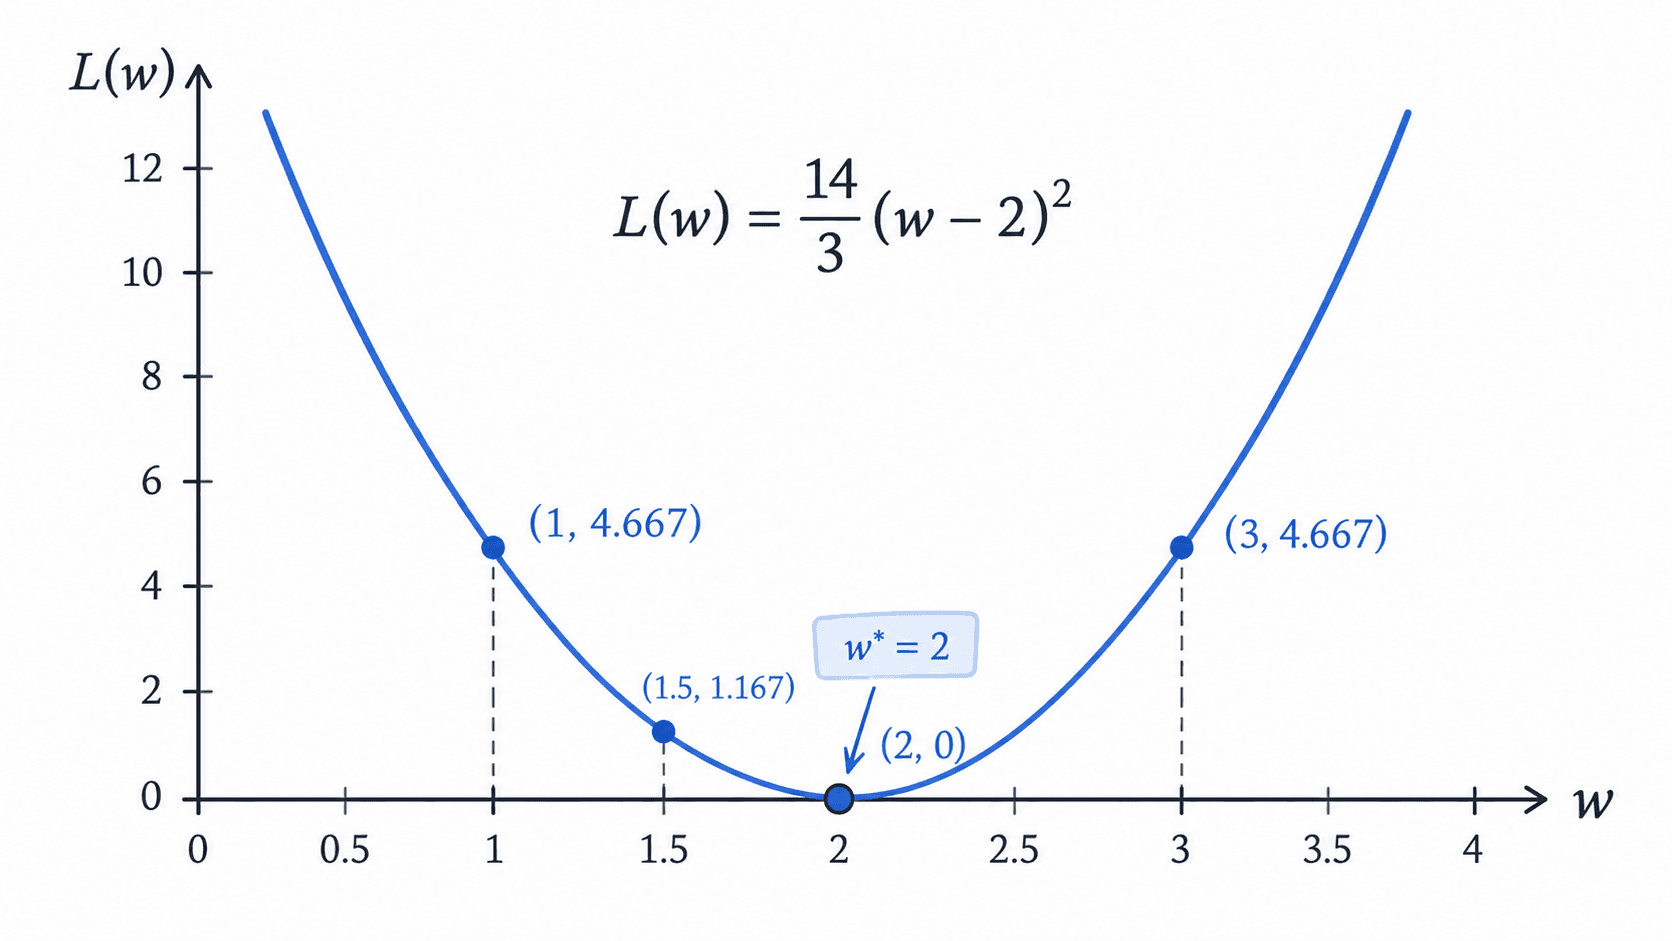
图中的最低点就是当前训练集和当前模型结构下的最优解。实际 AI 模型通常有成千上万甚至更多参数,无法像单参数模型一样画出完整损失曲线,但目标仍然是寻找能降低损失的参数组合。
使用 Python 找到损失最小的参数
下面使用 Python 3 和 NumPy 演示一个最简单的数值实验。不使用自动求导,也不使用机器学习框架,而是在候选参数中逐个计算 MSE,选出损失最小的参数。
先安装依赖:
python -m pip install numpy预期结果:命令成功结束,NumPy 可被 Python 导入;安装日志中的版本和下载信息因环境而异。
创建 train.py,输入完整代码:
import numpy as np

# 三个已知样本,面积和房价采用简化后的单位
x = np.array([1.0, 2.0, 3.0])
y = np.array([2.0, 4.0, 6.0])


def mse(w):
    predictions = w * x
    return float(np.mean((predictions - y) ** 2))


# 在指定范围内搜索候选参数,步长为 0.5
candidates = np.arange(0.0, 3.5, 0.5)
for w in candidates:
    print(f"w={w:.1f}, loss={mse(w):.3f}")

best_w = min(candidates, key=mse)
print(f"best_w={best_w:.1f}, min_loss={mse(best_w):.3f}")
运行:
python train.py预期输出:
w=0.0, loss=18.667
w=0.5, loss=10.500
w=1.0, loss=4.667
w=1.5, loss=1.167
w=2.0, loss=0.000
w=2.5, loss=1.167
w=3.0, loss=4.667
best_w=2.0, min_loss=0.000
观察结果可以发现,从 到 ,损失持续下降;继续增大参数,损失又开始上升。最终程序找到的最佳候选参数为 2.0,与数学推导一致。
这种逐个尝试候选参数的方法叫网格搜索。它适合演示低维问题,但参数数量增加后,候选组合会迅速膨胀。实际神经网络训练通常使用梯度下降及其变体,根据损失对参数的变化趋势逐步更新,而不是枚举所有参数组合。
损失下降为什么不等于训练完成
当前实验的训练数据恰好满足 ,模型结构也与数据关系完全一致,因此能够获得零损失。真实项目通常存在测量噪声、标签错误和模型表达能力限制,损失未必能降到零。
判断训练是否有效,至少区分以下三个量:
| 指标 | 用途 | 需要警惕的现象 |
|---|---|---|
| 训练损失 | 衡量模型对训练样本的拟合程度 | 持续很高,可能欠拟合 |
| 验证损失 | 辅助选择模型和训练配置 | 训练损失下降而验证损失上升,可能过拟合 |
| 测试集指标 | 最终评估未参与训练与模型选择的数据 | 与验证表现差距过大,需要检查数据分布或评估流程 |
例如,某个模型训练 MSE 从 1.20 降到 0.10,但验证 MSE 从 0.30 升到 0.80,这并不能证明模型整体更好。通常应保留验证表现较好的模型,并检查是否存在过拟合或数据划分问题。
还要注意:最小化目标必须与任务匹配。房价等连续数值预测可以使用 MSE;分类任务经常采用交叉熵损失;部分训练目标还包含正则化项,用来约束模型复杂度。
可以把实验中的 y 修改为 [2.0, 4.0, 7.0] 再运行,观察最佳参数和最小损失如何变化。此时三个样本不再完全满足 ,候选参数中的最小 MSE 将不再是零。
模型训练能够表示为最优化问题,是因为我们把预测质量转化成了可计算的损失,再通过调整参数寻找更小的损失值。损失函数负责定义什么叫预测得好,优化算法负责寻找相应的参数;两者共同构成了 AI 模型训练的基础。