
AI 与工程数学 / 系统课时
用导数判断损失变化方向
用导数判断损失变化方向
训练模型时,调整参数不一定会让损失下降。想知道参数应该增大还是减小,可以先观察损失函数在当前位置的变化趋势。本篇从差商极限推导导数的含义,再用具体数值验证导数符号与损失下降方向的关系,最后说明为什么导数不能保证每一步都下降。
学习目标
- 理解差商极限、导数与切线斜率之间的关系。
- 根据导数正负判断参数的局部下降方向,并完成数值验证。
- 识别导数为零、学习率过大和不可导点等边界情况。
从差商理解损失变化
假设模型只有一个待优化参数 ,损失函数为:
这个函数在 时取得最小值 。现在参数位于 ,对应损失为 。我们需要判断:下一步把 调大还是调小?
先让参数变化一个非零的微小量 。损失的平均变化率称为差商:
在 处试算,可以得到:
| 参数变化 | 新损失 | 差商 |
|---|---|---|
注意 为负时,分子也为负,所以差商仍然为正。表中差商逐渐接近 ,说明当前位置的损失随参数增大而上升,随参数减小而下降。
当 趋近零,差商存在有限极限时,这个极限就是导数:
导数描述的是当前位置的瞬时变化率,不是两个相距较远的参数位置之间的平均变化率。
用切线斜率判断下降方向
对于上面的二次损失函数,展开差商:
让 趋近零,得到:
导数在几何上等于损失曲线对应位置的切线斜率。正负号告诉我们曲线在当前位置向哪个方向倾斜。
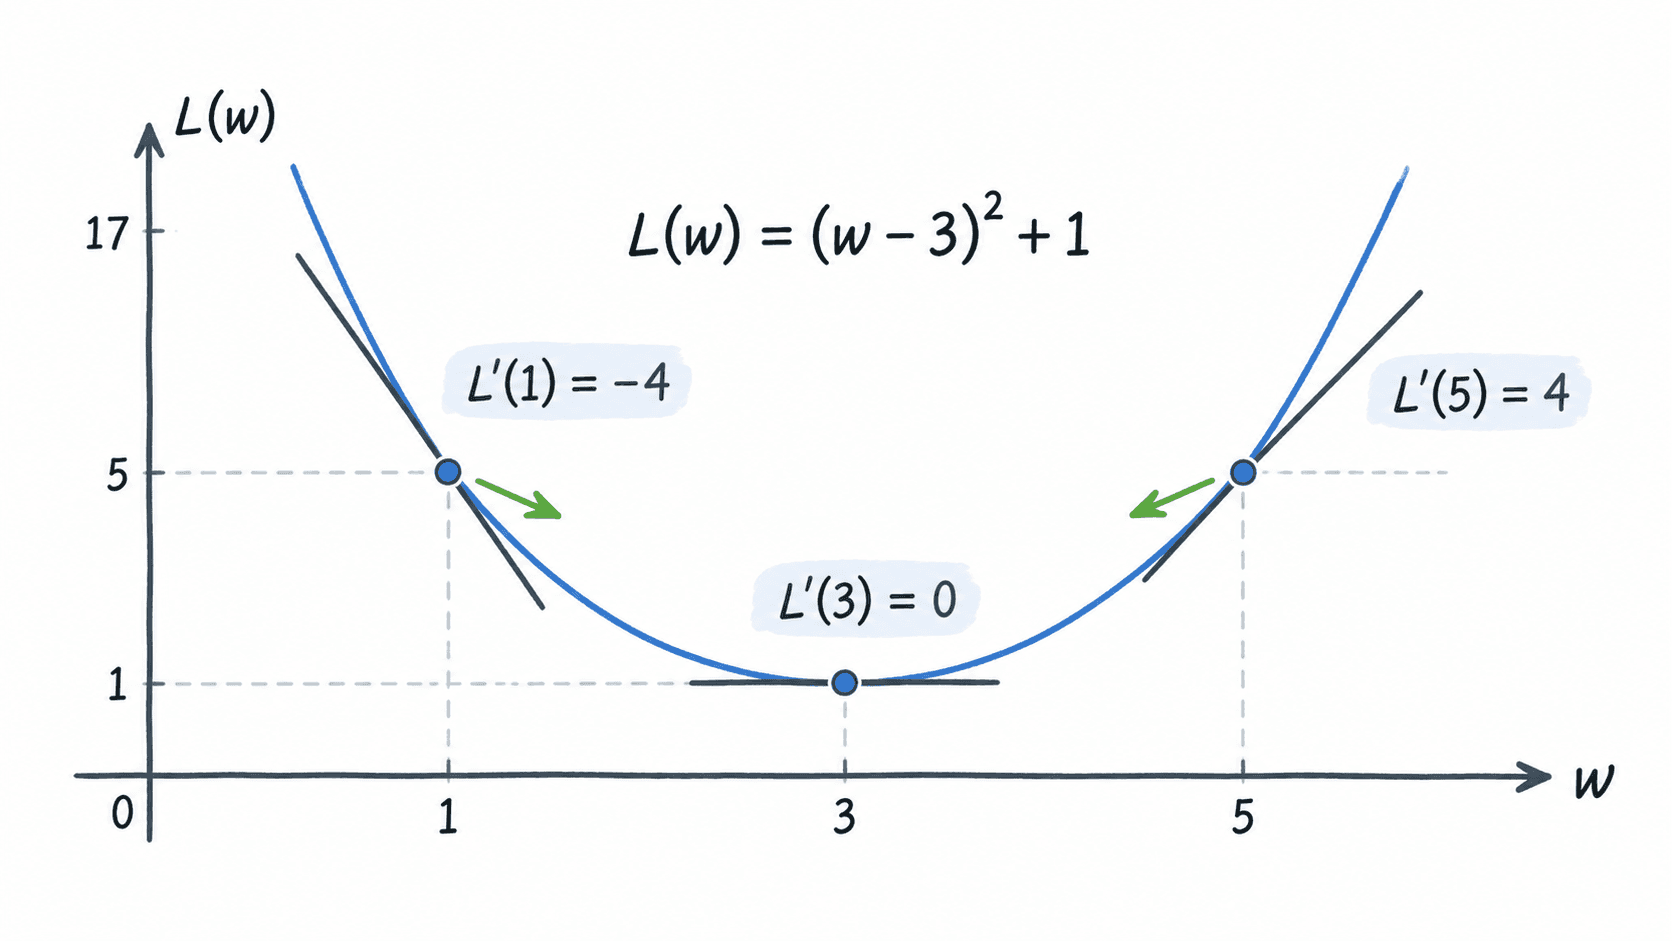
在三个位置代入导数公式:
| 当前位置 | 导数 | 局部下降方向 |
|---|---|---|
| 增大 ,向右移动 | ||
| 一阶导数无法给出下降方向 | ||
| 减小 ,向左移动 |
因此,对于一元可导损失函数:
- :参数向负方向移动足够小的距离,损失会下降。
- :参数向正方向移动足够小的距离,损失会下降。
- :当前位置是驻点,需要进一步判断它是极小值、极大值还是其他驻点。
这里的方向判断是局部结论。导数的绝对值反映瞬时变化率的大小,但不直接决定应该移动多远。
用数值计算核对导数
解析求导得到 。为了检查推导是否正确,可以使用中心差分数值近似:
中心差分同时利用左右两侧的函数值。对于足够光滑的函数,合适的 通常可以获得比同等步长的单侧差分更好的精度。
下面使用 Python 3 标准库即可运行,不需要安装第三方依赖。
def loss(w):
    return (w - 3.0) ** 2 + 1.0


def derivative(w):
    return 2.0 * (w - 3.0)


def numerical_derivative(w, h=1e-4):
    # 使用左右两个采样点估计局部斜率
    return (loss(w + h) - loss(w - h)) / (2.0 * h)


for w in (1.0, 3.0, 5.0):
    analytical = derivative(w)
    numerical = numerical_derivative(w)
    # 比较解析导数和数值近似的误差
    error = abs(analytical - numerical)
    print(f"w={w:.1f}, 解析={analytical:.4f}, 数值={numerical:.4f}, 误差小于1e-8={error < 1e-8}")
预期输出:
w=1.0, 解析=-4.0000, 数值=-4.0000, 误差小于1e-8=True
w=3.0, 解析=0.0000, 数值=0.0000, 误差小于1e-8=True
w=5.0, 解析=4.0000, 数值=4.0000, 误差小于1e-8=True
对于这个二次函数,中心差分在精确算术下恰好等于解析导数;实际浮点计算仍有微小舍入误差。其他函数通常存在截断误差,步长过小还会放大浮点消减误差,因此不能认为 越小越好。
把导数转化成参数更新
知道下降方向以后,可以使用梯度下降更新参数:
其中 是学习率,控制单次移动距离。负号保证更新沿导数所指上升方向的反方向移动。
假设 、学习率 ,因为 ,所以:
更新后的损失为 ,相比原来的 ,下降了 。
但学习率过大可能跨过最低点,甚至让损失上升。仍然从 出发:
| 学习率 | 更新后参数 | 更新后损失 | 结果 |
|---|---|---|---|
| 下降 | |||
| 到达最低点 | |||
| 没有下降 | |||
| 损失上升 |
对本例,可以直接推导更新误差:
只要初始 ,在 时,单步损失严格下降;当 时损失不变;当 时损失上升。这一范围仅针对当前二次函数,不能照搬到任意模型。
导数符号不能解决的情况
导数给出的方向有明确使用条件,下面三种情况需要单独处理。
导数为零不代表一定最优。 对 ,在 处导数也为零,但该点是极大值。对于多参数模型,梯度为零还可能对应鞍点。
函数不可导时不能强行套用普通导数。 例如 在 处左右导数分别为 和 ,普通导数不存在。某些优化方法可以利用次梯度处理此类函数,但不能把不存在的导数写成确定的普通导数。
多个参数需要同时考虑。 当损失为 时,分别计算偏导数,并组成梯度 。在梯度非零且函数可微的条件下,负梯度方向是局部最速下降方向(使用通常的欧氏距离衡量移动长度)。
可以用一个小练习检查理解:对于 ,从 出发,导数为 。若学习率为 ,更新到 ,损失从 降为 。这说明导数正号提供了向左下降的局部方向,而实际下降幅度还取决于学习率。