
AI 与工程数学 / 系统课时
把样本误差写成均方损失
把样本误差写成均方损失
训练模型时,需要把每个样本的预测误差汇总成一个可以比较的数值。本课使用三组输入输出样本,建立线性预测模型,手动计算均方误差,再用 Python 验证不同参数对应的损失值,最终得到一个可以直接用于优化实验的损失函数。
学习目标
- 理解预测误差、平方误差和均方误差的计算关系。
- 根据样本数据构造均方损失函数,并手动计算损失值。
- 使用 Python 比较不同模型参数的损失,判断参数调整是否改善预测效果。
从三组样本建立预测问题
假设我们要根据输入 预测输出 ,已有三组训练样本:
| 样本 | 输入 | 真实输出 |
|---|---|---|
| A | 1 | 2 |
| B | 2 | 4 |
| C | 3 | 6 |
选择最简单的线性模型:
其中, 是预测值, 是斜率, 是截距。训练的任务是寻找合适的 和 ,让预测值尽量接近真实值。
先固定 ,只调整 。当 时,三个预测值分别为 1、2、3;当 时,预测值分别为 2、4、6,恰好与样本匹配。
为了让计算机能够评价参数好坏,需要把这种预测差异转换为损失值。
把预测误差转换为均方损失
对于第 个样本,预测误差定义为:
直接对误差求平均存在问题:例如两个样本的误差分别为 -2 和 2,平均误差为 0,但两个预测实际上都不准确。
均方误差(Mean Squared Error,MSE)先对每个误差平方,再求平均:
这里 是样本数量, 是损失函数。平方让正负误差都产生非负惩罚,同时使较大的误差受到更明显的惩罚。
以 、 为例:
| 样本 | 预测值 | 误差 | 平方误差 |
|---|---|---|---|
| A | 1 | -1 | 1 |
| B | 2 | -2 | 4 |
| C | 3 | -3 | 9 |
因此:
这个数值就是当前参数在全部三组样本上的平均平方误差。它不是准确率,也不是平均绝对误差;原始输出采用什么单位,MSE 就采用该单位的平方。
比较参数变化带来的损失
继续保持 ,让 从 0 增加到 3。因为三个样本满足 ,损失函数可以化简为:
选取五个参数值,计算结果如下:
| 预测值 A、B、C | MSE | |
|---|---|---|
| 0 | 0、0、0 | 18.6667 |
| 1 | 1、2、3 | 4.6667 |
| 1.5 | 1.5、3、4.5 | 1.1667 |
| 2 | 2、4、6 | 0 |
| 3 | 3、6、9 | 4.6667 |
可以看到,参数从 0 向 2 靠近时,损失逐渐减小;超过 2 后,损失又开始增大。因此,不能简单地认为参数越大越好。
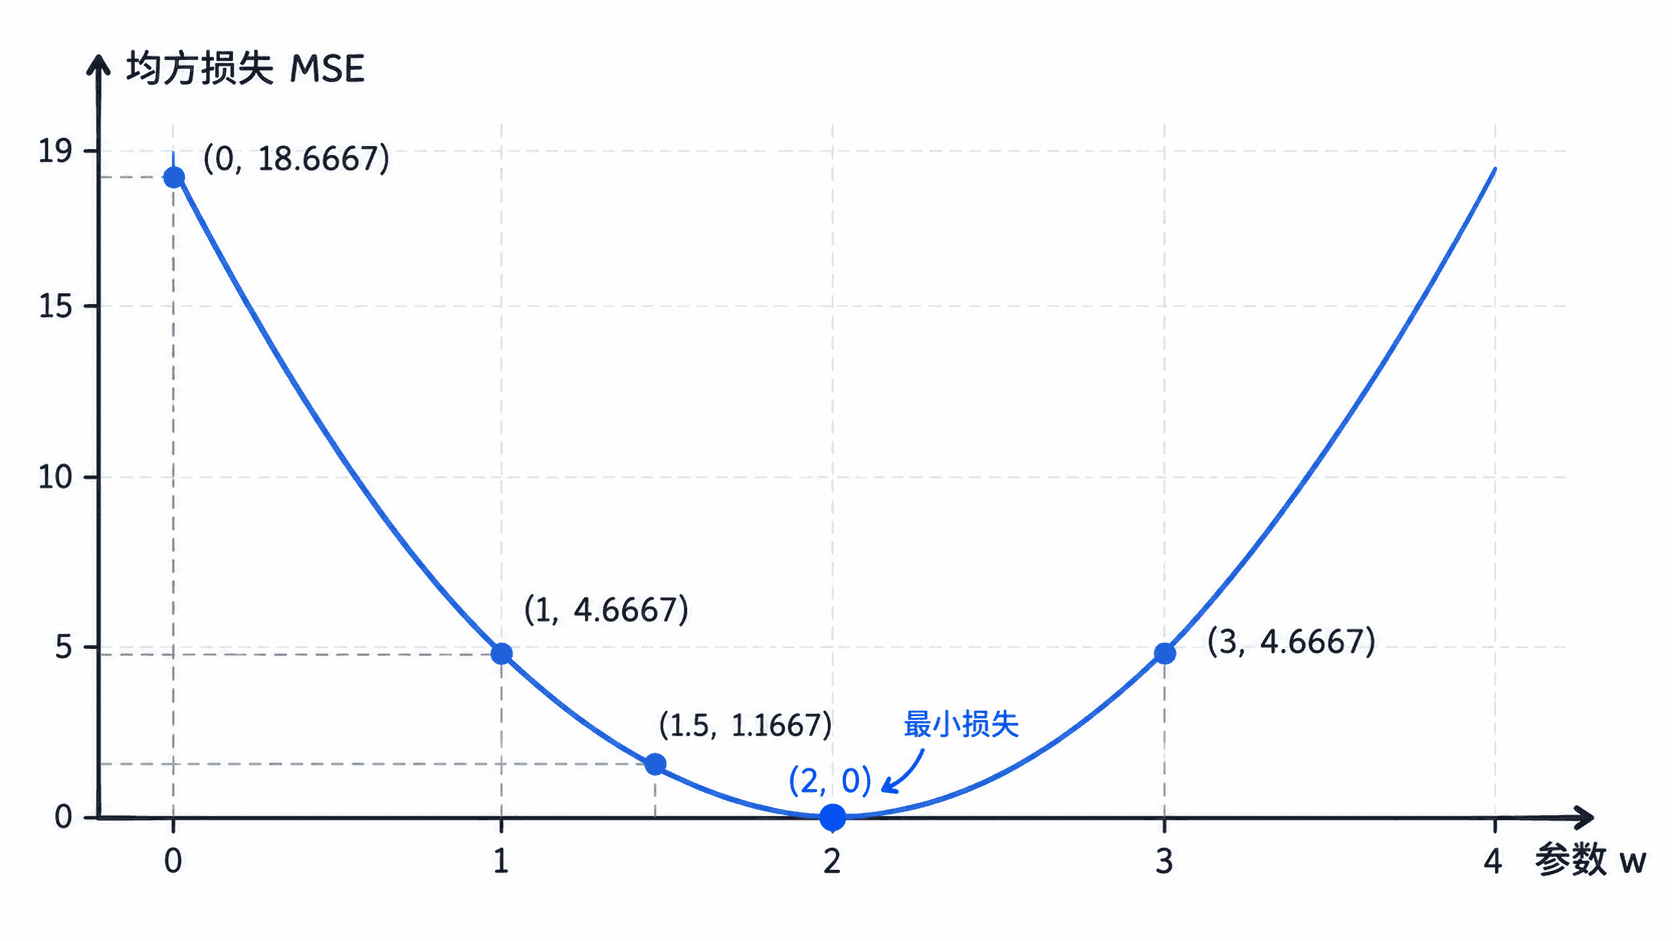
图中的最低点是 。对于这组人为构造的数据,模型可以完全拟合,因此最小训练损失为 0。实际数据受到噪声和模型表达能力限制时,最小损失通常不等于 0。
使用 Python 计算和验证 MSE
下面使用 Python 3.10 或更新版本的标准库,不需要安装 NumPy。将代码保存为 mse_demo.py,即可运行。
# 三组训练样本,顺序一一对应
xs = [1.0, 2.0, 3.0]
ys = [2.0, 4.0, 6.0]

def mse(w: float, b: float = 0.0) -> float:
    if not xs or len(xs) != len(ys):
        raise ValueError("样本不能为空,且输入输出数量必须一致")
    # 先计算每个样本的平方误差,再除以样本数量
    squared_errors = [
        (w * x + b - y) ** 2
        for x, y in zip(xs, ys)
    ]
    return sum(squared_errors) / len(xs)

# 控制截距不变,只比较斜率变化的影响
for w in [0.0, 1.0, 1.5, 2.0, 3.0]:
    print(f"w={w:.1f}, MSE={mse(w):.4f}")
运行命令:
python mse_demo.py预期输出:
w=0.0, MSE=18.6667
w=1.0, MSE=4.6667
w=1.5, MSE=1.1667
w=2.0, MSE=0.0000
w=3.0, MSE=4.6667
如果系统使用 python3 命令启动 Python 3,可以改为 python3 mse_demo.py。输出保留四位小数,所以零损失显示为 0.0000。
代码中没有调用任何机器学习框架,但已经实现了模型训练所需的损失评价部分。之后只需增加参数更新方法,就可以根据损失值寻找更好的参数。
检查损失函数的边界和使用限制
MSE 的计算虽然简单,但实际使用时需要注意以下情况。
样本数量必须正确。 三组样本的平方误差之和为 14,MSE 应为 ,不能直接把 14 当作均方误差。如果样本有 100 个,分母就应是 100。
平方不能放在求和之后。 正确做法是先计算每个样本的误差平方,再求平均。错误地先求平均误差再平方,会让正负误差互相抵消,改变优化目标。
损失下降不一定代表泛化能力提高。 这里计算的是训练集 MSE。真实项目还应使用未参与参数调整的验证集检查效果,避免只记住训练样本却无法预测新数据。
异常值可能主导损失。 如果一个样本的误差是 10,平方误差就是 100;另一个样本的误差是 1,平方误差只有 1。遇到明显异常值时,需要先核查数据质量,再决定是否采用 MSE 或更稳健的损失函数。
可以做一个小实验:将代码中的 ys 改为 [2.0, 4.0, 7.0],然后再次运行。此时 的预测仍为 2、4、6,三个平方误差分别为 0、0、1,因此 MSE 变为 。这说明即使参数不变,只要真实样本发生变化,损失值也会改变。
现在已经可以用同一套计算规则评价任意给定的 和 。后续尝试参数更新时,只需比较更新前后的 MSE,就能判断当前这一步是否降低了训练损失。