
计算机视觉 / 系统课时
常见问题排查
常见问题排查
本课建立一套从数据、训练到推理的排查顺序,帮助你快速区分标签异常、显存不足、损失不下降、漏检误检和速度瓶颈,并用可执行脚本验证 YOLO 标签格式,避免靠反复改参数碰运气。
学习目标
- 按固定顺序定位 YOLO 数据、训练和推理问题。
- 能针对显存不足、不收敛、漏检与误检选择正确修复手段。
- 使用脚本批量检查类别编号和归一化边界框。
先建立统一排查顺序
不要一看到结果异常就立刻调整学习率或置信度。最可靠的顺序是先确认数据与标签,再检查训练配置和资源,随后观察损失与验证指标,最后才处理阈值和推理性能。前一层存在问题时,后一层的调参通常只会掩盖根因。
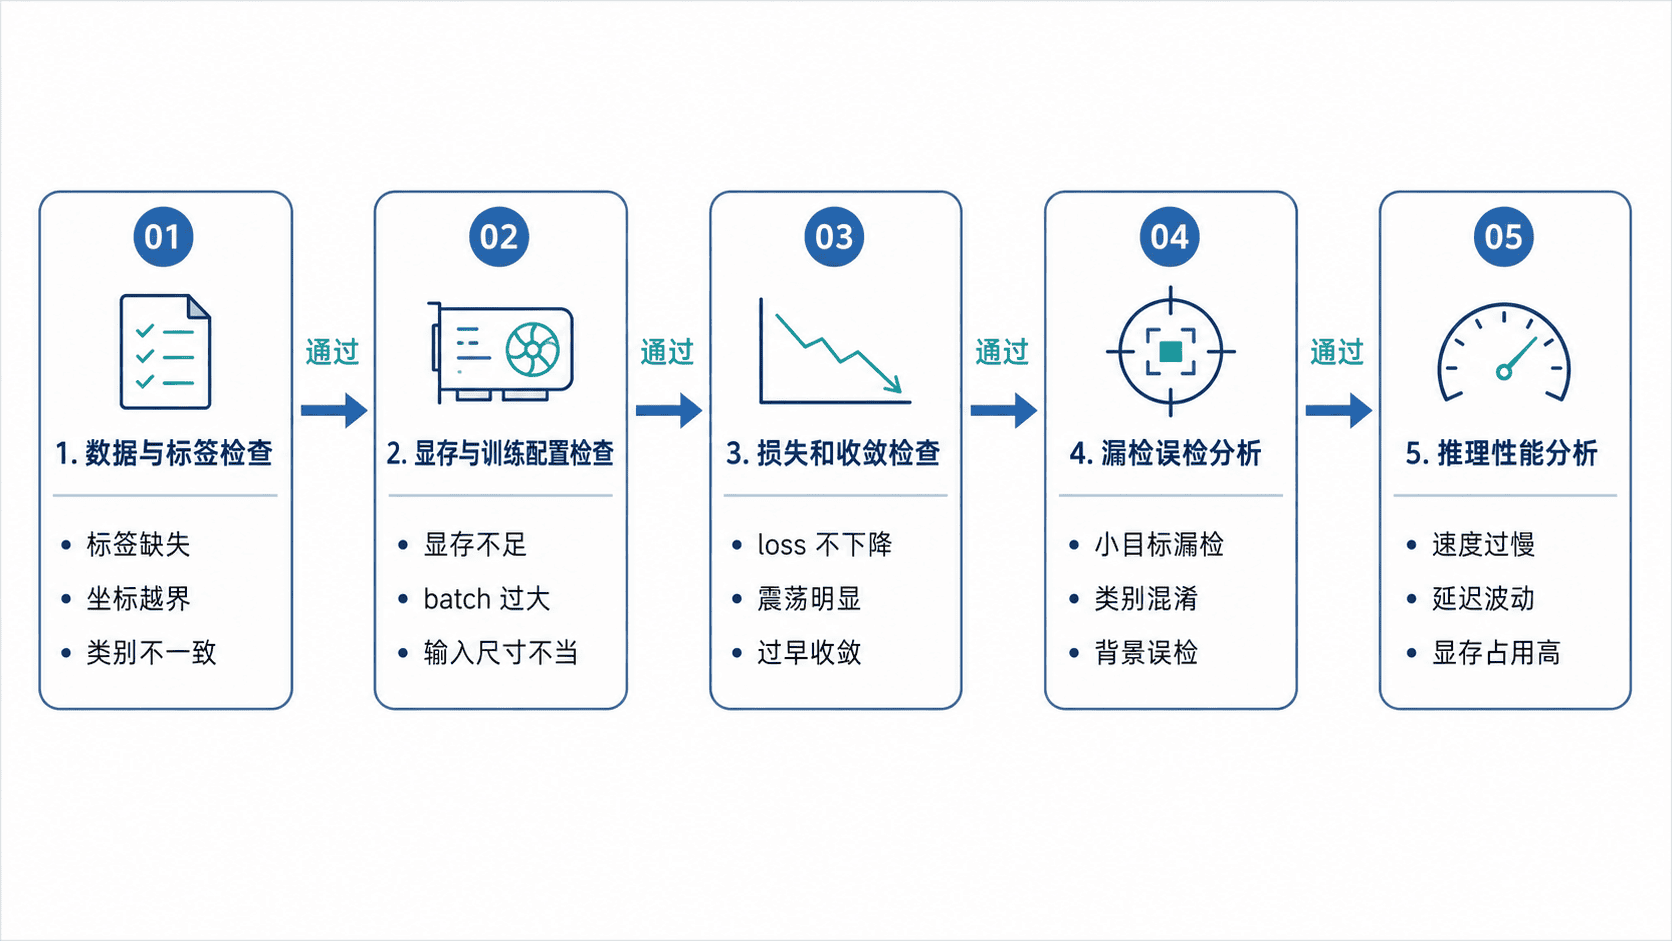
可以先按下表锁定问题所在层级,再进入具体修复。
| 现象 | 最先检查 | 常见根因 |
|---|---|---|
| 训练一开始就报错 | 标签文件与类别数 | 行字段不足、类别越界、坐标未归一化 |
| 运行数步后显存溢出 | 输入尺寸、批大小、模型规模 | 单批张量过大或缓存占用过多 |
| 损失长期不降 | 标签质量、学习率、预训练权重 | 错标、空标、学习率不合适 |
| 验证图像漏检明显 | 标注覆盖、输入分辨率、置信度阈值 | 小目标不足、阈值过高、类别样本少 |
| 重复框或误检多 | 标注一致性、置信度与 NMS | 背景被误标、阈值过低、抑制过弱 |
| 单张推理很慢 | 预处理、模型前向、后处理分别计时 | 分辨率过大、未预热、设备或精度不合适 |
用脚本检查标签错误
YOLO 检测标签通常每行包含 class_id x_center y_center width height,后四项应归一化到 0~1,宽高必须大于 0,类别编号必须落在数据集类别范围内。下面的脚本会递归扫描标签目录并报告具体文件与行号。
from pathlib import Path
import argparse

def validate_file(path: Path, class_count: int) -> list[str]:
    errors: list[str] = []

    for line_no, raw in enumerate(
        path.read_text(encoding="utf-8").splitlines(), start=1
    ):
        parts = raw.split()
        if len(parts) != 5:
            errors.append(f"{path}:{line_no}: expected 5 fields, got {len(parts)}")
            continue

        try:
            class_id = int(parts[0])
            x_center, y_center, width, height = map(float, parts[1:])
        except ValueError:
            errors.append(f"{path}:{line_no}: contains a non-numeric value")
            continue

        # 类别编号必须与数据集配置中的类别总数一致。
        if not 0 <= class_id < class_count:
            errors.append(f"{path}:{line_no}: class id {class_id} is out of range")

        # 坐标越界通常表示使用了像素值,或标注导出过程有误。
        values = (x_center, y_center, width, height)
        if not all(0.0 <= value <= 1.0 for value in values):
            errors.append(f"{path}:{line_no}: box values must be within [0, 1]")

        if width <= 0.0 or height <= 0.0:
            errors.append(f"{path}:{line_no}: width and height must be positive")

    return errors

def main() -> None:
    parser = argparse.ArgumentParser(description="Validate YOLO label files")
    parser.add_argument("--labels-dir", required=True, type=Path)
    parser.add_argument("--class-count", required=True, type=int)
    args = parser.parse_args()

    label_files = sorted(args.labels_dir.rglob("*.txt"))
    if not label_files:
        raise SystemExit(f"No label files found in {args.labels_dir}")

    all_errors: list[str] = []
    for label_file in label_files:
        all_errors.extend(validate_file(label_file, args.class_count))

    if all_errors:
        print("\n".join(all_errors))
        raise SystemExit(f"FAILED: found {len(all_errors)} issue(s)")

    print(f"OK: scanned {len(label_files)} label files, no format errors")

if __name__ == "__main__":
    main()
运行命令:
python validate_yolo_labels.py --labels-dir datasets/fruit/labels/train --class-count 3预期输出:
OK: scanned <COUNT> label files, no format errors<COUNT> 是实际扫描到的标签文件数量。格式检查通过后,还要随机可视化若干图像,确认框的位置、类别名称以及图像与标签是否一一对应;格式正确并不代表标注语义正确。
处理显存不足与训练不收敛
显存不足时应一次只改变一个因素。优先减小 batch,其次降低输入尺寸或使用更小模型;支持混合精度时可开启 AMP。仍需保持等效批量时,可以使用梯度累积,而不是直接把批大小恢复到导致溢出的数值。
训练不收敛要先区分“损失完全不下降”和“训练集下降但验证集不提升”。前者多与标签异常、学习率、冻结层或数据读取有关;后者通常是过拟合、类别不平衡或训练集与验证集分布不一致。不要只看总损失,应分别观察框回归、分类和目标置信度相关损失。
建议先用几十到几百张样本做小规模过拟合测试。模型若连这批固定样本都无法学好,问题通常在数据、标签或训练配置,而不是数据量不足。
分析漏检和误检
漏检时先用可视化结果确认目标是否被标注。若标注完整,再检查置信度阈值是否过高、输入分辨率是否不足、小目标样本是否太少,以及增强是否把目标裁掉。只降低阈值虽然可能提高召回率,但也会同时增加误检。
误检时应检查训练集中是否存在漏标,因为未标注目标会被模型当作背景学习。随后再调整置信度阈值和 NMS IoU 阈值。置信度阈值过低会保留不可靠预测;NMS IoU 阈值过高则可能让多个高度重叠的框同时保留下来。
比较方案时必须固定同一验证集,并同时观察精确率、召回率和 mAP。只凭几张“看起来不错”的图片判断模型质量,容易把偶然结果当成整体提升。
定位推理速度瓶颈
推理速度要拆成预处理、模型前向和后处理三段测量,并在正式计时前完成预热。首次运行通常包含模型加载、显存分配或编译开销,不能代表稳定吞吐。
若模型前向最慢,可降低输入尺寸、换用更小模型、启用半精度或导出到适合目标硬件的推理后端。若后处理最慢,应检查候选框数量、置信度阈值和 NMS 实现。若预处理最慢,则重点检查图像解码、尺寸变换和数据传输是否阻塞。
报告性能时要同时注明设备、精度、输入尺寸、批大小、是否包含预处理与后处理。缺少这些条件的“每秒多少帧”无法公平比较。
修复后的验收
每次修复后只验证对应假设,不要同时修改多项参数。数据问题修复后重新抽样可视化;显存问题修复后确认训练能稳定运行多个 epoch;收敛问题修复后对比同一验证集曲线;阈值调整后保存精确率与召回率;性能优化后使用相同输入重复计时。
最终应保留一份最小记录:问题现象、根因、修改项、验证数据和结果。这样下一次出现相似问题时,可以直接复用判断依据,而不是重新试错。