
计算机视觉 / 系统课时
检测头 Head
检测头 Head
检测头位于 YOLO 网络的输出端,负责把融合后的特征转换成可解码的预测。理解检测头后,就能知道模型为何可以同时给出目标类别、位置和可信程度,以及解耦结构为何更容易优化。
学习目标
- 理解检测头输出的三类核心信息
- 说清分类、回归与置信度分支各自解决的问题
- 理解耦合检测头与解耦检测头的基本差异
检测头接收什么
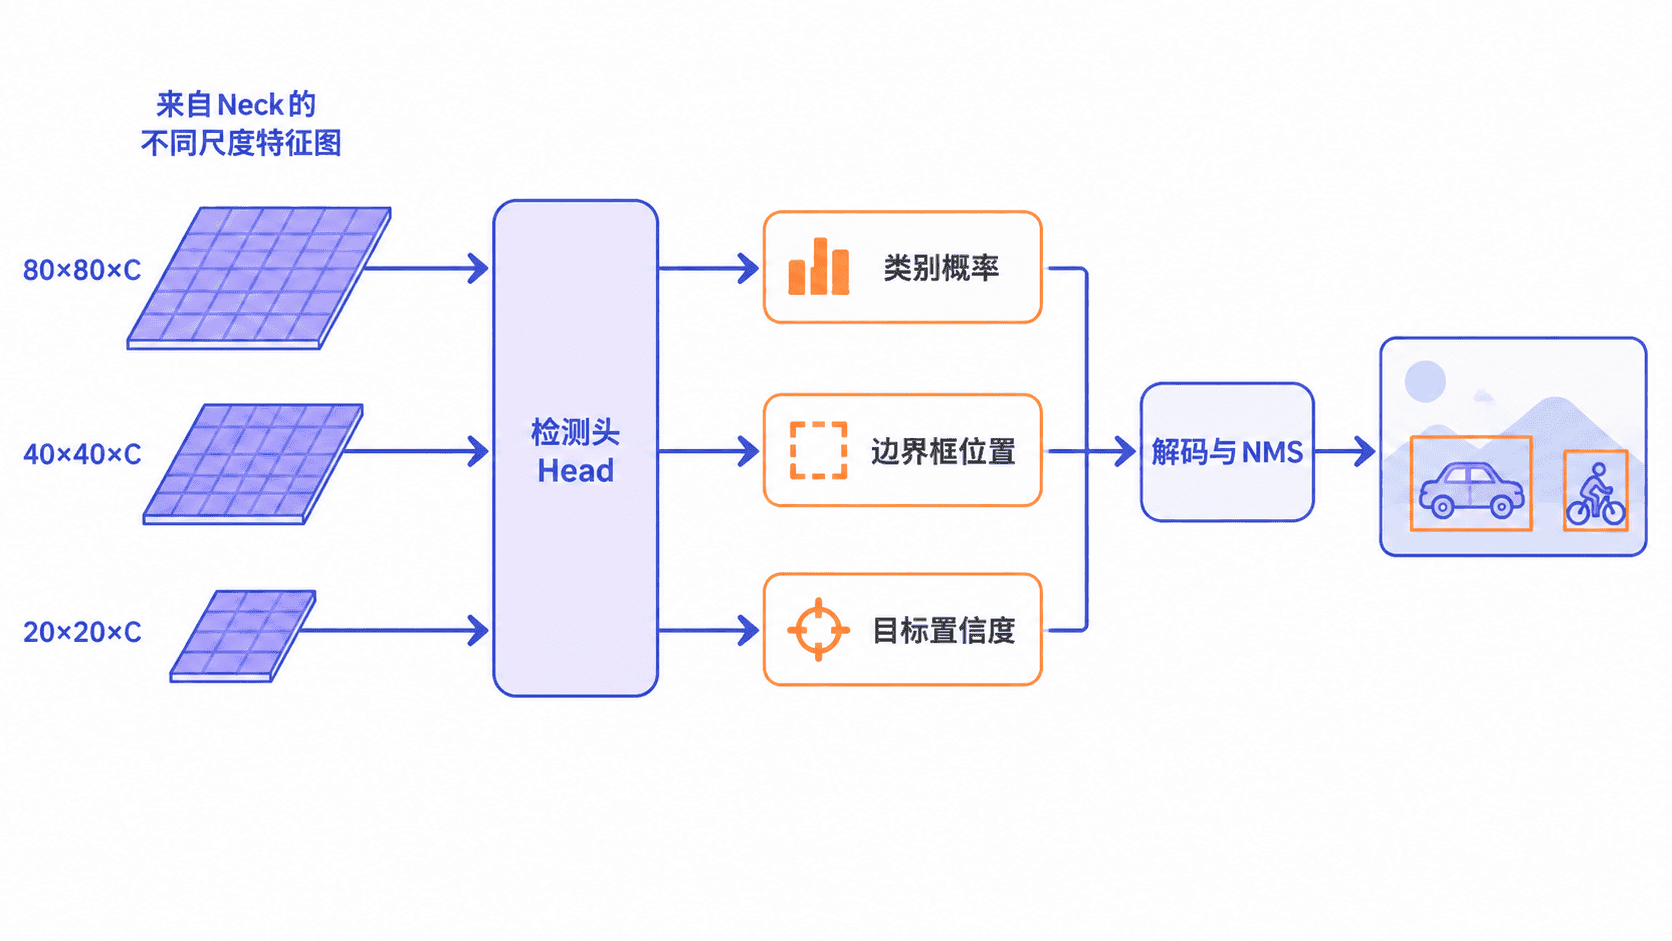
Backbone 负责提取特征,Neck 负责融合不同层级的信息,Head 则接收多个尺度的特征图,并在每个网格位置生成候选预测。
检测头不会直接输出“图中有一辆车”这样的文字结论,而是输出一组数值张量。后处理阶段再对这些数值进行边界框解码、分数计算和非极大值抑制,得到最终检测结果。
三类输出分别表示什么
类别分支判断候选位置属于哪个类别,例如人、汽车或自行车。它通常为每个类别输出一个分数,分数越高,说明模型越倾向于该类别。
回归分支预测边界框的位置和大小。不同 YOLO 版本的参数形式不同,可能直接预测中心点与宽高,也可能预测到边界的距离分布,但目标都是恢复原图坐标中的矩形框。
置信度相关输出表示该位置是否存在目标,或反映预测框的可靠程度。部分现代结构不再单独输出传统 objectness,而是把目标存在性融入分类分数,因此阅读具体模型结构时不能只凭输出通道数下结论。
从张量到最终结果
假设某个位置产生一个候选框,检测头会给出位置参数与各类别分数。后处理先把位置参数还原到输入图像坐标,再筛掉低分候选,最后使用非极大值抑制删除高度重叠的重复框。
最终置信分数的计算方式取决于模型版本。经典做法常把目标置信度与类别概率相乘,而一些无独立 objectness 的模型会直接使用类别分数。二者目的相同:为候选框排序并设置过滤阈值。
为什么要使用解耦检测头
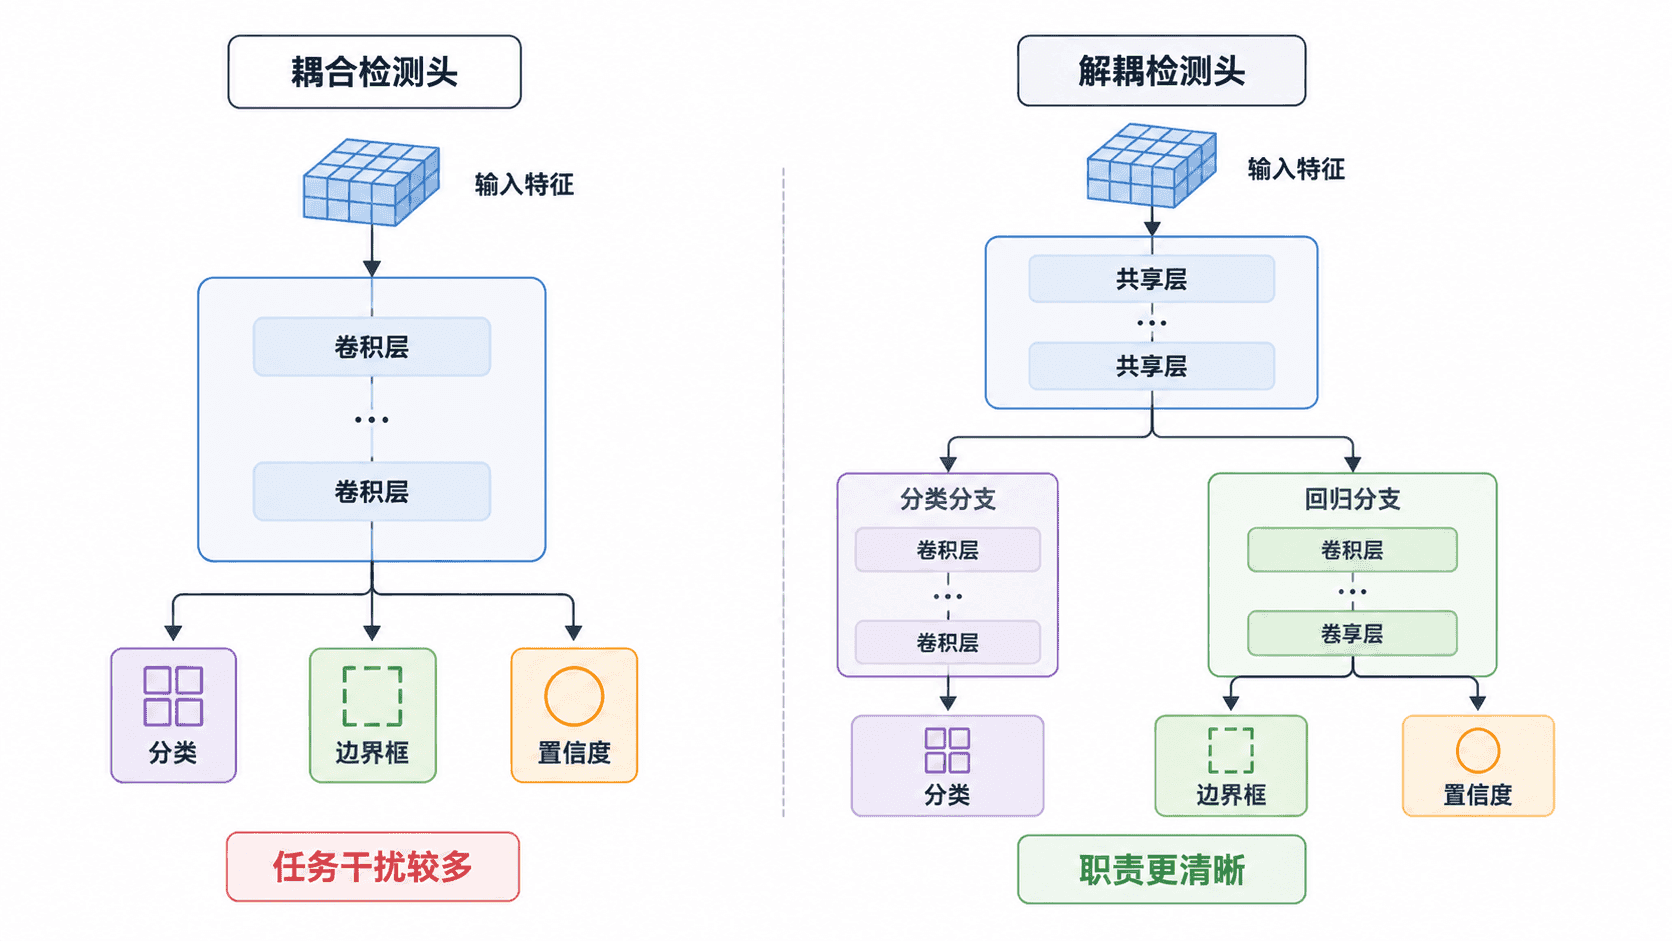
耦合检测头让分类与回归共享同一组卷积特征。结构紧凑,但两个任务关注点不同:分类更关心“是什么”,回归更关心“边界在哪里”,它们的优化方向可能发生冲突。
解耦检测头会先共享少量输入特征,再分成分类分支和回归分支,有些实现还会单独处理目标置信度。这样每个分支可以学习更适合自身任务的特征,通常更利于训练收敛和精度提升,但会带来少量参数与计算开销。
读输出形状时要注意
检测头输出通道数与类别数、框参数形式、是否使用锚框以及是否单独预测置信度有关。看到形如 4 + 1 + C 或 4 + C 的通道设计时,应先确认对应版本的定义,其中 C 表示类别数量。
还要区分训练输出与推理输出。训练阶段可能保留多个尺度的原始张量用于计算损失,推理阶段则可能先拼接、解码,再返回统一候选集合。仅凭最终张量形状,无法完整反推出内部检测头结构。