
计算机视觉 / 系统课时
边界框解码
边界框解码
网络直接输出的通常不是原图中的像素坐标,而是相对网格、步长和锚框的预测量。本课将把这些预测量还原为中心点、宽高和左上右下坐标,并说明如何消除缩放与填充带来的偏移。
学习目标
- 理解网络输出量与最终边界框坐标之间的关系
- 能将中心点和宽高转换为原图中的矩形坐标
- 知道 letterbox 预处理后为什么还要做坐标反变换
解码解决什么问题
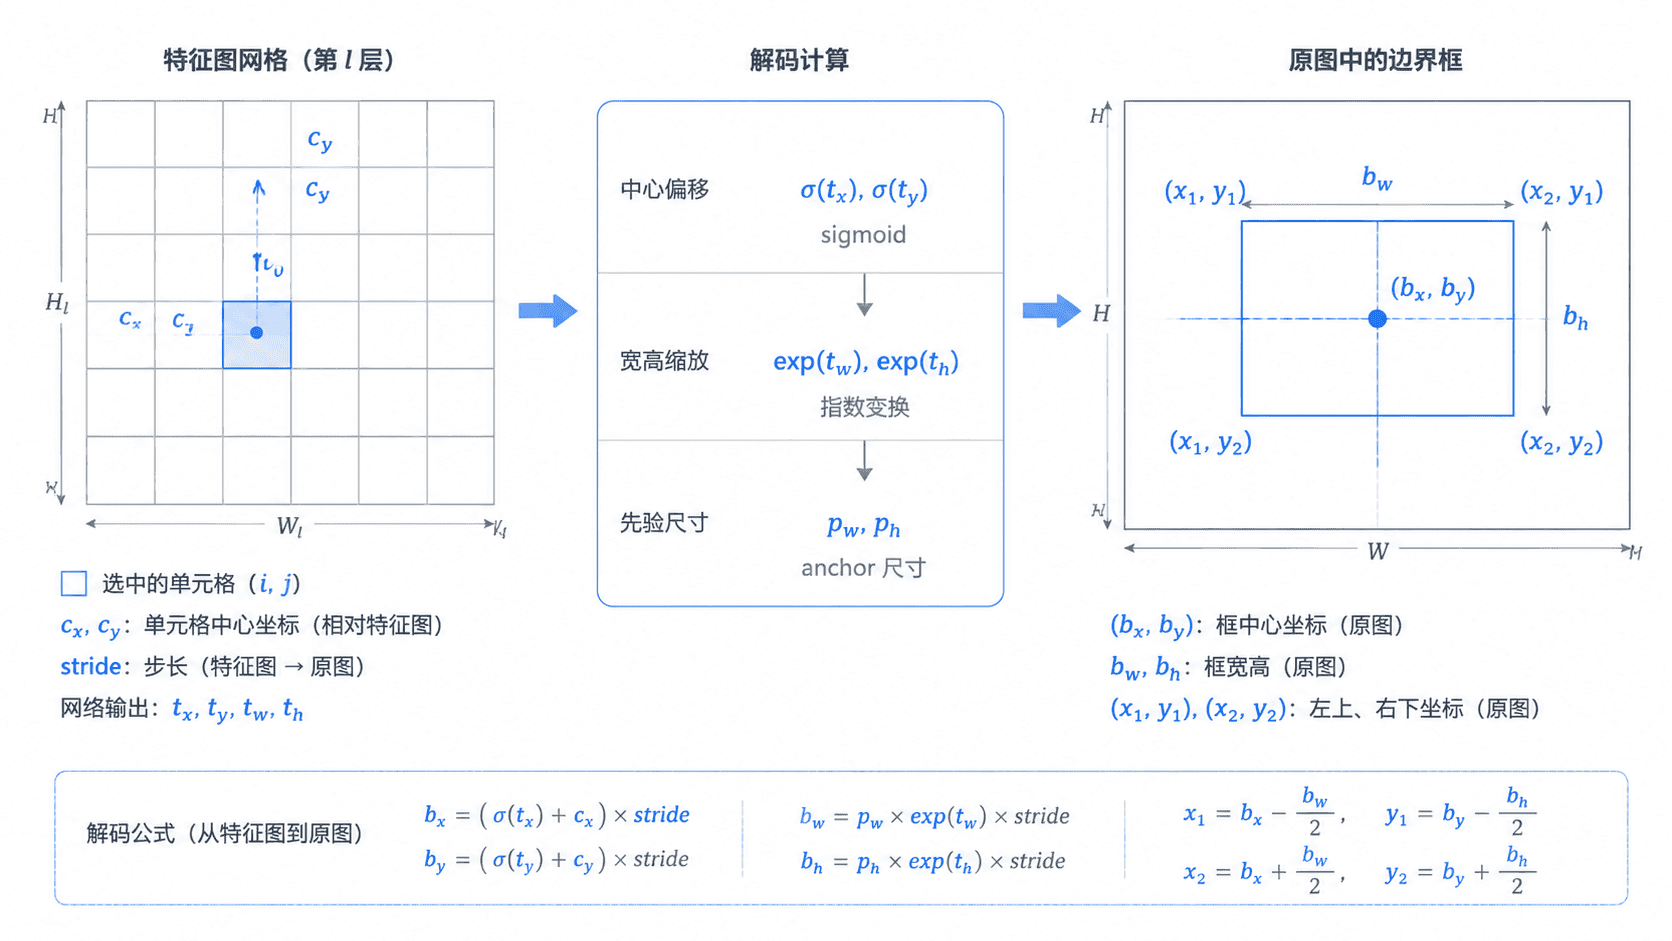
检测头会在多个特征层上输出候选框。每个候选框通常包含位置参数、目标置信度和类别分数,但位置参数往往处于特征图坐标系中,不能直接画到原图上。
以经典的 anchor-based YOLO 为例,某个网格单元输出 、、、。已知网格位置 、步长 和锚框尺寸 ,可以解码为:
其中 是边界框中心点, 是宽度和高度。不同 YOLO 版本可能采用直接回归、距离分布回归或其他变体,但目标相同:把网络输出恢复到图像坐标系。
从中心点转换为矩形坐标
多数绘制、裁剪和 NMS 接口使用左上角与右下角坐标,因此还需要完成一次转换:
下面的完整 Python 示例演示经典 anchor-based 解码,并把结果限制在图像范围内。
python
import math

def sigmoid(value: float) -> float:
    return 1.0 / (1.0 + math.exp(-value))

def decode_box(
    raw_box: tuple[float, float, float, float],
    grid_cell: tuple[int, int],
    stride: int,
    anchor: tuple[float, float],
    image_size: tuple[int, int],
) -> tuple[float, float, float, float]:
    tx, ty, tw, th = raw_box
    cx, cy = grid_cell
    anchor_w, anchor_h = anchor
    image_w, image_h = image_size

    # 先恢复中心点与宽高,再转换为左上右下坐标。
    box_cx = (sigmoid(tx) + cx) * stride
    box_cy = (sigmoid(ty) + cy) * stride
    box_w = anchor_w * math.exp(tw)
    box_h = anchor_h * math.exp(th)

    x1 = max(0.0, box_cx - box_w / 2)
    y1 = max(0.0, box_cy - box_h / 2)
    x2 = min(float(image_w), box_cx + box_w / 2)
    y2 = min(float(image_h), box_cy + box_h / 2)
    return x1, y1, x2, y2

box = decode_box(
    raw_box=(0.0, 0.0, 0.0, 0.0),
    grid_cell=(10, 6),
    stride=32,
    anchor=(80.0, 48.0),
    image_size=(640, 480),
)

print(f"x1={box[0]:.1f}, y1={box[1]:.1f}, x2={box[2]:.1f}, y2={box[3]:.1f}")
预期输出:
text
x1=296.0, y1=184.0, x2=376.0, y2=232.0当 时,sigmoid 输出 0.5,因此中心点位于当前网格单元内部的中间位置;当 时,解码后的宽高等于锚框宽高。
恢复到原图坐标
推理前常用 letterbox 将原图等比例缩放后补边。假设缩放比例为 ,左侧和顶部填充分别为 、,模型输入坐标需要按下式恢复:
宽度和高度只需除以 。完成反变换后,还要把坐标裁剪到原图宽高范围内,避免浮点误差产生负值或越界值。
关键边界与版本差异
不要把所有 YOLO 版本都套用同一组公式。anchor-based 模型通常依赖锚框,anchor-free 模型可能预测中心点加宽高,也可能预测到四条边的距离;采用 DFL 的模型还要先把离散分布求期望,再得到边界距离。
实际工程中应以模型导出格式和官方后处理实现为准。最可靠的验证方法,是选取一个候选框,逐步打印原始输出、解码坐标和反变换坐标,再与可视化结果核对。
按自己的节奏,确认真正理解。