
计算机视觉 / 系统课时
多尺度检测
多尺度检测
同一张图像里,目标可能只占十几个像素,也可能覆盖大半画面。多尺度检测的作用,就是让不同分辨率的特征图分别负责不同大小的目标,从而兼顾小目标细节与大目标语义。
学习目标
- 理解特征图尺度与目标大小之间的对应关系
- 说清小型、中型和大型目标为何由不同检测层负责
- 能根据漏检现象判断可能受影响的检测尺度
为什么单一尺度不够
卷积网络会不断下采样。浅层特征图分辨率高,保留了边缘、纹理和位置细节;深层特征图分辨率低,但感受野更大,包含更完整的类别语义。
如果只在最深层预测,较大的目标通常容易识别,但小目标可能在多次下采样后只剩一两个特征点,甚至完全消失。反过来,只使用高分辨率特征图,又会增加计算量,并且缺少稳定的高级语义。
因此,YOLO 通常同时在多个尺度上进行预测,让每个尺度承担更合适的目标范围。
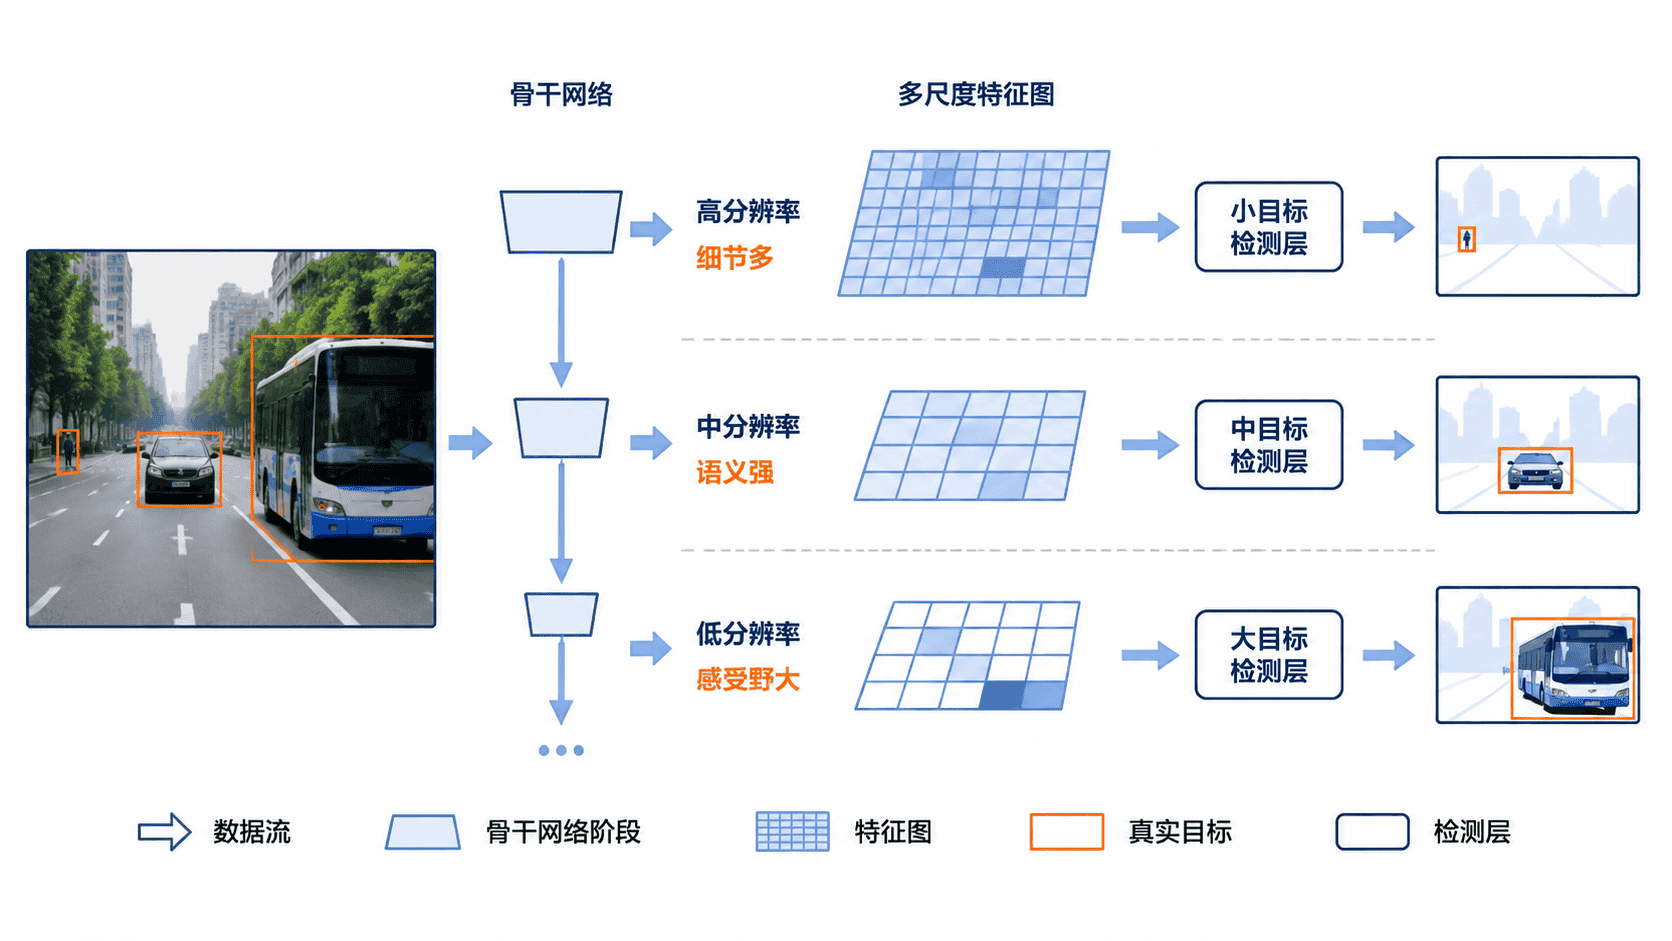
三个尺度如何分工
假设输入尺寸为 640×640,常见检测层步长为 8、16、32,对应特征图尺寸分别约为 80×80、40×40、20×20。步长表示特征图上一个网格点对应原图中的像素跨度。
| 检测层 | 特征图特点 | 更擅长的目标 |
|---|---|---|
| 高分辨率层 | 网格密集,定位细节丰富 | 小目标 |
| 中分辨率层 | 细节与语义较均衡 | 中型目标 |
| 低分辨率层 | 感受野大,语义更完整 | 大目标 |
这里的“小、中、大”不是固定像素阈值,而是相对于输入尺寸、数据分布和模型结构而言。一个 40×40 像素的物体,在 640×640 输入中可能算小目标,在 160×160 输入中则未必。
特征融合为什么必要
不同尺度不是简单地各自独立工作。YOLO 的 Neck 通常会把深层语义向高分辨率层传递,也会把浅层定位信息向低分辨率层汇聚。
这样,高分辨率检测层不只拥有细节,还能获得“这是什么”的语义;低分辨率检测层也能补充“具体在哪里”的位置信息。多尺度检测真正有效,依赖的正是预测尺度与特征融合共同工作。
常见误区与判断方法
不要把“高分辨率层”理解成只检测小目标。实际预测结果由训练数据、标签分配和损失优化共同决定,不同层之间存在重叠范围。
当模型对远处行人、密集小零件频繁漏检时,可以优先检查输入分辨率是否过低、小目标样本是否不足,以及高分辨率检测层是否被删除。若大型目标边界不完整,则应检查深层特征表达和标注质量,而不是盲目增加更多检测尺度。