
计算机视觉 / 系统课时
网格与预测位置
网格与预测位置
YOLO 不会只在整张图像上输出一个结果,而是在多个尺度的特征图位置上并行生成候选框。本课将把“网格位置、步长、预测点和边界框”连接起来,理解一个特征图单元如何对应原图区域。
学习目标
- 理解多尺度特征图与输入图像位置之间的映射关系
- 掌握步长、网格坐标和预测点中心的计算方法
- 区分 anchor-based 与 anchor-free 的边界框表达方式
预测发生在多尺度特征图上
以 640×640 输入、检测头步长为 8、16、32 的常见结构为例,模型会得到 80×80、40×40、20×20 三个预测尺度。高分辨率特征图保留更多位置细节,适合发现小目标;低分辨率特征图具有更大的感受野,更适合描述大目标。
每个特征图位置都可以看作一个预测起点。它并不表示目标必须完全落在某个格子里,而是表示该位置负责输出一组类别分数和边界框参数。
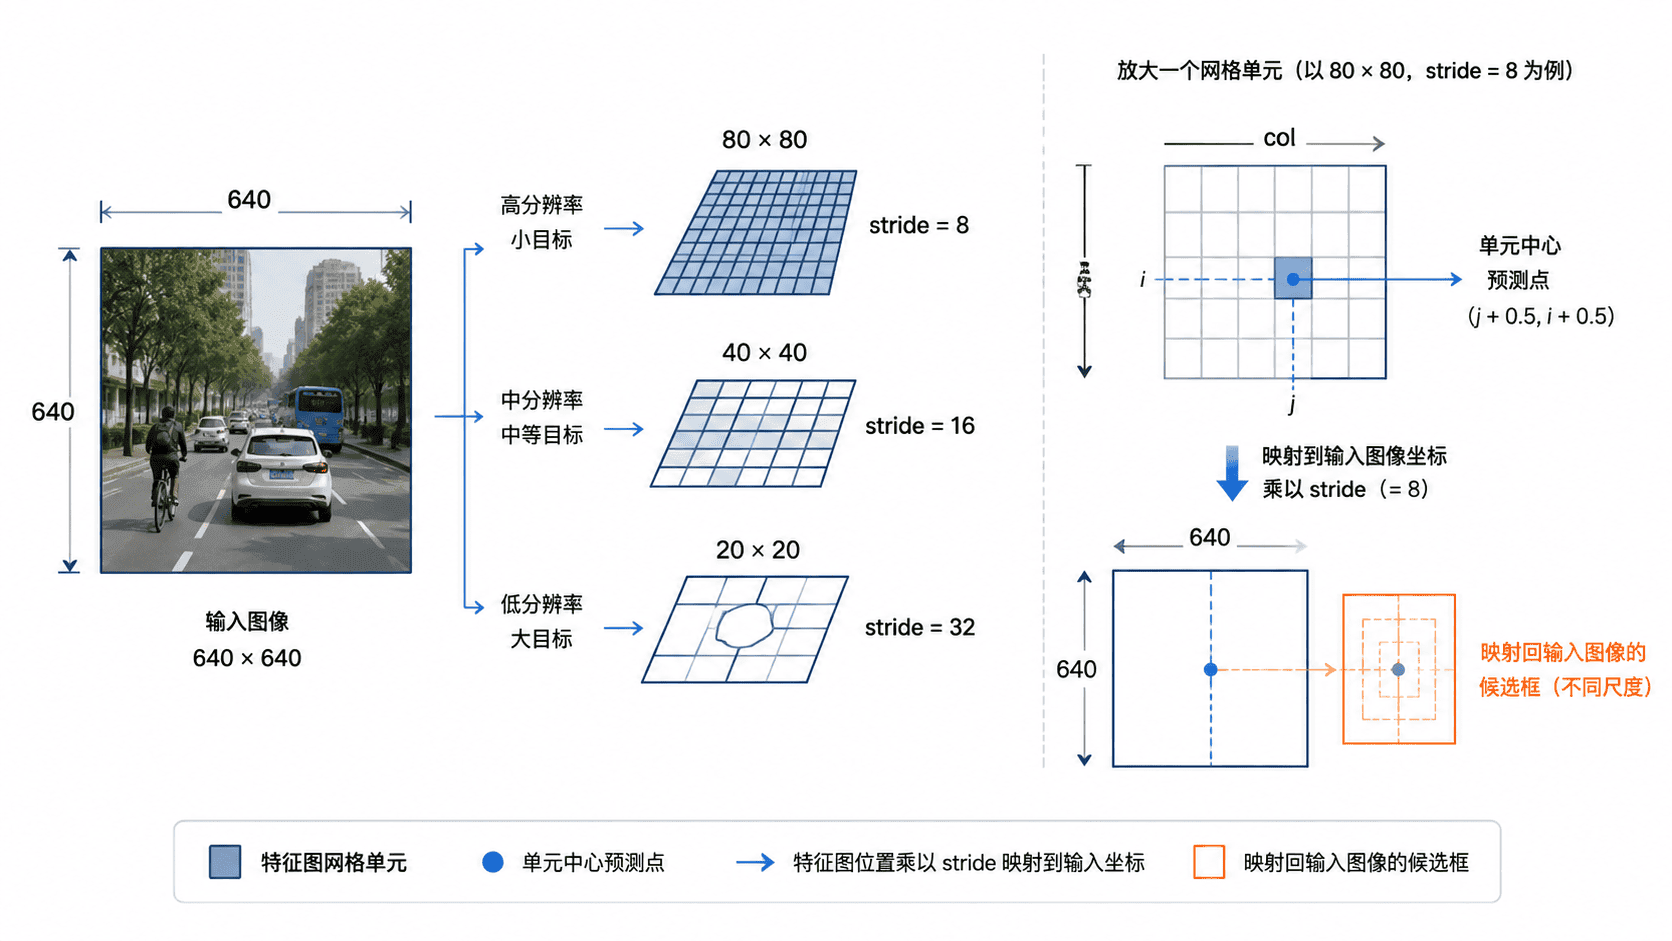
从网格坐标映射到输入坐标
设某个特征图位置的行列索引为 (row, col),步长为 s。如果预测点位于单元中心,那么它在输入图像上的中心坐标可写为:
例如在步长为 8 的特征图上,位置 (10, 20) 的中心点是 (164, 84)。这里先加 0.5,是因为数组索引表示单元左上角,而预测点通常放在单元中心。实际 YOLO 版本可能学习额外偏移,但“特征图坐标乘以步长得到输入坐标”的关系不变。
一个预测位置会输出什么
不同 YOLO 版本的输出排列并不完全相同,但一个位置通常包含三类信息:边界框回归参数、类别分数,以及可选的目标存在概率。推理阶段会把这些原始值解码为输入图像坐标中的候选框。
anchor-based 检测头基于预设锚框预测中心偏移和宽高缩放;anchor-free 检测头则常从预测点回归到框四条边的距离。两者的表达方式不同,但最终都要得到 (x1, y1, x2, y2) 或等价的中心点与宽高。
多尺度为何能覆盖不同大小的目标
在 80×80 特征图上,相邻预测点只相隔 8 个输入像素,位置更密集,能够描述较小目标的细微位移。到了 20×20 特征图,相邻预测点相隔 32 像素,但单个位置综合了更大范围的语义信息,更适合判断大目标。
这不是严格的一一分工。训练时,样本分配策略会根据目标大小、位置和匹配质量选择正样本;推理时,各尺度仍会同时产生候选框,后续再通过置信度筛选和非极大值抑制去除重复结果。
主示例:解码一个 anchor-free 边界框
下面用一个简化示例演示:预测点位于网格中心,模型输出它到左、上、右、下四条边的距离,距离单位为“特征图格数”。乘以步长后即可得到输入图像中的像素距离。
def decode_box(
    row: int,
    col: int,
    stride: int,
    left: float,
    top: float,
    right: float,
    bottom: float,
) -> tuple[float, float, float, float]:
    # 网格索引加 0.5,得到当前单元的中心预测点
    center_x = (col + 0.5) * stride
    center_y = (row + 0.5) * stride

    # 四个距离先乘步长,再从中心点扩展为边界框
    x1 = center_x - left * stride
    y1 = center_y - top * stride
    x2 = center_x + right * stride
    y2 = center_y + bottom * stride
    return x1, y1, x2, y2

box = decode_box(
    row=10,
    col=20,
    stride=8,
    left=2.0,
    top=1.5,
    right=3.0,
    bottom=2.5,
)

print(f"center=({(20 + 0.5) * 8:.1f}, {(10 + 0.5) * 8:.1f})")
print(f"box=({box[0]:.1f}, {box[1]:.1f}, {box[2]:.1f}, {box[3]:.1f})")
print(f"size=({box[2] - box[0]:.1f}, {box[3] - box[1]:.1f})")
预期输出
center=(164.0, 84.0)
box=(148.0, 72.0, 188.0, 104.0)
size=(40.0, 32.0)
真实模型可能使用分布式回归、激活函数或版本特定的解码公式,但最终都要完成同一件事:把某个特征图位置的输出转换为输入图像坐标中的候选框。
候选数量与易混淆点
若三个尺度分别为 80×80、40×40、20×20,并且每个位置输出一个候选框,那么单张图片会产生 8400 个候选位置。anchor-based 结构若每个位置配置多个锚框,候选数量还会进一步增加。
网格只是预测坐标系,不是边界框边界。一个框可以跨越多个格子,也可以覆盖远大于当前单元的区域。训练阶段“哪个位置负责某个目标”由样本分配策略决定,不能简单理解为目标中心落在哪个格子,就永远只由那个格子负责。