
计算机视觉 / 系统课时
优化器与学习率
优化器与学习率
本课解决训练参数“会跑但不一定收敛”的问题。你将理解优化器如何利用梯度更新权重,初始学习率为何决定更新幅度,以及预热与衰减怎样组成一条稳定的训练节奏。
学习目标
- 说清优化器、学习率和权重衰减的不同职责
- 理解预热、恒定阶段与衰减阶段的作用
- 能根据损失曲线选择更合理的调整顺序
优化器决定参数怎样更新
模型反向传播得到梯度后,优化器负责把梯度转换为参数更新。最基本的形式为:
其中, 是当前参数, 是梯度, 是当前学习率。实际优化器还会结合动量、历史梯度或权重衰减,减少震荡并改善泛化。
| 优化器 | 主要特点 | 常见使用倾向 |
|---|---|---|
| SGD + Momentum | 更新稳定、泛化表现常较好,对学习率较敏感 | 数据量较大、训练轮数充足 |
| AdamW | 自适应调整不同参数的步长,早期收敛较快 | 快速实验、批次较小或梯度尺度差异明显 |
权重衰减用于抑制参数无限增大。使用 Adam 系列时,通常优先选择解耦权重衰减的 AdamW,而不是把所有正则化都混入梯度更新。
学习率决定每一步走多远
学习率过大时,参数可能跨过最优区域,表现为损失剧烈震荡、突然升高或出现非数值结果。学习率过小时,损失虽然平稳,却下降缓慢,有限训练轮数内可能仍处于欠收敛状态。
初始学习率应结合优化器、批次大小和模型规模设置。批次增大后可以适度提高学习率,但不能机械地线性放大;数据噪声、归一化方式和梯度累积都会改变有效更新幅度。
预热与调度组成完整节奏
训练刚开始时,模型权重和批次统计尚不稳定。预热会从较小学习率逐步升到目标值,降低早期大梯度破坏参数的风险。主训练阶段再使用余弦、线性或分段衰减,让模型先快速搜索,再以小步长细化。
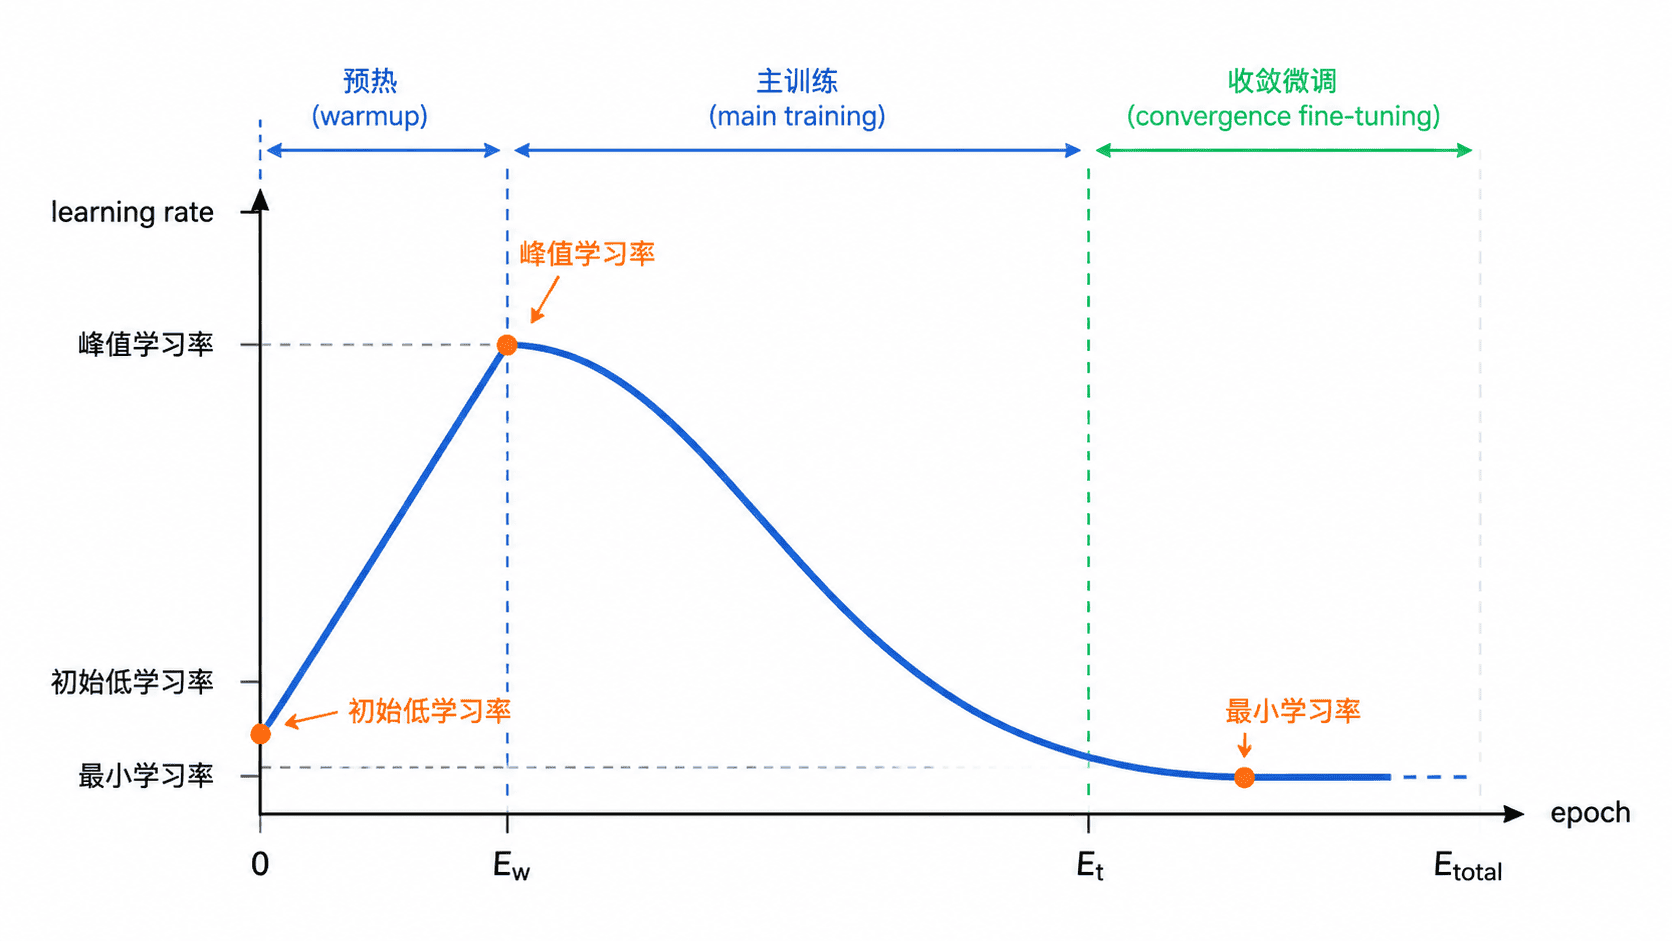
预热太短可能仍会震荡,太长则浪费有效训练时间;最终学习率过高会让模型难以精修,过低则可能几乎停止更新。调度策略必须与总训练轮数一起设计。
主示例:生成预热加余弦学习率
下面的完整 Python 程序只演示学习率变化,不依赖深度学习框架。前两个 epoch 线性预热,之后使用余弦函数衰减到最小学习率。
import math

EPOCHS = 10
WARMUP_EPOCHS = 2
LR0 = 0.01
MIN_LR = 0.001

def learning_rate(epoch: int) -> float:
    # 预热阶段逐步抬升,避免训练初期更新过猛
    if epoch < WARMUP_EPOCHS:
        return LR0 * (epoch + 1) / WARMUP_EPOCHS

    # 主阶段平滑衰减,并在最后一个 epoch 到达最小值
    progress = (epoch - WARMUP_EPOCHS + 1) / (EPOCHS - WARMUP_EPOCHS)
    cosine = 0.5 * (1 + math.cos(math.pi * progress))
    return MIN_LR + (LR0 - MIN_LR) * cosine

for epoch in range(EPOCHS):
    print(f"epoch={epoch + 1:02d}, lr={learning_rate(epoch):.6f}")
预期输出
epoch=01, lr=0.005000
epoch=02, lr=0.010000
epoch=03, lr=0.009657
epoch=04, lr=0.008682
epoch=05, lr=0.007222
epoch=06, lr=0.005500
epoch=07, lr=0.003778
epoch=08, lr=0.002318
epoch=09, lr=0.001343
epoch=10, lr=0.001000
在真实 YOLO 训练框架中,应把同样的阶段逻辑映射到框架提供的优化器和调度器参数,并通过训练日志确认每个 epoch 的实际学习率。
根据曲线调整参数
调整时应一次只改变一个主要变量,并保留对照实验。推荐顺序是先确认数据和损失正常,再处理学习率,最后比较优化器和权重衰减。
| 现象 | 优先动作 |
|---|---|
| 前几轮损失突然升高 | 降低初始学习率或延长预热 |
| 损失长期缓慢下降 | 适度提高学习率或增加训练轮数 |
| 中后期持续震荡 | 提前衰减或降低最终学习率 |
| 训练集继续变好,验证集变差 | 检查过拟合,并调整权重衰减和增强策略 |
不要同时更换优化器、学习率、批次大小和数据增强,否则即使结果变好,也无法确定真正有效的因素。