
计算机视觉 / 系统课时
训练样本如何匹配
训练样本如何匹配
模型训练前,必须先确定每个真实目标由哪些预测位置负责。匹配结果决定哪些预测被视为正样本、负样本或忽略样本,也直接影响分类、定位和置信度损失能否得到有效监督。
学习目标
- 理解真实目标与预测位置之间的匹配关系
- 区分正样本、负样本和忽略样本的训练职责
- 了解静态匹配与动态匹配的基本差异
为什么必须进行样本匹配
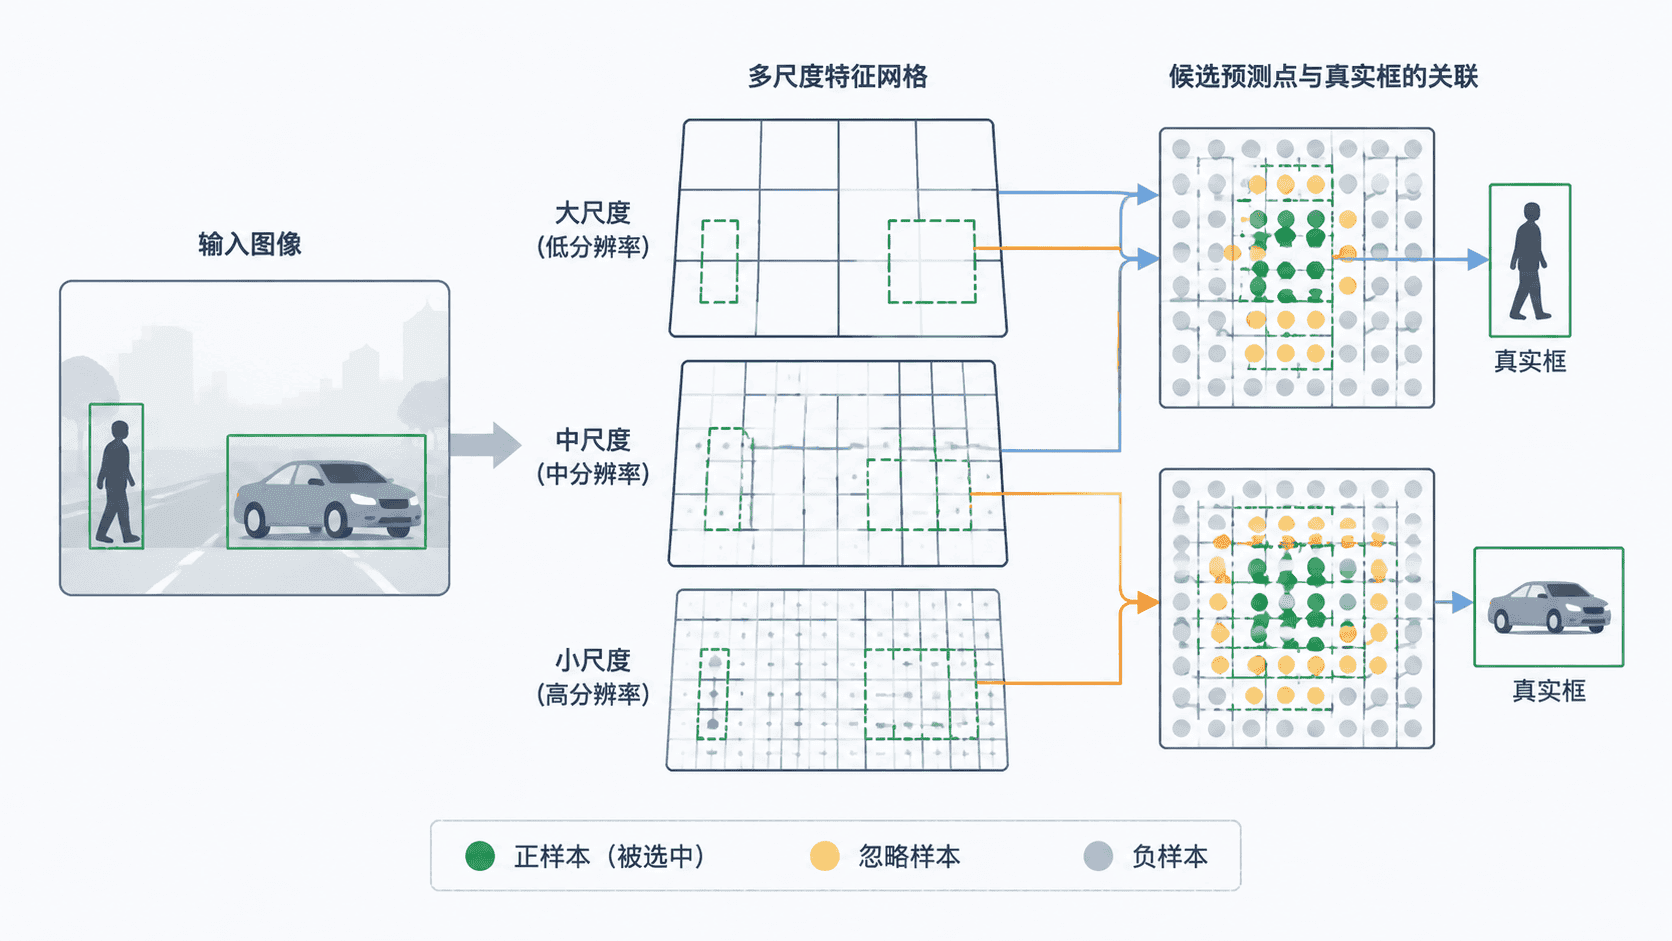
YOLO 会在多个特征层、多个空间位置上产生大量预测。假设一张图片只有 3 个真实目标,模型仍可能输出数千个候选框。训练程序必须回答一个关键问题:每个真实框应该监督哪些候选预测?
如果不进行匹配,所有预测都不知道自己该靠近哪个真实框。若匹配过少,正样本监督不足;若匹配过多,同一目标会产生大量重复预测,并削弱负样本约束。
三类样本分别做什么
匹配完成后,候选预测通常被划分为三类。不同 YOLO 版本的具体规则可能不同,但三类样本承担的职责基本一致。
| 样本类型 | 含义 | 主要训练作用 |
|---|---|---|
| 正样本 | 被分配给某个真实目标的预测位置 | 学习目标类别、边界框和目标置信度 |
| 负样本 | 未匹配任何真实目标的背景位置 | 学习降低目标置信度,减少误检 |
| 忽略样本 | 不作为正样本,但与真实框较接近的位置 | 暂不施加强负样本惩罚,避免错误压制 |
正样本并不等于已经预测正确,而是表示该位置获得了一个明确的学习任务。训练初期,它的预测框可能与真实框相差很大,优化器会通过损失逐步调整参数。
常见匹配依据
早期的锚框式 YOLO 通常结合网格位置、锚框尺寸和 IoU 完成分配。真实目标中心落入某个网格后,再从该位置的多个锚框中选择形状最接近的候选作为正样本。
无锚框模型通常把真实框内部或中心附近的预测点作为候选,然后根据几何关系、分类分数和定位质量进一步筛选。中心区域限制可以减少距离目标过远的位置被错误选中。匹配过程通常会考虑以下信息:
- 预测点是否位于真实框内部或中心区域
- 候选框与真实框的重叠程度
- 候选预测的分类可信度
- 一个目标需要分配多少个正样本
- 同一预测位置同时匹配多个目标时如何解决冲突
静态匹配与动态匹配
静态匹配使用预先确定的规则。例如,每个真实目标固定选择一个最佳锚框,或者选择所有满足宽高比例阈值的候选。它计算简单、行为稳定,但不能根据模型当前的预测质量调整正样本数量。
动态匹配会在训练过程中计算候选与真实目标之间的匹配代价,再选择代价较低的一组候选。一个容易检测的大目标可能获得多个高质量正样本,而困难目标得到的正样本数量可能更少。
动态匹配中的代价通常综合分类误差和定位误差。代价越小,说明该候选越适合负责当前真实目标。若一个候选同时被多个目标选中,通常保留代价最小的匹配关系。
匹配结果如何影响训练
完成匹配后,训练程序会生成与预测张量形状对应的监督目标。正样本位置写入类别标签和真实框参数,负样本位置主要参与背景或目标置信度训练,忽略位置则从部分损失中排除。
因此,样本匹配不是简单的数据预处理,而是连接模型输出与损失函数的关键步骤。定位损失通常只在正样本上计算;如果匹配规则不合理,即使损失函数设计正确,模型也可能出现收敛缓慢、漏检或重复框过多的问题。