
计算机视觉 / 系统课时
输入图像预处理
输入图像预处理
YOLO 接收的不是任意尺寸的原始图片,而是形状、数值范围和通道顺序统一的批次张量。本课从一张普通 RGB 图像出发,完成等比例缩放、填充、归一化和维度转换,并验证最终张量能否直接送入模型。
学习目标
- 理解等比例缩放与填充为何能避免图像形变
- 掌握像素归一化、通道转换和批次组织的顺序
- 能根据缩放比例与填充值还原检测框坐标
为什么原图不能直接送入模型
真实图片的宽高、颜色通道和数据类型并不统一,而神经网络通常要求同一批次中的样本具有完全相同的张量形状。如果直接把不同尺寸的图片拼成批次,程序会因维度不一致而失败;如果强行拉伸到固定尺寸,目标外形又会发生变形。
预处理的目标不是“美化图片”,而是建立稳定的数据契约:模型始终接收固定尺寸、固定通道、固定数值范围和固定维度顺序的张量。
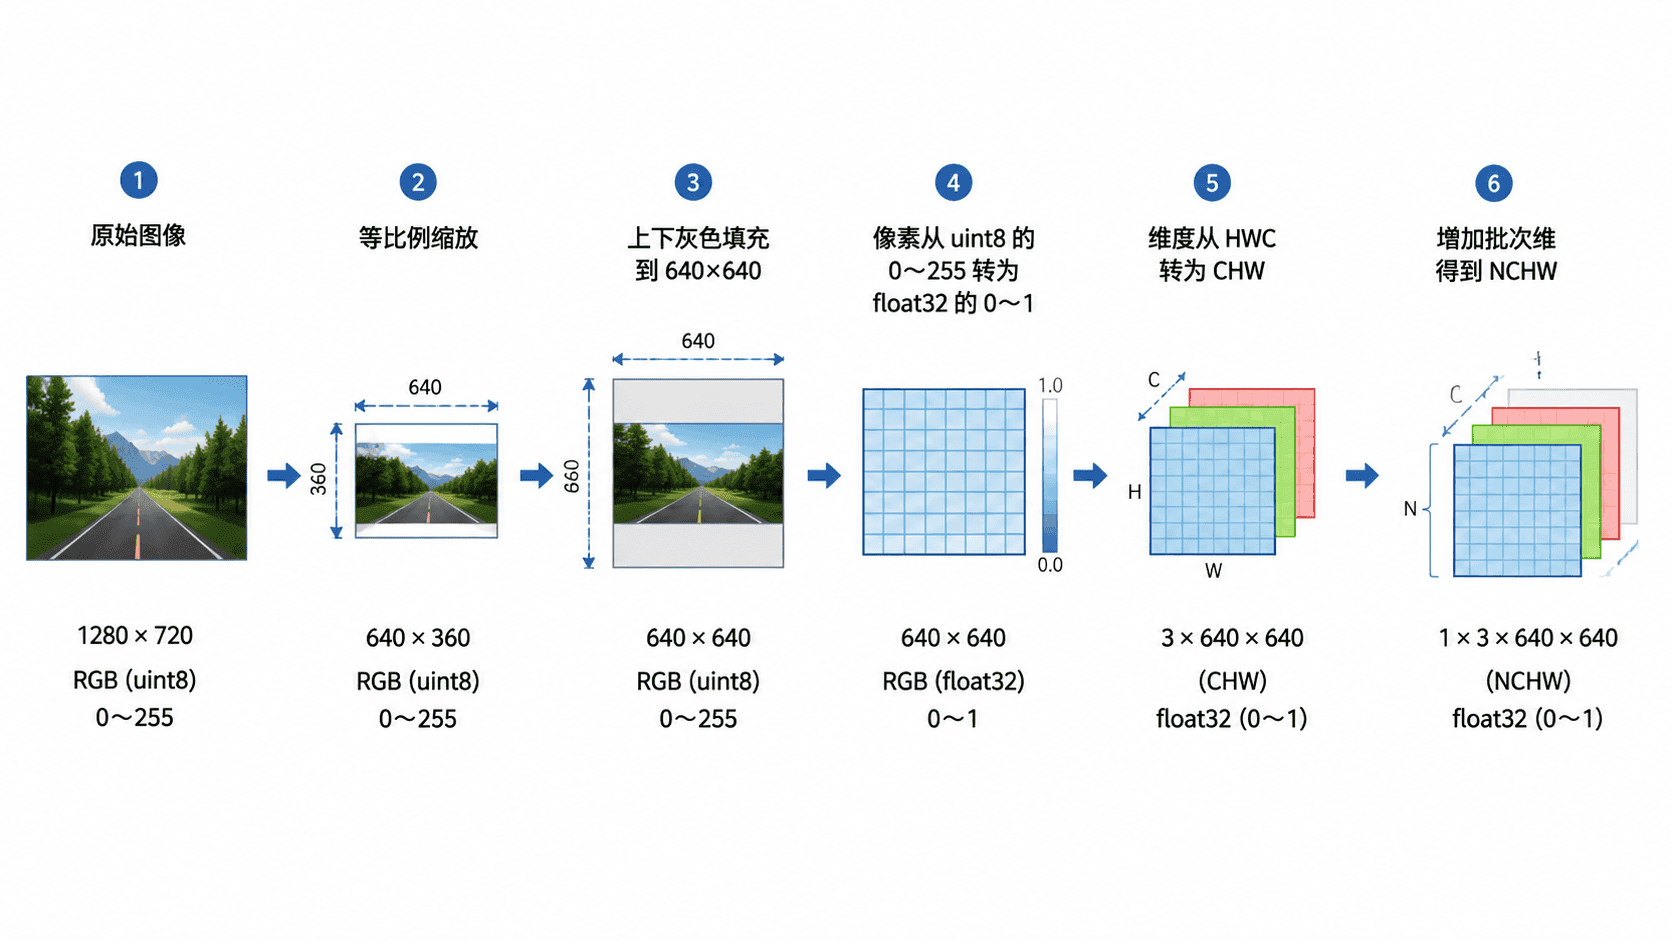
等比例缩放与填充
常见做法是 letterbox:先按相同比例缩放宽和高,再把不足的区域填充到模型要求的尺寸。设原图大小为 ,目标大小为 ,缩放比例为 。
例如把 1280×720 的图片送入 640×640 的模型,缩放比例为 0.5,缩放后得到 640×360。宽度已经满足要求,高度还差 280 像素,因此可以在顶部和底部各填充 140 像素。
这种处理保留了目标的长宽比例。模型输出框映射回原图时,需要先减去填充值,再除以缩放比例;否则框会整体偏移或尺寸错误。
像素、通道与数据类型
图片通常以 uint8 保存,像素范围是 0~255;模型计算一般使用 float32,并把数值缩放到 0~1。最常见的归一化方式是直接除以 255,而不是对单张图片重新计算均值和方差。
还要确认颜色通道顺序。PIL 读取的彩色图通常是 RGB,OpenCV 默认是 BGR。若通道顺序错误,程序仍能运行,但模型看到的颜色分布与训练阶段不一致,准确率会明显下降。
批次与张量维度
图片数组通常采用 HWC,即“高度、宽度、通道”;深度学习框架中的卷积层通常接收 CHW,即“通道、高度、宽度”。单张图片转换为 CHW 后,还要在最前面增加批次维,最终得到 NCHW。
对于 640×640 的 RGB 图片,单张输入张量形状是 1×3×640×640。多张图片组成批次时,第一维会变为批次数量,例如 8 张图片对应 8×3×640×640。
主示例:完成一张图片的预处理
下面的示例创建一张 1280×720 的测试图片,按 letterbox 方式处理为 640×640,再转换为 PyTorch 张量。运行前需要安装 Pillow、NumPy 和 PyTorch。
from PIL import Image
import numpy as np
import torch

def letterbox(image: Image.Image, target_size: tuple[int, int]) -> tuple[Image.Image, float, tuple[int, int]]:
    target_width, target_height = target_size
    width, height = image.size

    # 使用同一缩放比例,避免目标被横向或纵向拉伸
    scale = min(target_width / width, target_height / height)
    resized_size = (round(width * scale), round(height * scale))
    resized = image.resize(resized_size, Image.Resampling.BILINEAR)

    # 将缩放后的图像居中放入固定尺寸画布
    canvas = Image.new("RGB", target_size, (114, 114, 114))
    pad_x = (target_width - resized_size[0]) // 2
    pad_y = (target_height - resized_size[1]) // 2
    canvas.paste(resized, (pad_x, pad_y))
    return canvas, scale, (pad_x, pad_y)

image = Image.new("RGB", (1280, 720), (120, 160, 200))
processed, scale, padding = letterbox(image, (640, 640))

array = np.asarray(processed, dtype=np.float32) / 255.0
tensor = torch.from_numpy(array).permute(2, 0, 1).unsqueeze(0).contiguous()

print(f"original={image.size}")
print(f"resized={(round(image.width * scale), round(image.height * scale))}")
print(f"padding={padding}")
print(f"tensor_shape={tuple(tensor.shape)}")
print(f"dtype={tensor.dtype}")
print(f"value_range=({tensor.min().item():.4f}, {tensor.max().item():.4f})")
预期输出
original=(1280, 720)
resized=(640, 360)
padding=(0, 140)
tensor_shape=(1, 3, 640, 640)
dtype=torch.float32
value_range=(0.4471, 0.7843)
这里的数值范围由测试图片颜色和填充值共同决定。替换为真实图片后,最小值和最大值可能不同,但形状、数据类型和 0~1 的范围约束应保持不变。
验证与边界处理
送入模型前至少检查四项:张量形状是否为 NCHW、数据类型是否为 float32、像素是否落在预期范围、通道顺序是否与训练阶段一致。批量推理时,每张图片还必须使用相同的目标尺寸。
模型输出框映射回原图时,可按 、 还原坐标,并将结果裁剪到原图边界内。若预处理阶段使用了非对称填充,必须分别记录左右和上下偏移,不能只保存一个总填充值。