
计算机视觉 / 系统课时
非极大值抑制
非极大值抑制
YOLO 通常会在同一目标附近输出多个位置相近的候选框。本课将解释重复框为何产生,并通过完整示例掌握非极大值抑制的筛选顺序、IoU 阈值作用以及拥挤场景中的常见边界。
学习目标
- 理解同一目标产生多个候选框的原因
- 掌握非极大值抑制的逐轮筛选过程
- 能根据检测场景合理调整 IoU 阈值
为什么会出现重复候选框
YOLO 会在多个网格位置或多个尺度的特征图上同时预测目标。一个物体可能被相邻位置共同感知,因此模型会输出若干中心点、宽高和置信度略有差异的检测框。
这些候选框并不一定是错误预测。它们说明多个预测位置都认为该区域存在目标,但最终结果只需要保留最可信、定位最准确的一个框。非极大值抑制负责完成这一去重过程。
NMS 的筛选过程
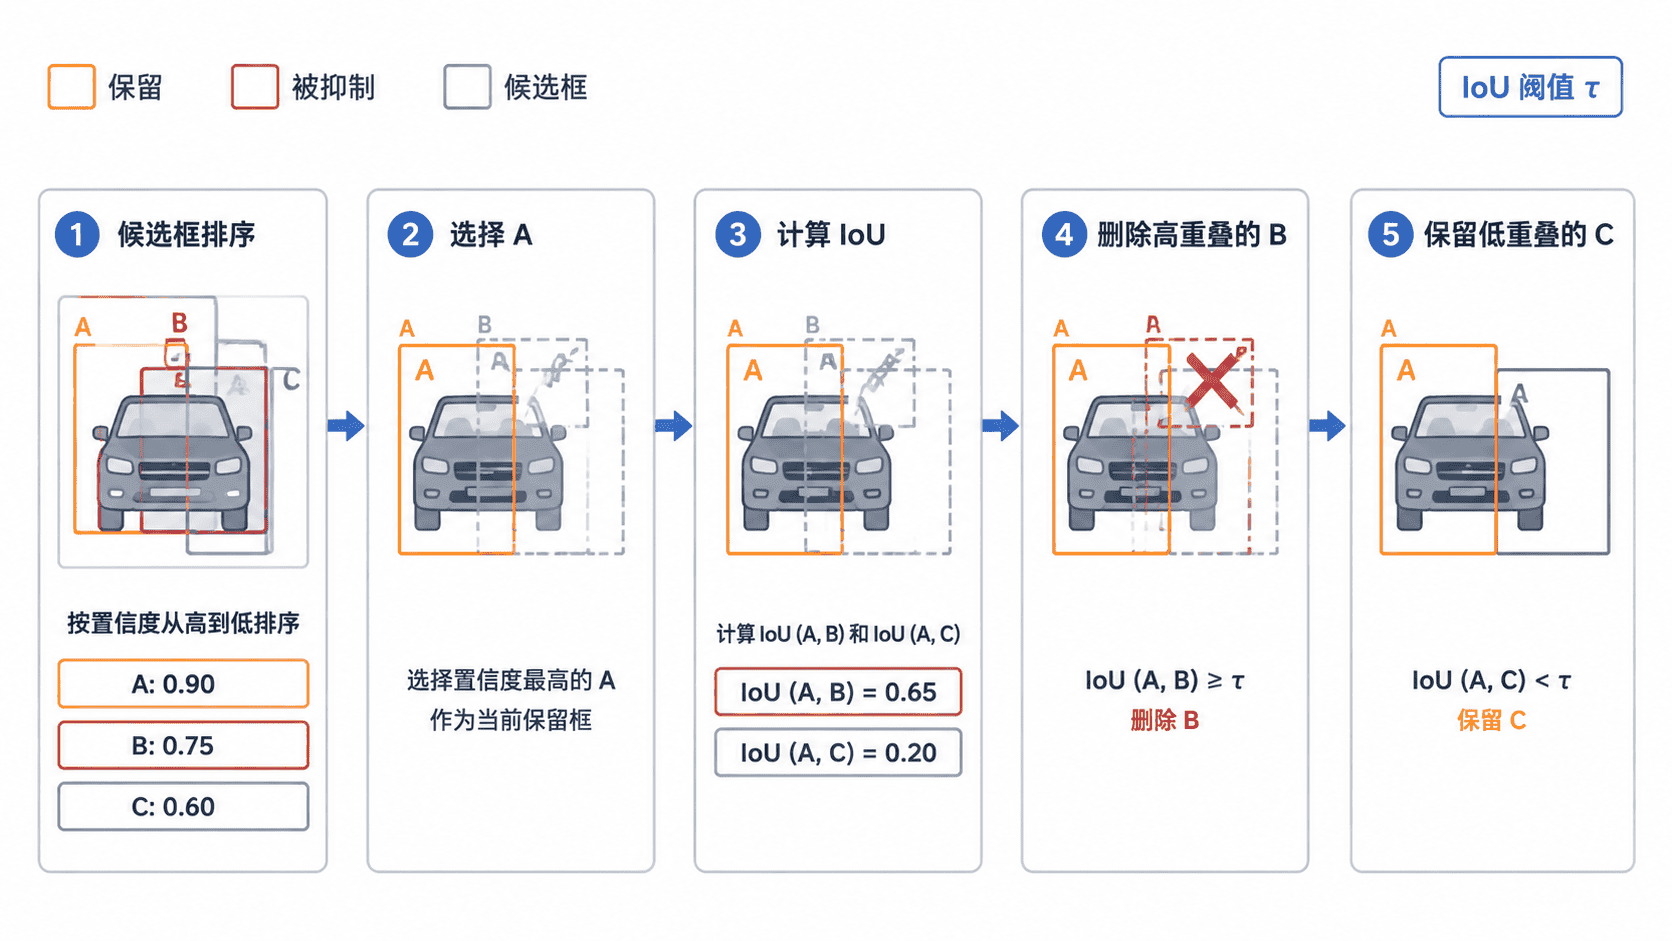
标准非极大值抑制通常按照类别分别处理候选框,核心依据是置信度和交并比 IoU。IoU 表示两个框的重叠程度,取值越接近 1,说明两个框覆盖的区域越相似。具体过程如下:
- 删除置信度低于最低阈值的候选框。
- 将剩余候选框按置信度从高到低排序。
- 取出当前置信度最高的框并加入保留结果。
- 计算它与其余同类别候选框的 IoU。
- 删除 IoU 高于抑制阈值的候选框。
- 对尚未处理的候选框重复上述步骤,直到列表为空。
用一个例子走完筛选
假设模型对同一类别输出了三个候选框,IoU 抑制阈值设置为 0.5。排序后首先处理置信度最高的 A。
| 候选框 | 置信度 | 与 A 的 IoU | 处理结果 |
|---|---|---|---|
| A | 0.92 | 1.00 | 首先保留 |
| B | 0.84 | 0.76 | 与 A 高度重叠,删除 |
| C | 0.67 | 0.21 | 与 A 重叠较低,暂时保留 |
删除 B 后,下一轮将 C 作为当前最高分候选框。此时已经没有其他框需要比较,因此最终结果为 A 和 C。若 C 实际对应另一个相邻目标,这种处理就能同时保留两个检测结果。
阈值如何影响结果
IoU 阈值越低,抑制越严格。例如阈值为 0.3 时,稍有重叠的候选框也可能被删除,重复框较少,但相邻目标容易被误删。阈值越高,模型越倾向于保留重叠框,适合目标密集的场景,但可能留下重复检测。
NMS 前的置信度阈值同样重要。置信度阈值过低会让大量低质量候选框进入计算,增加处理时间;设置过高则可能在 NMS 开始前就漏掉真实目标。
标准 NMS 通常只抑制同类别候选框。若两个高度重叠的框分别预测为行人和自行车,它们可以同时保留。不同实现可能提供类别无关 NMS,应根据任务需求确认配置。
易混淆点
NMS 不会重新计算边界框,也不会提高模型原始定位能力。它只在已有候选框中执行保留和删除。若所有候选框的位置都不准确,调整 NMS 阈值无法从根本上修复定位问题。
在人员密集、货架商品或车流场景中,两个真实目标可能具有较高 IoU。此时可以适当提高阈值,或采用 Soft-NMS 等方法逐步降低重叠框分数,而不是直接将其删除。