
计算机视觉 / 系统课时
规划检测项目
规划检测项目
本课把一个模糊的“做个检测模型”转成可执行项目:明确检测对象、数据边界、验收指标与运行环境,并建立统一目录和实施顺序。完成后,你将得到一份能指导采集、训练、评估和交付的最小项目方案。
学习目标
- 确定检测类别、数据范围与不纳入范围
- 选择与业务目标一致的评价指标
- 建立可复用的项目目录和实施清单
明确项目边界与验收标准
先写清模型要识别什么,以及哪些情况不负责。类别名称应可观察、互斥且能稳定标注,例如将“安全帽”和“未戴安全帽”定义为两个类别,而不是使用含义模糊的“违规”。
数据范围至少要说明拍摄设备、光照、视角、目标尺寸和使用场景。还要主动收集不含目标的负样本,以及外观相似但不属于目标的干扰物,避免模型只记住固定背景。
验收指标必须与使用方式对应。离线评估可使用 Precision、Recall 和 mAP;上线验收还应增加单张推理耗时、显存占用和漏检上限。不要只写“准确率高”,而要写成可检查的条件,例如“验证集 Recall 不低于 0.90,目标设备单张推理不超过 40 ms”。
| 决策项 | 需要写清的内容 | 常见风险 |
|---|---|---|
| 检测类别 | 类别名称、编号、边界定义 | 类别重叠,标注人员理解不一致 |
| 数据范围 | 场景、设备、视角、时间段 | 训练数据与真实环境不一致 |
| 评价指标 | Precision、Recall、mAP、延迟 | 只看 mAP,忽略漏检和速度 |
| 运行环境 | 操作系统、GPU、显存、部署端 | 训练成功但目标设备无法运行 |
建立目录与实施顺序
项目目录要把原始数据、处理后数据、配置、脚本和训练结果分开。这样既能避免覆盖原始文件,也便于复现实验。
mkdir -p yolo-project/{data/{raw,images,labels,splits},configs,scripts,runs,docs}
touch yolo-project/README.md yolo-project/configs/dataset.yaml
find yolo-project -maxdepth 2 -type d | sort
预期输出
yolo-project
yolo-project/configs
yolo-project/data
yolo-project/data/images
yolo-project/data/labels
yolo-project/data/raw
yolo-project/data/splits
yolo-project/docs
yolo-project/runs
yolo-project/scripts
该命令适用于 Linux、macOS 或 WSL。data/raw 只保存原始资料,data/images 与 data/labels 保存清洗后的训练数据,runs 保存每次训练输出,禁止把结果直接写回原始目录。
实施顺序建议固定为“定义类别 → 采集与标注 → 质量检查 → 数据划分 → 基线训练 → 误差分析 → 调参复训 → 导出部署”。每一步都应有可交付物,而不是直接跳到训练。
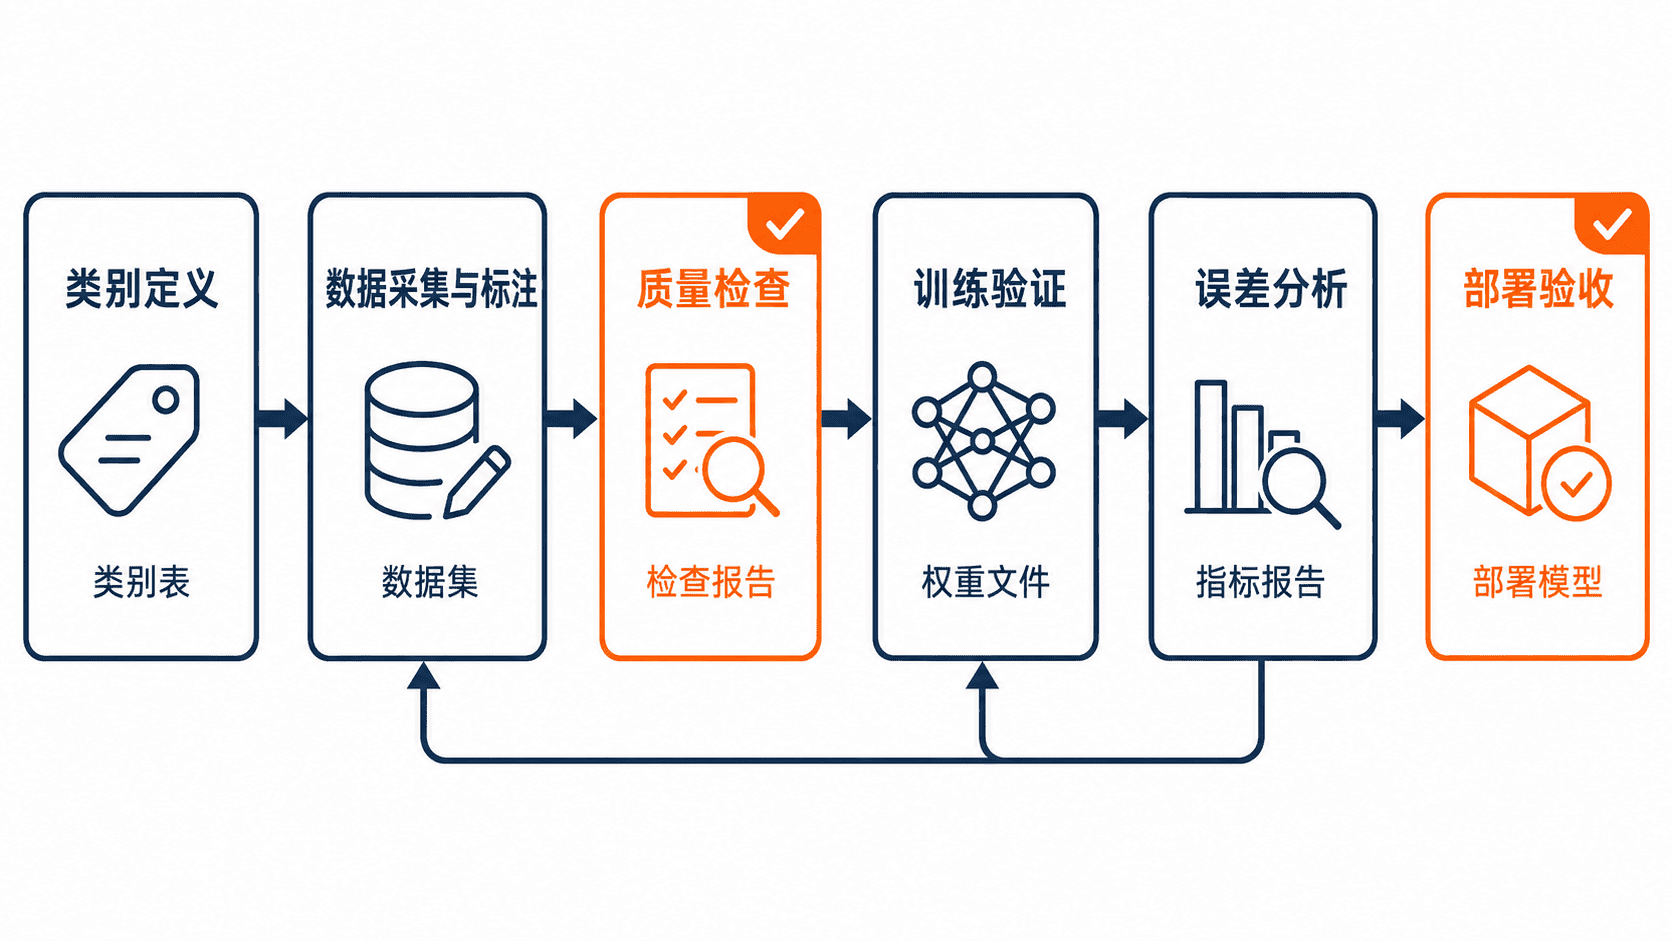
固化环境与项目清单
训练前记录 Python、YOLO 框架、CUDA、显卡驱动和关键依赖版本。环境信息应与第一次基线结果一起保存,否则后续指标变化可能来自依赖升级,而不是模型改进。
项目启动清单至少应确认:类别定义已评审、数据来源合法、标注规范可执行、训练与部署设备已确定、指标阈值可测量、目录可写且原始数据有备份。只有这些条件成立,项目才进入数据处理阶段。