
计算机视觉 / 系统课时
模型导出与部署
模型导出与部署
本课把训练得到的 YOLO 权重转换为 ONNX 模型,并封装一个可调用的 HTTP 推理接口。完成后,你将明确模型文件、预处理、推理引擎、后处理和接口契约之间的边界,并能在本机完成一次部署验收。
学习目标
- 理解模型导出与在线推理服务的完整链路
- 将
.pt权重导出为支持动态输入维度的 ONNX 文件 - 封装并验证包含明确输入输出约定的检测接口
从训练权重到部署服务
训练阶段常直接使用 .pt 权重,部署阶段则要根据硬件和运行环境选择推理格式。无论最终选择 ONNX、TensorRT 还是 OpenVINO,服务端都应把模型细节封装在接口内部,对调用方只暴露稳定的请求与响应结构。
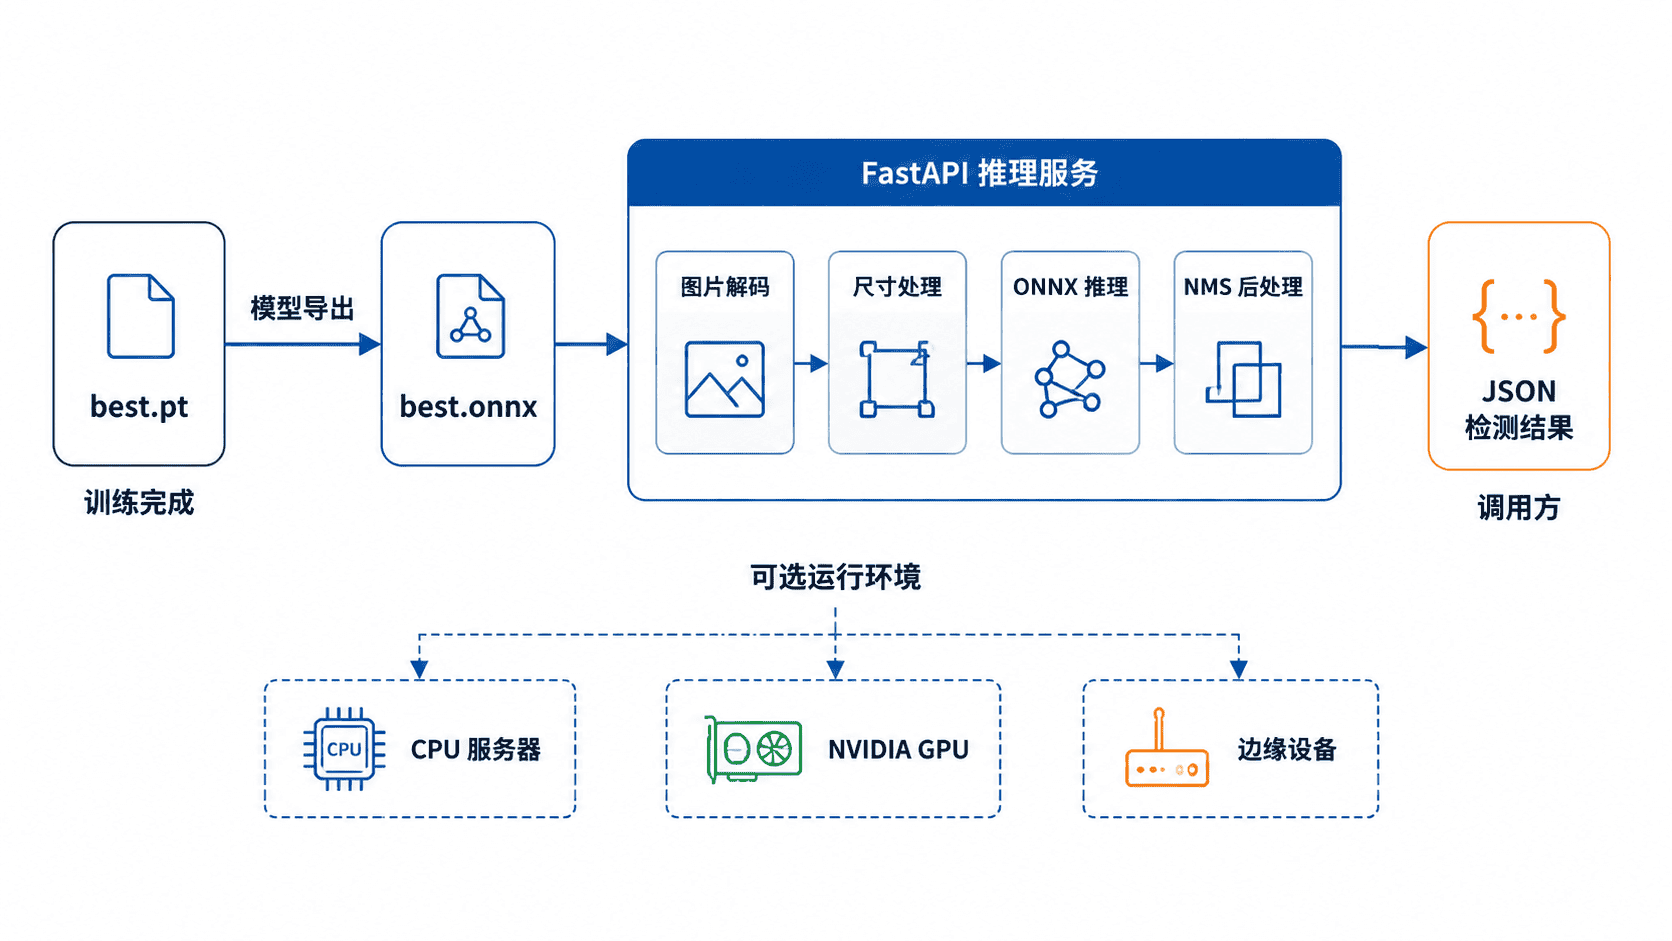
部署链路中最容易出错的不是“能否加载模型”,而是输入尺寸、颜色顺序、归一化方式、置信度阈值和输出坐标是否保持一致。使用 Ultralytics 封装 ONNX 推理,可以先复用其预处理和后处理逻辑,再根据性能需求逐步替换为底层运行时。
导出 ONNX 模型
创建 export_model.py,指定训练权重、输入尺寸和 ONNX opset。dynamic=True 允许批次维度变化,适合服务接口按请求逐张处理图片。
import argparse
from pathlib import Path

from ultralytics import YOLO

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--weights", default="best.pt")
    parser.add_argument("--imgsz", type=int, default=640)
    parser.add_argument("--opset", type=int, default=12)
    args = parser.parse_args()

    weights = Path(args.weights)
    if not weights.is_file():
        raise FileNotFoundError(f"权重不存在:{weights}")

    # 先加载训练权重,再交由 Ultralytics 生成 ONNX 图。
    model = YOLO(str(weights))
    exported_path = model.export(
        format="onnx",
        imgsz=args.imgsz,
        opset=args.opset,
        dynamic=True,
        # 初次导出先关闭图优化,减少额外依赖和兼容性变量。
        simplify=False,
    )
    print(f"导出完成:{exported_path}")

if __name__ == "__main__":
    main()
预期结果
脚本读取指定权重并生成 ONNX 文件;实际文件路径会在执行命令后打印。执行导出命令:
python -m pip install ultralytics onnx onnxruntime
python export_model.py --weights best.pt --imgsz 640 --opset 12
预期结果
导出完成:best.onnx实际导出日志会包含模型摘要、算子信息和耗时,文件名也可能带原权重目录。验证时至少确认 ONNX 文件存在且大小大于 0;若导出报算子不支持,应把 opset 调整到目标运行时支持的范围,并检查运行时是否支持模型中的算子。
约定接口输入与输出
本示例约定调用方通过 multipart/form-data 上传字段名为 file 的图片,并用查询参数 conf 控制置信度阈值。服务返回图片宽高和检测数组,每个检测项包含类别编号、类别名称、置信度以及 x1、y1、x2、y2 坐标。
| 项目 | 约定 |
|---|---|
| 请求方法 | POST /v1/detect |
| 图片字段 | file |
| 支持格式 | OpenCV 可解码的 JPEG、PNG 等图片 |
| 置信度 | conf,范围 0~1,默认 0.25 |
| 坐标 | 原图像素坐标,左上角与右下角形式 |
| 成功响应 | HTTP 200,返回图片尺寸和检测数组 |
| 非法图片 | HTTP 400,返回可读错误信息 |
接口契约应独立于具体模型格式。后续即使把 ONNX 换成 TensorRT,只要输入输出语义不变,客户端就不需要修改。
封装 FastAPI 推理接口
先安装服务端依赖并验证导入。服务器环境通常使用无界面的 opencv-python-headless,避免额外图形库依赖。
python -m pip install fastapi uvicorn python-multipart ultralytics onnxruntime opencv-python-headless
python -c "import fastapi, cv2, onnxruntime; print('服务依赖可用')"
预期输出
服务依赖可用创建 app.py。模型在进程启动时加载一次,避免每次请求重复读取文件;接口只负责解码图片、调用模型和整理响应。
import os

import cv2
import numpy as np
from fastapi import FastAPI, File, HTTPException, Query, UploadFile
from ultralytics import YOLO

MODEL_PATH = os.getenv("MODEL_PATH", "best.onnx")
# 模型在进程启动时加载一次,避免每次请求重复初始化。
MODEL = YOLO(MODEL_PATH)
app = FastAPI(title="YOLO Inference API")

@app.get("/health")
def health():
    return {"status": "UP", "model": MODEL_PATH}

@app.post("/v1/detect")
async def detect(
    file: UploadFile = File(...),
    conf: float = Query(default=0.25, ge=0.0, le=1.0),
):
    content = await file.read()
    # 上传内容必须能被 OpenCV 解码为三通道图像。
    image = cv2.imdecode(np.frombuffer(content, dtype=np.uint8), cv2.IMREAD_COLOR)
    if image is None:
        raise HTTPException(status_code=400, detail="无法解码上传图片")

    result = MODEL.predict(image, imgsz=640, conf=conf, verbose=False)[0]
    detections = []
    for box in result.boxes:
        class_id = int(box.cls[0].item())
        x1, y1, x2, y2 = [round(value, 2) for value in box.xyxy[0].tolist()]
        detections.append(
            {
                "classId": class_id,
                "className": result.names[class_id],
                "confidence": round(float(box.conf[0].item()), 4),
                "box": {"x1": x1, "y1": y1, "x2": x2, "y2": y2},
            }
        )

    # 返回原图坐标,调用方不需要反算模型内部缩放比例。
    height, width = image.shape[:2]
    return {
        "image": {"width": width, "height": height},
        "detections": detections,
    }
预期结果
应用定义完成;启动后将提供 GET /health 和 POST /v1/detect 两个接口。启动服务:
MODEL_PATH=best.onnx uvicorn app:app --host 0.0.0.0 --port 8000预期输出
Uvicorn running on http://0.0.0.0:8000端口可按部署环境调整为 <PORT>。生产环境还应由进程管理器或容器负责重启、日志和资源限制,而不是直接在终端长期运行单个进程。
调用接口并完成验收
使用一张测试图片调用接口:
curl -i -F "file=@demo.jpg" "http://127.0.0.1:8000/v1/detect?conf=0.25"预期结果
HTTP/1.1 200 OK
content-type: application/json

{"image":{"width":1280,"height":720},"detections":[{"classId":0,"className":"person","confidence":0.9132,"box":{"x1":110.42,"y1":84.16,"x2":502.71,"y2":690.33}}]}
上面的类别、尺寸、坐标和置信度只展示响应结构,实际值由模型和图片决定。验收时还应检查 /health 返回 UP、非法文件返回 HTTP 400、连续请求没有重复加载模型,并记录单次延迟和内存占用。
部署环境选择应服从硬件与性能目标:通用 CPU 可优先使用 ONNX Runtime;NVIDIA GPU 且追求低延迟时可评估 TensorRT;Intel CPU 或边缘设备可评估 OpenVINO。先用统一测试集比较精度、延迟和资源占用,再决定是否更换推理后端。