
计算机视觉 / 系统课时
目标检测解决什么问题
目标检测解决什么问题
目标检测不仅要判断图像中有什么,还要指出目标出现在哪里。本课将通过分类、定位、检测和实例分割的对比,明确目标检测接收什么输入、产生什么输出,以及 YOLO 需要完成的核心任务。
学习目标
- 区分图像分类、目标定位、目标检测和实例分割
- 理解目标检测结果中的类别、位置与置信度
- 判断一个视觉需求是否属于目标检测问题
四类视觉任务的区别
面对一张包含猫和狗的图片,不同视觉任务关注的问题并不相同。
图像分类只回答“图片中主要是什么”,通常为整张图片输出一个类别,例如“猫”。它不关心目标位于图片的哪个位置,也不适合描述多个独立目标。
目标定位在分类基础上增加一个边界框,回答“是什么、在哪里”。这种任务通常假设图片中只有一个主要目标,因此只需要预测一个类别和一个矩形区域。
目标检测需要同时找出图片中的多个目标。每个目标都拥有自己的类别、边界框和置信度,例如检测出两个人、一辆汽车和一个交通信号灯。
实例分割比目标检测更精细。它不只用矩形框圈住目标,还要标出每个目标实际占据的像素区域,因此能够区分相互遮挡的同类物体。
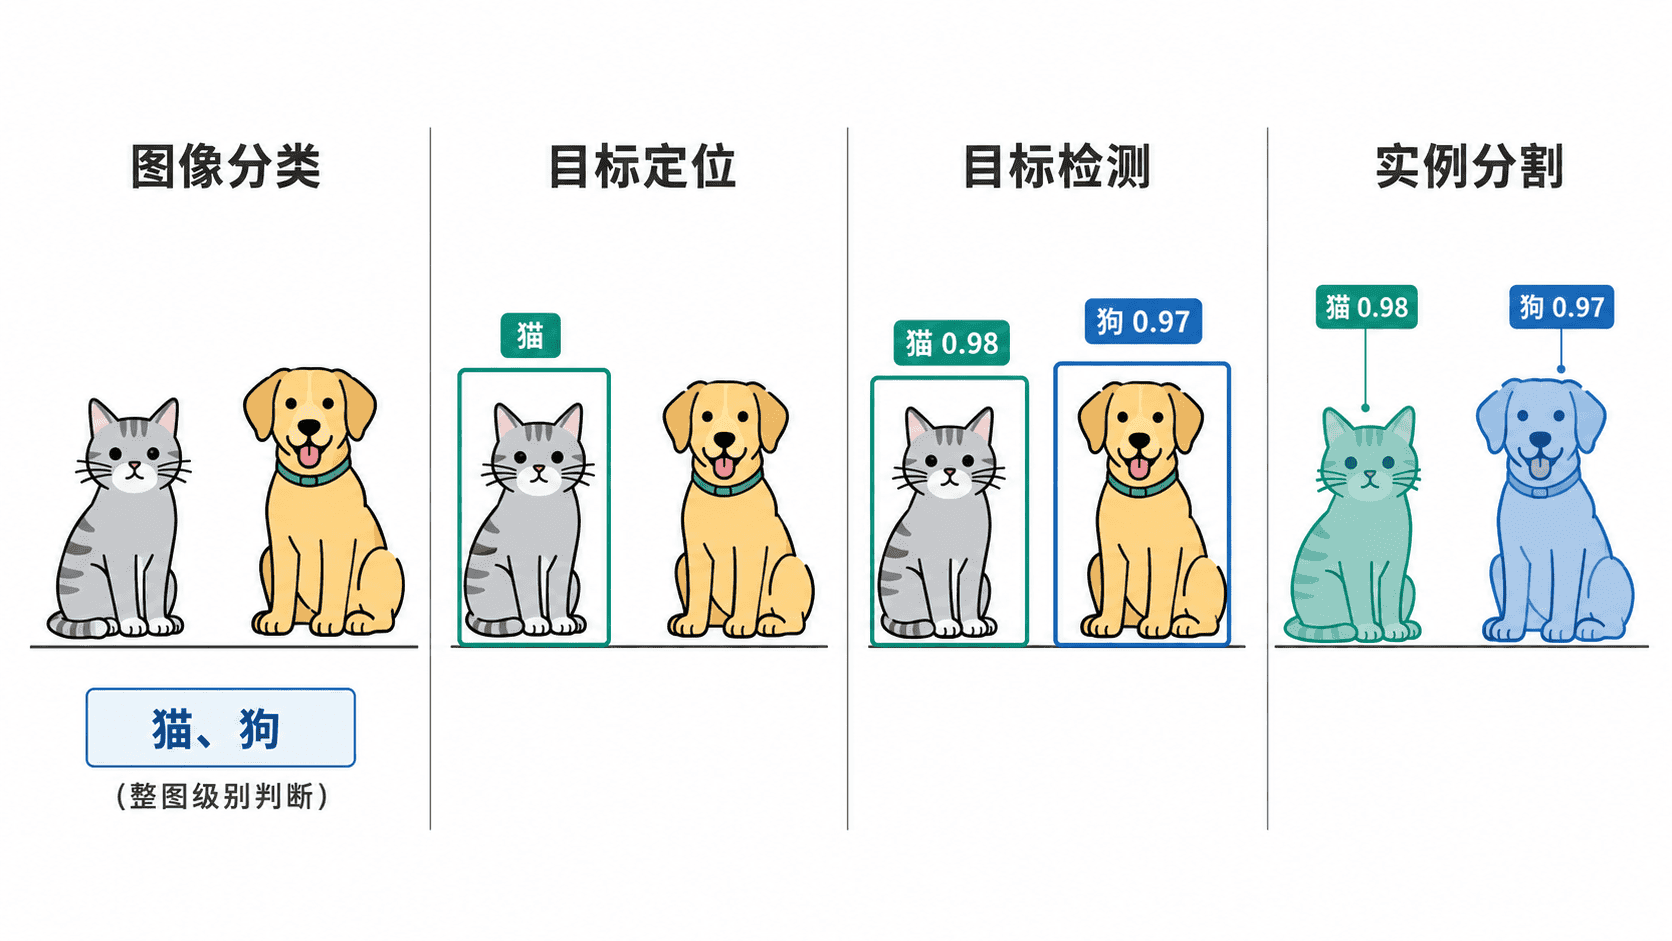
目标检测的输入与输出
目标检测模型的输入通常是一张图像,实际工程中也可以连续处理视频中的每一帧。图像进入模型前往往会被缩放到固定尺寸,并转换为模型能够计算的数值张量。
模型输出的是一组检测结果,而不是单一答案。每个结果至少包含以下三类信息:
- 类别:目标属于人、车辆、动物或其他哪一类
- 边界框:目标在图像中的矩形位置
- 置信度:模型对该检测结果的确信程度
边界框通常使用左上角和右下角坐标表示,也可以使用中心点、宽度和高度表示。无论采用哪种格式,它们描述的都是目标在原图中的空间范围。
例如,一张道路图片经过检测后,可能得到“汽车,置信度 0.93,位于图像中下方”和“行人,置信度 0.88,位于图像左侧”两条结果。后续系统可以据此绘制检测框、统计数量或触发业务规则。
YOLO 在其中承担的任务
YOLO 是一类单阶段目标检测方法。它的核心特点是一次处理整张图像,并直接预测多个目标的类别、位置和置信度,不需要先单独生成候选区域再逐个分类。
这里的“一次”主要描述模型的整体预测方式,并不意味着内部只有一次数学运算。图像仍会经过多层特征提取和预测计算,但最终可以在一次前向推理中得到完整检测结果。
模型输出后通常还要经过筛选,例如去除置信度过低的结果,并合并指向同一目标的重复边界框。经过这些处理,结果才会转换成用户看到的检测框和标签。
如何判断是否需要目标检测
当需求同时包含“识别目标”和“确定位置”时,通常需要目标检测。例如统计货架上有多少件商品、找到画面中的安全帽、识别道路上的车辆,都必须知道每个目标在哪里。
如果只需要判断整张图片是否合格,而不关心缺陷位置,图像分类可能已经足够。如果必须获得物体的精确轮廓、面积或像素级边界,则实例分割通常更合适。
选择任务类型时,应先确认业务最终使用的是整图标签、矩形位置,还是像素轮廓。任务定义不准确,即使模型指标很高,也可能无法解决实际问题。