
计算机视觉 / 系统课时
分类与置信度损失
分类与置信度损失
本课解决两个容易混淆的问题:模型为什么既要判断“这里有没有目标”,又要判断“目标属于哪一类”。学完后,你能看懂两类损失的监督对象、计算范围,以及它们在训练曲线中暴露的不同问题。
学习目标
- 区分类别预测与目标置信度各自负责的任务
- 理解正负样本对两类损失的贡献方式
- 能根据损失曲线初步判断标签、样本分配或训练参数问题
两类损失分别回答什么
在采用独立置信度分支的 YOLO 模型中,一个候选位置通常同时输出边界框、目标置信度和类别概率。目标置信度回答“这个位置是否承担一个真实目标”,类别概率回答“已经确认有目标后,它属于哪个类别”。
| 损失项 | 主要监督对象 | 常见计算范围 | 典型错误 |
|---|---|---|---|
| 置信度损失 | 有目标或无目标 | 正样本与大量负样本 | 背景被误判为目标,真实目标未被发现 |
| 分类损失 | 目标类别 | 通常只在正样本上计算 | 猫被判成狗,类别概率分布错误 |
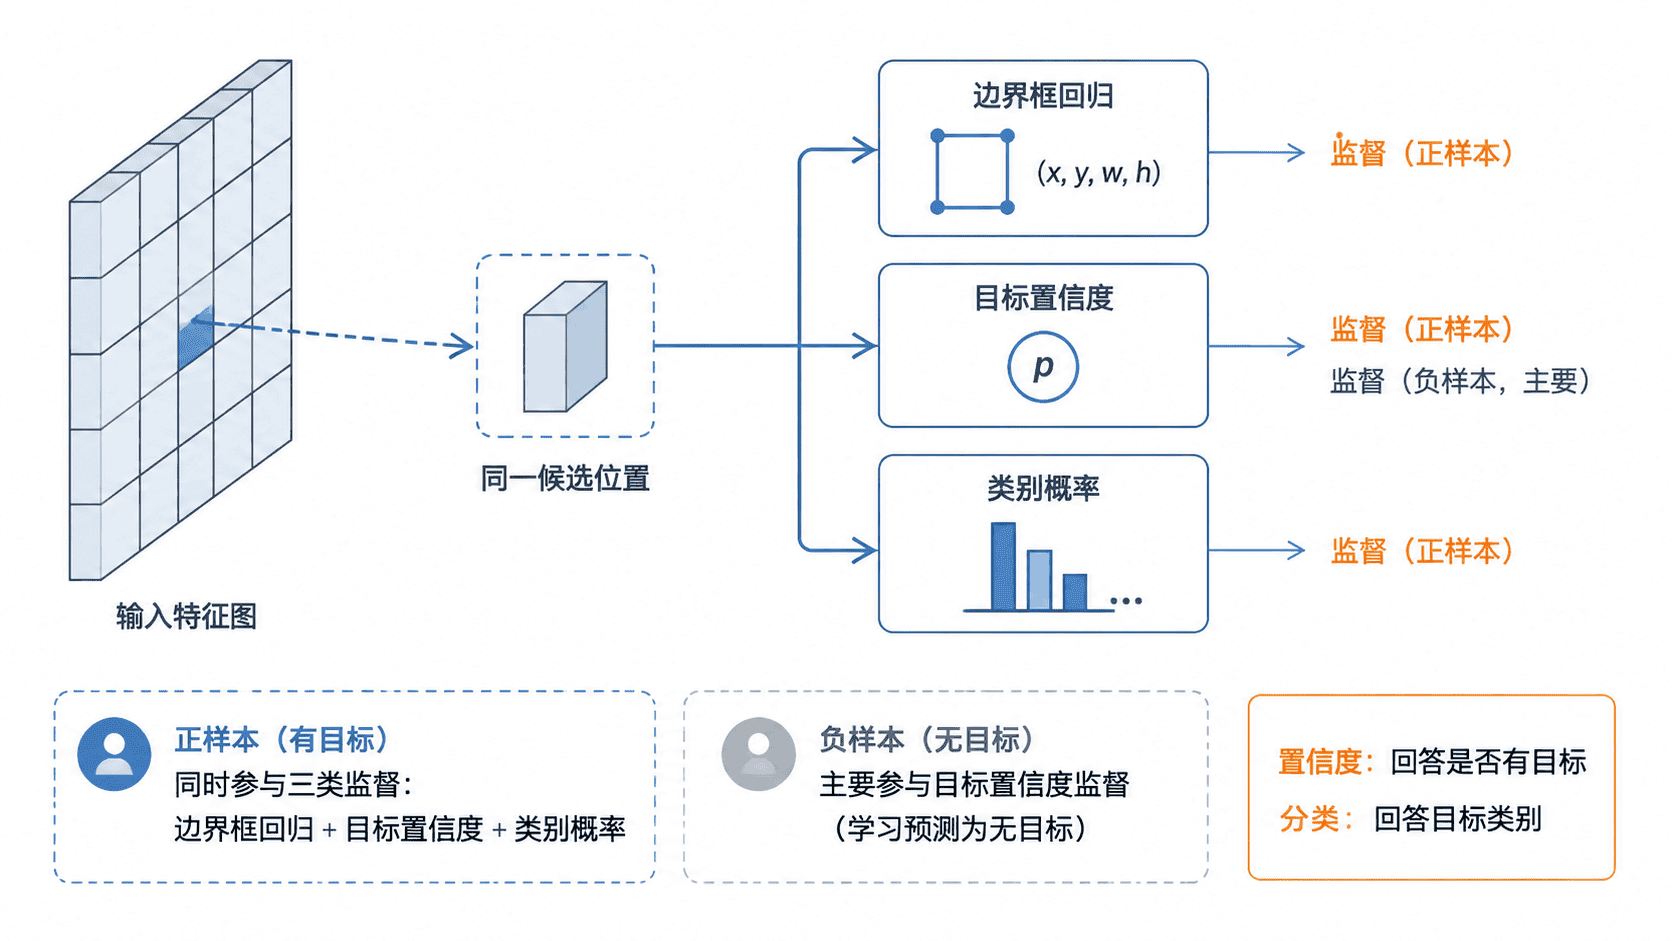
部分较新的实现会把目标质量、置信度或类别得分合并到同一分支中,但核心职责没有改变:模型仍需同时学习“目标是否可靠”和“类别是否正确”。
置信度损失如何工作
设模型输出目标置信度为 ,监督标签为 。正样本通常令 ,负样本令 ,二元交叉熵可写为:
正样本置信度过低会产生较大损失,负样本置信度过高也会被惩罚。由于背景候选通常远多于目标候选,训练时常通过正负样本权重、难例聚焦或忽略区域,避免大量简单背景淹没有效梯度。
分类损失如何工作
分类损失通常只对已分配到真实目标的正样本计算。若有 个类别,并使用逐类二元交叉熵,可表示为:
单标签数据常使用 one-hot 目标;允许一个目标同时属于多个类别时,可使用 multi-hot 目标。无论采用哪种编码,标签类别错误、类别索引错位和极端类别不平衡都会直接放大分类损失。
以一个正样本为例,若 ,真实类别概率为 ,则对应损失约为 和 。对一个负样本,若 ,置信度损失约为 ,通常不再计算分类损失。
多项损失如何共同训练
完整检测损失通常是多个子项的加权和:
权重并不是越大越好。某一项权重过高,会让优化器优先满足该任务,挤压其他分支的学习空间。调整前应先确认标签、类别映射和样本分配正确,再比较各项损失的量级与下降速度。
| 训练现象 | 优先排查方向 |
|---|---|
| 置信度损失长期偏高 | 漏标、正负样本分配不合理、背景过多 |
| 分类损失长期偏高 | 类别标注错误、类别相似、样本不均衡 |
| 两项同时剧烈波动 | 学习率过大、批次过小、数据异常 |
| 损失很低但指标仍差 | 评估类别映射、解码阈值和数据划分 |
常见误区
- 推理分数高不等于分类一定正确;常见实现还会把置信度与类别概率组合后再排序。
- 分类损失下降不代表漏检问题已经解决,漏检往往与置信度、框回归和样本分配共同相关。
- 看到某项损失数值更大,不能立即判定它更重要,还要结合权重、归一化方式和样本数量。
按自己的节奏,确认真正理解。