
计算机视觉 / 系统课时
过拟合与欠拟合
过拟合与欠拟合
过拟合和欠拟合都表现为模型效果不理想,但原因与处理方向相反。本课将通过训练集、验证集指标和损失曲线判断模型状态,并建立从现象到调整措施的排查顺序。
学习目标
- 能根据训练集与验证集差距判断模型状态
- 理解过拟合、欠拟合和正常收敛的典型曲线
- 能选择数据、模型规模或训练参数的调整方向
先看训练集与验证集差距
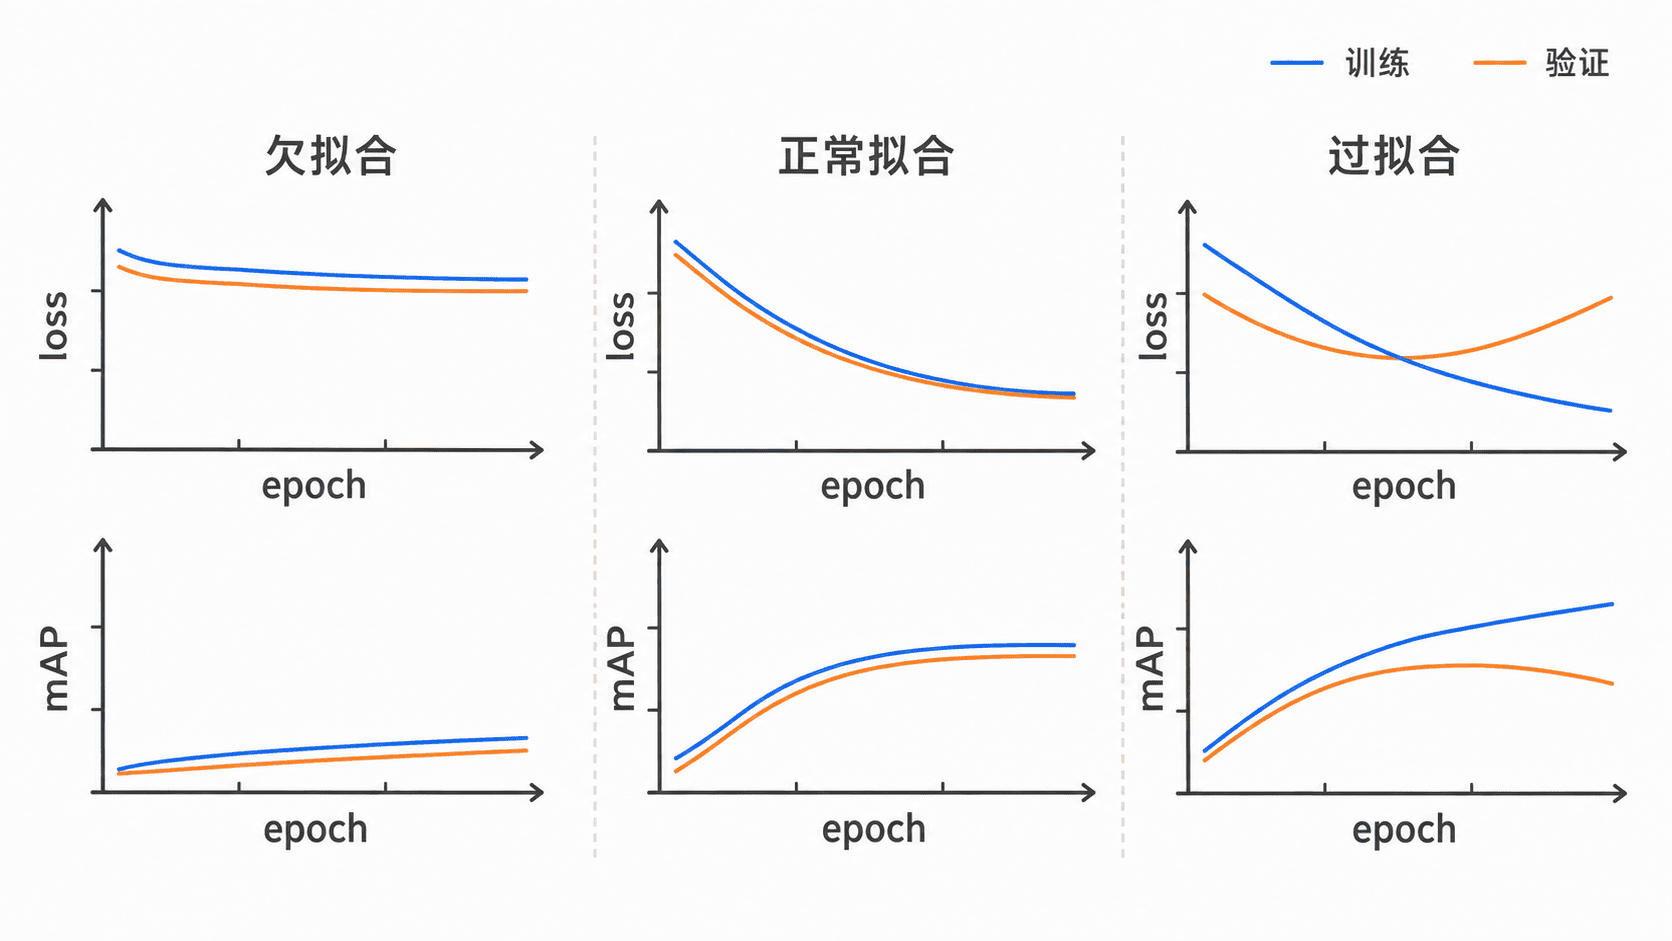
欠拟合表示模型连训练数据都没有学好。常见现象是训练损失和验证损失都较高,训练集与验证集的 mAP 同时偏低,而且随着训练继续仍改善有限。
过拟合表示模型在训练集上表现很好,但无法推广到未见样本。典型现象是训练损失继续下降,验证损失却开始上升;训练集 mAP 很高,验证集 mAP 明显落后。
正常收敛时,两组指标都会改善,验证集通常略差于训练集,但差距保持稳定。判断时不要只看单个 epoch,应观察一段连续趋势。
用简单规则辅助判断
下面的完整 Python 示例用训练损失、验证损失以及两者差距做初步分类。真实项目还应结合 mAP、精确率、召回率和曲线趋势。
def diagnose(train_loss, val_loss, min_acceptable_loss=0.30, gap_threshold=0.20):
    gap = val_loss - train_loss

    # 两边损失都高,优先判断为模型尚未学好
    if train_loss > min_acceptable_loss and val_loss > min_acceptable_loss:
        return "underfitting"

    # 训练损失较低,但验证损失明显更高,说明泛化差距较大
    if gap > gap_threshold:
        return "overfitting"

    return "reasonable_fit"

def main():
    samples = [
        (0.55, 0.60),
        (0.12, 0.45),
        (0.18, 0.24),
    ]

    for train_loss, val_loss in samples:
        result = diagnose(train_loss, val_loss)
        print(f"train={train_loss:.2f}, val={val_loss:.2f} -> {result}")

if __name__ == "__main__":
    main()
预期输出:
train=0.55, val=0.60 -> underfitting
train=0.12, val=0.45 -> overfitting
train=0.18, val=0.24 -> reasonable_fit
这段代码只是辅助理解,不能代替完整训练记录。阈值会随损失定义、数据规模和模型版本变化,实际值应通过多次实验确定。
过拟合时怎么调整
先检查训练集与验证集是否来自相同任务分布,以及是否存在重复图片或错误划分。数据划分无误后,优先增加有效数据或使用符合真实场景的数据增强。
若数据有限,可降低模型规模、减少训练轮数、增加权重衰减,或采用早停保存验证集表现最好的权重。强增强并非万能:若生成样本偏离真实场景,反而会增加学习难度。
欠拟合时怎么调整
先确认标注质量、类别编号、图像尺寸和损失是否正常。若数据管道没有问题,可以增加训练轮数、适当提高模型容量,或调整学习率,使模型获得足够的拟合能力。
学习率过高会导致损失震荡,过低则收敛缓慢。模型过小、输入分辨率不足或增强过强,也可能让训练集长期学不好,因此应一次只调整一个主要变量。
一套可执行的排查顺序
先画出训练与验证曲线,再找到验证指标最好的 epoch。随后判断训练集是否已经达到较高水平:若训练集也差,按欠拟合处理;若训练集好而验证集差,按过拟合处理。
每次实验应记录模型版本、数据集版本、随机种子、学习率、批大小和增强配置。没有可复现记录时,很难判断指标变化究竟来自哪项调整。
Tips:不要用测试集反复调参。验证集用于选择方案,测试集只用于最终一次独立评估。