
计算机视觉 / 系统课时
激活函数与归一化
激活函数与归一化
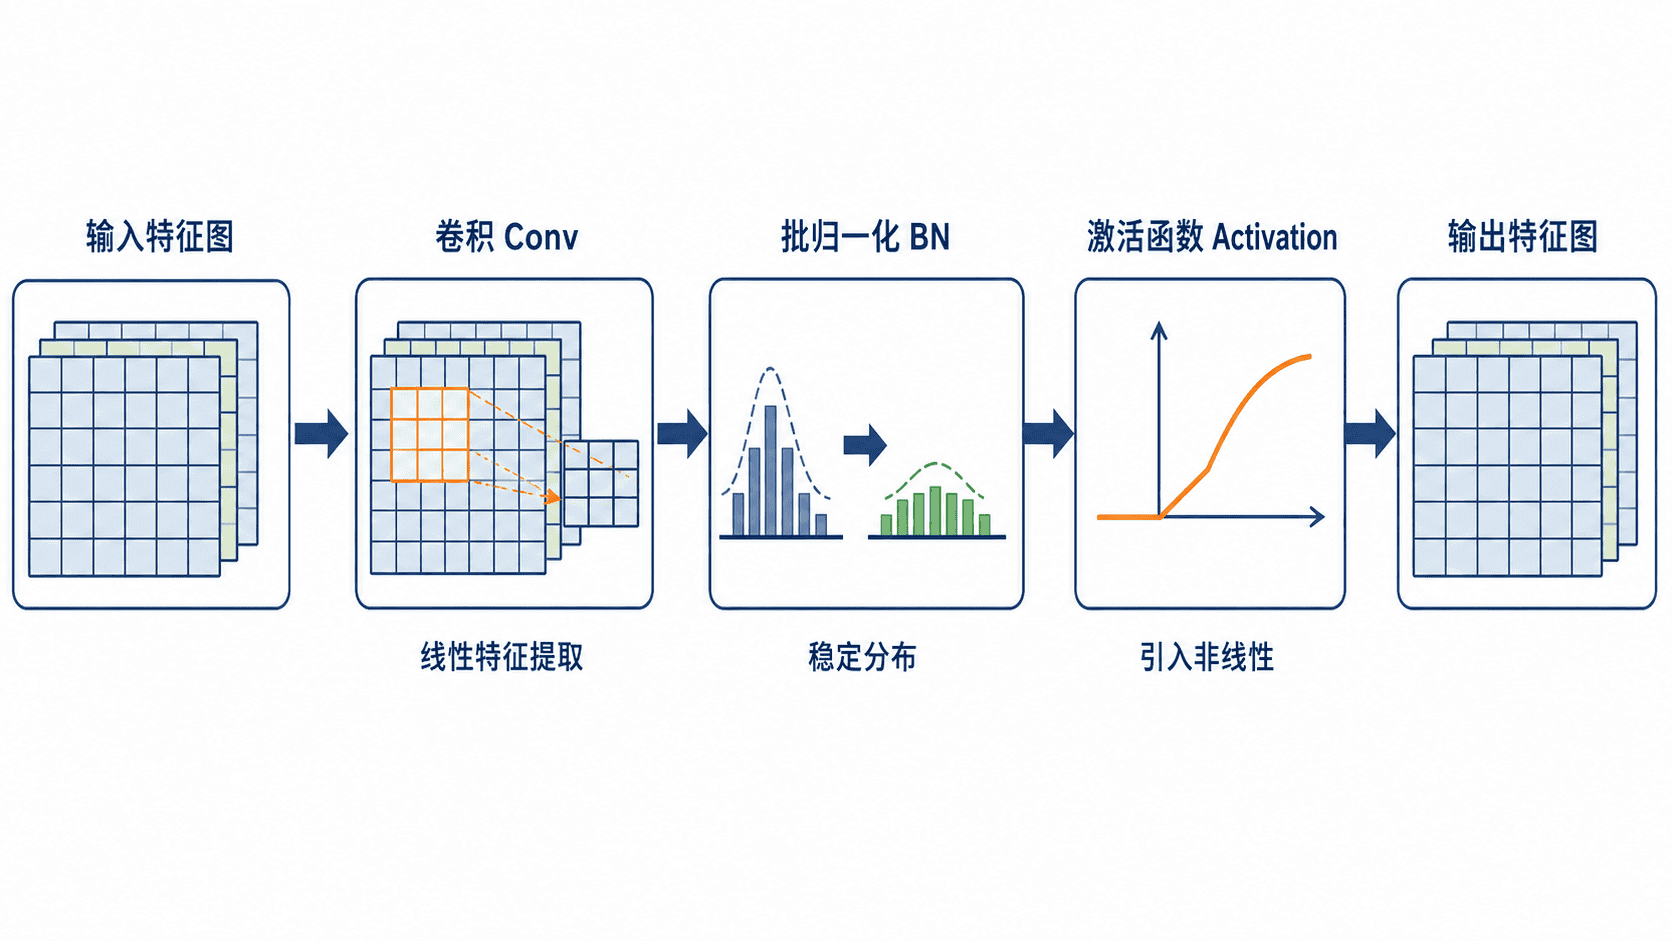
卷积层负责提取局部特征,但仅靠线性变换无法表达复杂目标。本课将说明激活函数如何引入非线性、批归一化如何稳定特征分布,以及二者在卷积模块中的典型排列方式。
学习目标
- 解释激活函数为什么能增强网络的表达能力
- 区分 ReLU、Leaky ReLU 与 SiLU 的主要特点
- 理解批归一化在训练和推理阶段的不同工作方式
为什么卷积后还需要激活
卷积本质上是加权求和,属于线性运算。若多层卷积之间没有激活函数,无论堆叠多少层,整体仍可合并成一次线性变换,网络就难以拟合边缘、纹理、形状与类别之间的复杂关系。
激活函数会对每个特征值进行非线性变换,使网络能够学习“某种模式出现时增强响应,未出现时抑制响应”这类更复杂的规则。
常见激活函数如何选择
| 激活函数 | 核心特点 | 需要注意 |
|---|---|---|
| ReLU | 计算简单,正区间梯度稳定 | 负区间输出恒为 0,部分神经元可能长期失活 |
| Leaky ReLU | 负区间保留小斜率 | 需要设置负区间斜率,曲线在 0 点不平滑 |
| SiLU | 输出平滑,小负值仍能传递梯度 | 计算量略高于 ReLU |
ReLU 可写为 。它速度快、实现简单,适合建立基础理解。Leaky ReLU 在负区间保留少量信息,能缓解神经元失活。SiLU 会根据输入大小平滑调整通过比例,常用于需要更细腻梯度变化的检测网络。
选择激活函数时,不应只比较单次计算速度,还要结合模型规模、训练稳定性和最终精度。阅读现有 YOLO 配置时,应以对应版本的网络定义为准,不要默认所有版本都使用同一种激活函数。
批归一化如何稳定训练
批归一化会在训练时根据当前小批次估计均值和方差,将特征调整到较稳定的尺度,再通过可学习参数恢复网络需要的平移与缩放能力。其核心变换可概括为:
这里的 用于避免方差过小时发生除零。归一化后,优化器面对的数值范围更稳定,通常可以使用更合适的学习率,并减少不同层之间尺度变化带来的训练震荡。
卷积模块中常见顺序是 Conv → BN → Activation。先卷积得到线性响应,再归一化其分布,最后通过激活函数引入非线性。若随意改变顺序,模型的训练行为和已有权重的含义都可能发生变化。
训练与推理为何不同
训练阶段的 BN 使用当前批次统计量,同时更新滑动均值与滑动方差。推理阶段通常不再依赖当前输入批次,而是使用训练期间累计的统计量,因此单张图片也能稳定预测。
当训练批次过小时,均值和方差估计容易波动,BN 的效果可能变差。迁移学习时若直接冻结主干网络,还要确认 BN 是继续更新统计量,还是切换到推理状态;两种做法会产生不同结果。
Tips:部署优化时,卷积与 BN 常可融合为一次等价计算,从而减少推理开销。融合只改变执行形式,不应改变模型输出含义。
常见错误
- 认为激活函数只是把负数变成 0,忽略其核心作用是引入非线性
- 在加载预训练权重后随意更换激活函数,导致网络结构与权重不匹配
- 用极小批次训练时忽略 BN 统计量不稳定,出现损失波动或精度下降
- 推理时仍让 BN 使用当前批次统计量,造成同一图片在不同批次中结果不一致