
计算机视觉 / 系统课时
模型结构总览
模型结构总览
一张图像进入 YOLO 后,会依次经过输入处理、特征提取、特征融合和检测预测。本课从完整数据流认识四个核心部分,建立阅读不同 YOLO 版本结构图所需的统一框架。
学习目标
- 说清输入端、主干网络、特征融合网络和检测头的职责
- 理解不同分辨率特征图在目标检测中的作用
- 能沿着数据流阅读一张 YOLO 模型结构图
一次前向传播经过什么
YOLO 的主体通常可以概括为输入端、Backbone、Neck 和 Head。图像先被整理为模型能够接收的张量,随后提取多层视觉特征,再融合不同尺度的信息,最终输出候选框、类别和置信度。
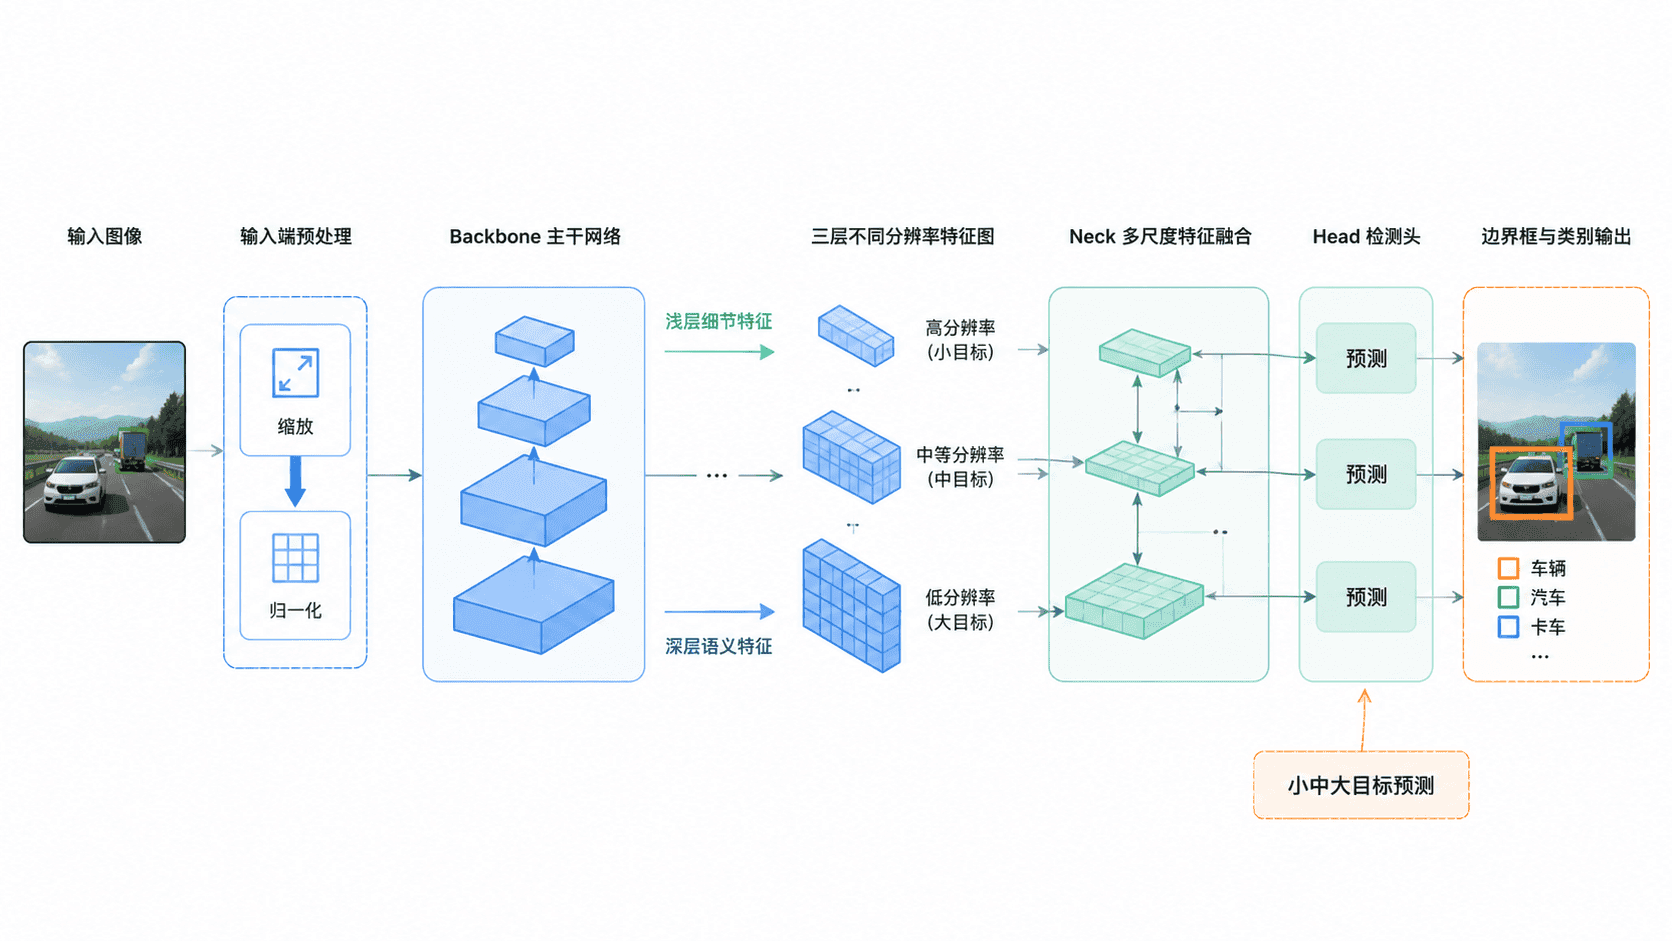
这四部分是理解模型结构的主线。不同 YOLO 版本会更换卷积模块、融合方式或检测头设计,但整体任务分工通常保持一致。
输入端整理图像
输入端负责将原始图片转换为尺寸和格式统一的张量。常见操作包括缩放、保持比例填充、像素归一化以及组合批次。训练阶段还可能执行翻转、颜色变化或拼接等数据增强。
例如,模型输入尺寸为 640×640 时,长宽比例不同的原图通常不会被直接拉伸,而是等比例缩放后补边。这样可以减少目标形状失真,并保证同一批图像具有一致尺寸。
输入端只负责准备数据,不负责判断图中有什么目标。处理后的张量会被交给主干网络继续计算。
Backbone 提取多层特征
Backbone 是模型的特征提取器。图像经过连续的卷积、下采样和特征变换后,空间尺寸逐渐减小,通道数量通常逐渐增加。
较浅层的特征图分辨率高,保留边缘、纹理和位置信息,适合描述小目标。较深层的特征图分辨率低,但感受野更大,能够表达物体类别和整体形状等高级语义。
以 640×640 输入为例,主干网络可能输出步长分别为 8、16 和 32 的三层特征图。
| 特征层 | 特征图尺寸 | 主要价值 |
|---|---|---|
| P3 | 80×80 | 保留较多位置细节,适合小目标 |
| P4 | 40×40 | 平衡位置细节与语义信息 |
| P5 | 20×20 | 感受野较大,适合大目标 |
这里的具体名称和尺寸可能随模型版本变化,但“浅层更精细、深层语义更强”的规律保持不变。
Neck 融合不同尺度
单独使用浅层特征时,目标位置清楚但类别语义不足;单独使用深层特征时,语义较强但细节可能已经丢失。Neck 的作用就是在不同层之间传递并融合信息。
常见融合结构会将深层特征上采样,与较浅层特征拼接或相加,再通过自顶向下和自底向上的路径继续聚合。这样得到的每个输出层都同时拥有一定的定位细节和语义信息。
FPN、PAN 等名称描述的是不同的融合路径。初学时不必先记住所有模块名称,应优先观察特征从哪一层流向哪一层,以及融合前后尺寸是否一致。
Head 输出检测结果
Head 接收 Neck 输出的多尺度特征,并在每个空间位置预测检测信息。典型输出包括边界框位置、目标置信度和类别分数,部分版本还会预测分布形式的边界框距离。
不同尺度的检测头负责不同大小的目标:高分辨率特征层更容易发现小目标,低分辨率特征层则更适合覆盖大目标。多个检测头的结果会被汇总、解码,再经过置信度过滤和非极大值抑制得到最终检测框。
有些模型采用耦合检测头,在同一分支中预测分类和定位;另一些模型采用解耦检测头,为分类与边界框回归设置独立分支。两者结构不同,但最终都需要回答“目标在哪里”和“目标是什么”。
阅读结构图的方法
阅读一张陌生的 YOLO 结构图时,可以先忽略模块内部细节,只沿箭头确认四件事:输入尺寸如何变化、Backbone 输出了几层特征、Neck 如何连接这些特征,以及 Head 在哪些尺度上进行预测。
当结构图中出现拼接操作时,还要检查参与融合的特征图空间尺寸是否一致。若尺寸不同,通常会先经过上采样或下采样。掌握这条数据流后,再学习具体卷积模块会更容易。