
计算机视觉 / 系统课时
YOLO 模型的发展脉络
YOLO 模型的发展脉络
本课不按版本逐个背诵参数,而是抓住 YOLO 演进中反复出现的四条主线:网络结构、检测头、标签分配和训练策略。学完后,你能够看懂不同 YOLO 版本为什么更快、更准,以及它们之间哪些变化属于真正的设计升级。
学习目标
- 说清 YOLO 系列在骨干网络、特征融合和检测头上的主要变化
- 理解锚框、无锚框与标签分配策略之间的关系
- 建立比较不同 YOLO 版本时可复用的分析框架
不要把版本号当成单一路线
YOLO 从 2016 年提出后,逐渐形成多个团队并行推进的生态。部分版本来自论文作者团队,部分来自开源社区或工程团队,因此编号并不代表同一套代码持续升级。学习时应关注设计思想,而不是简单认为“数字越大,所有方面都越好”。
可以把发展过程看成四个持续优化的问题:怎样提取更有效的特征,怎样融合不同尺度的信息,怎样输出类别与边界框,以及怎样让正负样本分配更合理。
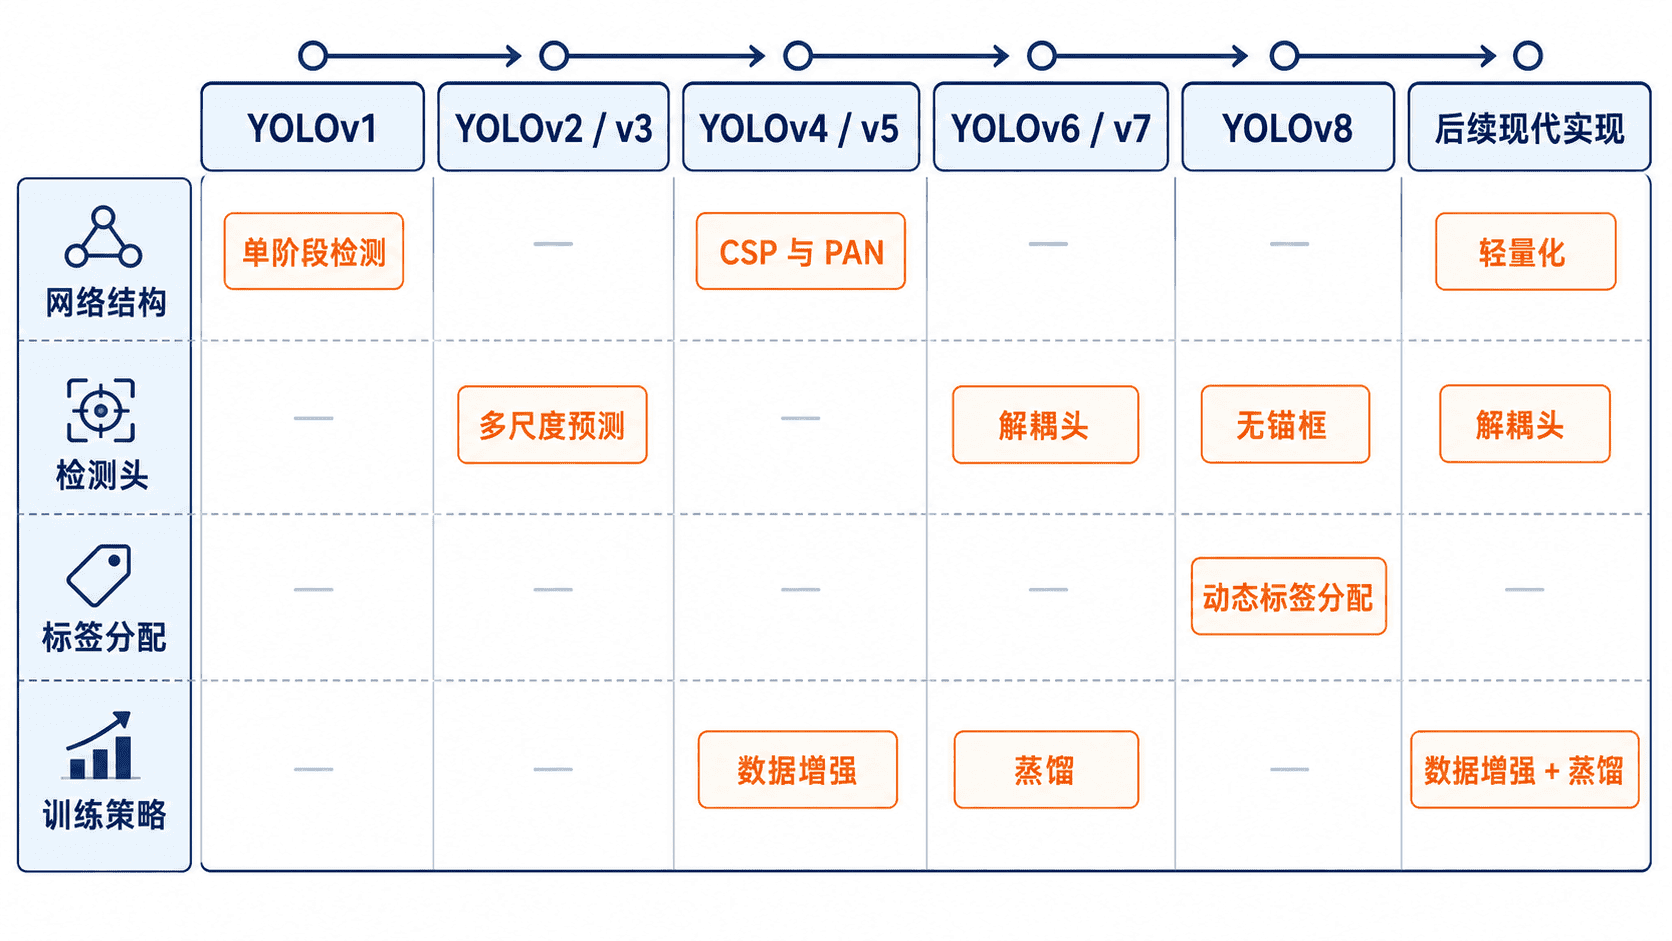
网络结构从单尺度走向高效多尺度
YOLOv1 直接在单个特征图上完成预测,速度很快,但对小目标和密集目标不够友好。后续版本引入更深的骨干网络,并在多个尺度上预测,让大目标、小目标都能获得合适的感受野。
再往后,CSP、PAN、SPP 等结构被广泛采用。骨干网络负责提取语义,颈部网络负责融合高层语义与低层细节,目标是在不过度增加计算量的前提下,让不同尺度的特征充分交换。
因此,比较两个模型时不能只看骨干网络深不深,还要同时观察特征融合路径、输入分辨率和计算量。更复杂的结构可能提高精度,也可能增加延迟和显存占用。
检测头从耦合预测走向解耦与无锚框
早期 YOLO 通常在同一组卷积输出中同时预测类别、置信度和边界框,这称为耦合检测头。分类与定位的优化目标并不完全一致,现代实现常将两条分支拆开,形成解耦头,使各自学习更稳定。
锚框方案会预先定义若干宽高模板,模型预测目标相对模板的偏移。它能提供明确先验,但需要聚类、匹配和调参。无锚框方案则直接预测目标中心、边界距离或坐标,减少先验设计,部署和迁移通常更简洁。
“无锚框”不等于没有候选点,也不等于一定更准确。它只是改变边界框表示与样本匹配方式,最终效果仍取决于网络、损失函数和训练数据。
标签分配从固定规则走向动态匹配
检测训练必须决定哪些预测负责学习某个真实目标。早期方法常依据 IoU 阈值、中心位置或最佳锚框进行固定匹配,规则直观,但可能造成正样本过少,或让不合适的预测承担学习任务。
动态标签分配会结合分类质量、定位质量和候选位置,在训练过程中选择更合适的正样本。常见思路包括动态计算匹配代价、为不同目标分配不同数量的正样本,以及让分类分数体现定位质量。
这一变化的本质,是从“按预设规则指定答案”转向“根据当前预测质量选择更合适的监督对象”。它通常能改善收敛,但也让训练逻辑更复杂。
训练策略逐渐成为性能核心
现代 YOLO 的提升不只来自网络结构。Mosaic、MixUp、随机缩放、颜色扰动等数据增强可以扩大训练分布;余弦学习率、指数滑动平均、标签平滑和更合理的损失函数可以提升稳定性。
一些版本还会使用知识蒸馏、辅助训练头、自动超参数搜索或训练后重参数化。它们可能在不改变最终推理结构的情况下提高精度,因此仅查看推理网络,无法完整解释模型表现。
实际选型时,应把“训练配方”和“部署结构”分开比较。一个模型训练成本更高,不代表推理一定更慢;反之,轻量模型也可能依赖较强的数据增强才能达到理想效果。