
计算机视觉 / 系统课时
精确率与召回率
精确率与召回率
目标检测模型输出很多候选框,但“检测出了多少目标”和“检测结果有多可信”是两个不同问题。本课通过真正例、假正例和假负例建立判断标准,并用精确率与召回率分别衡量误报和漏报。
学习目标
- 能根据预测框与真实框的匹配结果判断 TP、FP 和 FN
- 能计算精确率与召回率,并解释两个指标的实际含义
- 能结合业务代价判断应优先降低误报还是漏报
从检测结果得到三类统计量
评估目标检测结果时,需要先设定类别匹配规则和 IoU 阈值。某个预测框只有在类别正确、与真实框的 IoU 达到阈值,并且该真实框尚未被其他高置信度预测框匹配时,才记为真正例。
- 真正例 TP:预测出了目标,而且类别和位置都满足匹配要求。
- 假正例 FP:模型给出了预测框,但类别错误、位置偏差过大,或重复检测了同一个目标。
- 假负例 FN:图像中存在真实目标,但没有任何合格预测框与之匹配。
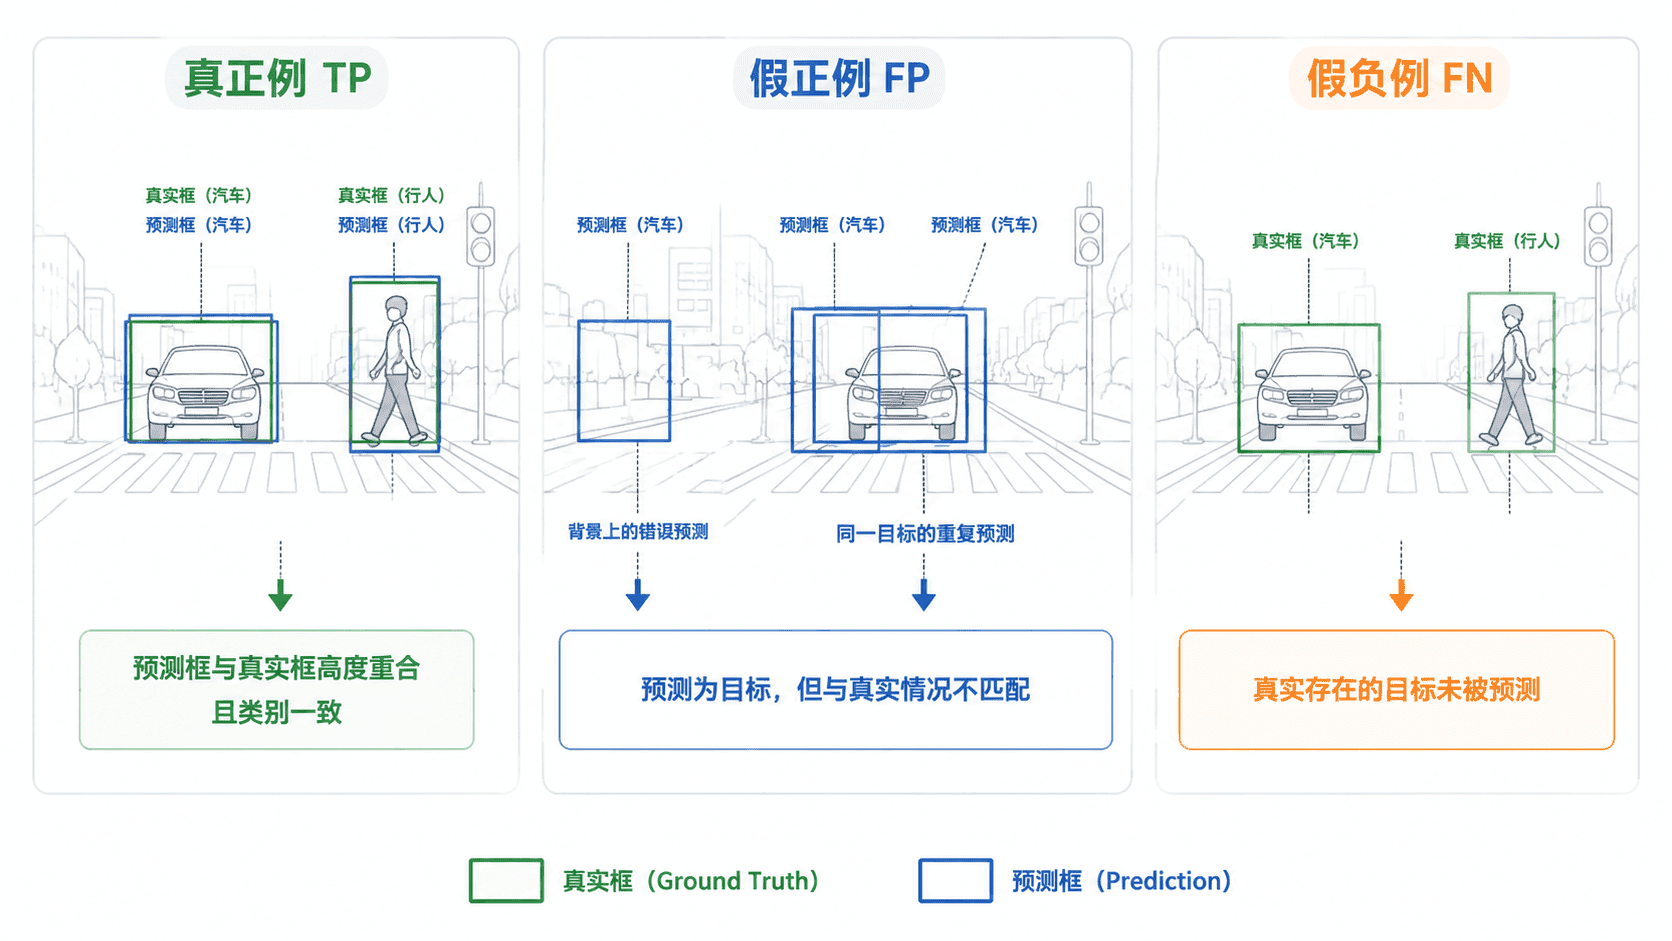
目标检测通常不会单独统计真正例、假正例和假负例,而是先按照置信度从高到低处理预测框。若多个预测框都覆盖同一个真实目标,通常只有第一个合格匹配记为 TP,其余重复框记为 FP。
精确率衡量预测结果是否可信
精确率只观察模型已经预测为目标的结果,其中有多少确实正确:
假设模型输出了 100 个检测框,其中 80 个正确、20 个错误,那么精确率为 ,即 80%。精确率越高,说明误报越少,用户看到的检测结果越可信。
在自动闸机、人脸登录或缺陷拦截等场景中,错误识别可能直接触发错误操作,因此通常需要重点关注精确率。不过,模型也可能通过减少预测数量获得较高精确率,此时仍需检查是否漏掉了大量目标。
召回率衡量真实目标是否被找到
召回率从全部真实目标出发,衡量其中有多少被模型成功检测:
假设图像中共有 100 个真实目标,模型正确检测出 80 个,还有 20 个没有被找到,那么召回率为 ,即 80%。召回率越高,说明漏报越少。
在火灾烟雾检测、医学病灶筛查或道路障碍物检测中,漏掉一个目标的代价可能远高于多产生一次复核,因此常常优先保证召回率,再通过后续规则减少误报。
置信度阈值如何影响两个指标
模型通常只保留置信度高于阈值的预测框。提高阈值会删除更多低置信度框,往往减少 FP,使精确率上升,但也可能把原本正确的低置信度框删除,导致 FN 增多、召回率下降。
降低阈值则会保留更多候选框,通常能够找回部分目标并提高召回率,但新增预测中可能包含更多错误框,使精确率下降。因此,精确率与召回率不能脱离置信度阈值单独理解。
| 阈值调整 | 常见变化 | 主要风险 |
|---|---|---|
| 提高置信度阈值 | 预测更谨慎,精确率可能提高 | 漏报增加,召回率可能下降 |
| 降低置信度阈值 | 保留更多目标,召回率可能提高 | 误报增加,精确率可能下降 |
具体变化并非绝对,因为它还取决于模型的置信度排序质量,但上述趋势是阅读检测结果时的重要直觉。
指标解读示例
某检测任务共有 50 个真实目标。模型输出 45 个预测框,其中 40 个正确匹配,5 个属于误报,另有 10 个真实目标未被检测到。此时 、、。
精确率为 ,表示模型给出的检测框大多可信;召回率为 ,表示每 100 个真实目标大约有 20 个会被漏掉。只报告其中一个指标,无法完整说明模型表现。