
计算机视觉 / 系统课时
检查与划分数据集
检查与划分数据集
本课完成训练前最关键的数据门禁:检查图像能否读取、标签格式是否有效、样本是否重复,并按固定随机种子生成训练集、验证集和测试集。完成后,你将得到可追溯的划分文件和一份可直接运行的检查脚本。
学习目标
- 发现损坏图像、缺失标签和越界标注
- 理解训练集、验证集与测试集的职责
- 使用脚本完成确定性划分并检查类别分布
检查质量并阻断数据泄漏
数据检查应先于训练。图像至少要能被解码,标签文件要与图像同名,YOLO 标签每行必须包含 class_id x_center y_center width height 五个字段,后四项通常归一化到 0~1。
空标签文件可以表示“图像中没有目标”,但缺失标签文件通常意味着数据不完整。重复图像也要提前处理:同一画面若同时进入训练集和测试集,会让测试指标虚高,却不能代表模型对新场景的泛化能力。
检查顺序应固定为“文件配对 → 图像可读性 → 标签字段 → 坐标范围 → 重复样本 → 类别统计”。发现严重错误时应停止划分,而不是让训练过程自行忽略。
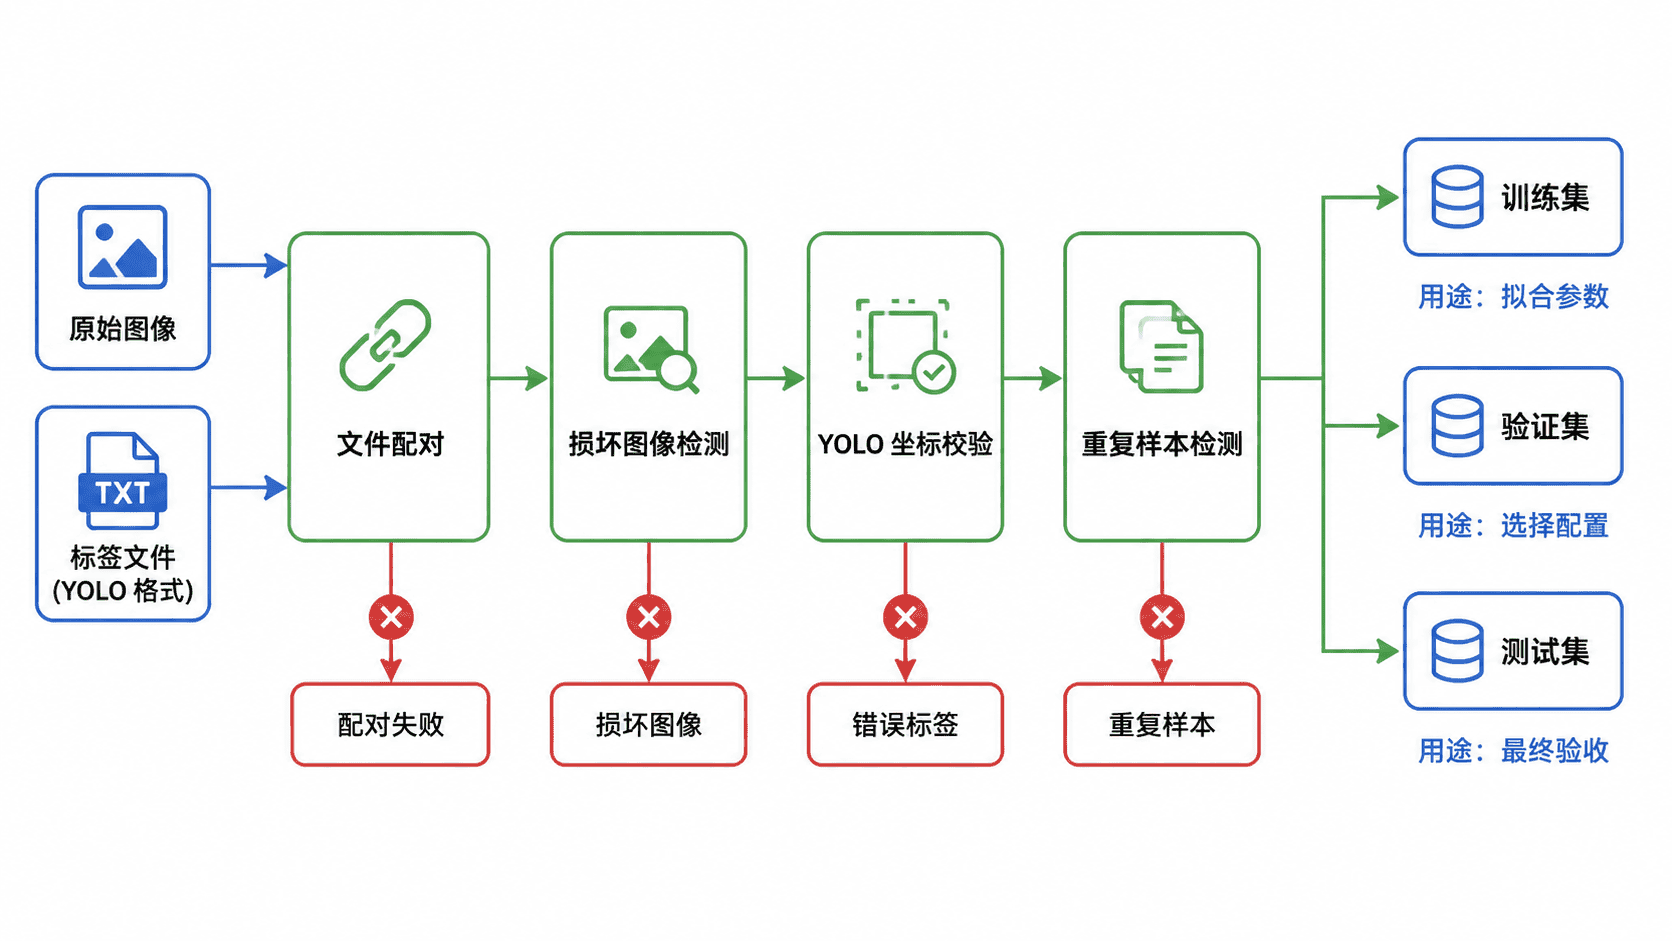
划分规则与数据职责
常见比例是 80% 训练集、10% 验证集、10% 测试集。训练集用于更新模型参数,验证集用于选择超参数和早停轮次,测试集只在方案确定后进行最终验收。
| 数据集 | 主要用途 | 是否参与调参 |
|---|---|---|
| 训练集 | 学习模型参数 | 是 |
| 验证集 | 选择模型和超参数 | 是 |
| 测试集 | 最终评估泛化能力 | 否 |
划分前应先去重,并尽量让不同场景、设备和类别在三个集合中都有代表性。连续视频抽帧时不能逐帧随机划分,应按视频、拍摄批次或场景分组,否则相邻画面会跨集合造成泄漏。
自动检查和划分
下面脚本假设图像位于 data/images/all,标签位于 data/labels/all,类别数为 3。它会验证图像、标签和重复文件,只有全部通过后才写出三个划分清单。
from collections import Counter
from hashlib import sha256
from pathlib import Path
import random

from PIL import Image

IMAGE_DIR = Path('data/images/all')
LABEL_DIR = Path('data/labels/all')
SPLIT_DIR = Path('data/splits')
CLASS_COUNT = 3
SEED = 42
IMAGE_SUFFIXES = {'.jpg', '.jpeg', '.png', '.bmp'}

def file_hash(path: Path) -> str:
    digest = sha256()
    with path.open('rb') as file:
        for chunk in iter(lambda: file.read(1024 * 1024), b''):
            digest.update(chunk)
    return digest.hexdigest()

def check_label(path: Path) -> tuple[list[int], list[str]]:
    classes: list[int] = []
    errors: list[str] = []

    for line_no, line in enumerate(path.read_text(encoding='utf-8').splitlines(), 1):
        if not line.strip():
            continue

        parts = line.split()
        if len(parts) != 5:
            errors.append(f'{path}:{line_no} 字段数不是 5')
            continue

        try:
            class_id = int(parts[0])
            x, y, width, height = map(float, parts[1:])
        except ValueError:
            errors.append(f'{path}:{line_no} 存在非数字字段')
            continue

        if not 0 <= class_id < CLASS_COUNT:
            errors.append(f'{path}:{line_no} 类别编号越界')
        if not all(0 <= value <= 1 for value in (x, y, width, height)):
            errors.append(f'{path}:{line_no} 坐标未归一化')
        if width <= 0 or height <= 0:
            errors.append(f'{path}:{line_no} 宽高必须大于 0')

        classes.append(class_id)

    return classes, errors

def main() -> None:
    images = sorted(
        path for path in IMAGE_DIR.iterdir()
        if path.suffix.lower() in IMAGE_SUFFIXES
    )
    if not images:
        raise SystemExit(f'未找到图像:{IMAGE_DIR}')

    issues: list[str] = []
    valid_images: list[Path] = []
    image_classes: dict[Path, list[int]] = {}
    seen_hashes: dict[str, Path] = {}

    for image_path in images:
        try:
            with Image.open(image_path) as image:
                image.verify()
        except Exception as exc:
            issues.append(f'{image_path} 无法读取:{exc}')
            continue

        digest = file_hash(image_path)
        if digest in seen_hashes:
            issues.append(f'{image_path} 与 {seen_hashes[digest]} 内容重复')
            continue
        seen_hashes[digest] = image_path

        label_path = LABEL_DIR / f'{image_path.stem}.txt'
        if not label_path.exists():
            issues.append(f'{image_path} 缺少标签文件')
            continue

        classes, label_errors = check_label(label_path)
        issues.extend(label_errors)
        valid_images.append(image_path)
        image_classes[image_path] = classes

    if issues:
        print('检查失败:')
        for issue in issues:
            print(f'- {issue}')
        raise SystemExit(1)

    random.Random(SEED).shuffle(valid_images)
    total = len(valid_images)
    train_end = int(total * 0.8)
    val_end = train_end + int(total * 0.1)
    splits = {
        'train': valid_images[:train_end],
        'val': valid_images[train_end:val_end],
        'test': valid_images[val_end:],
    }

    SPLIT_DIR.mkdir(parents=True, exist_ok=True)
    for name, items in splits.items():
        output = SPLIT_DIR / f'{name}.txt'
        output.write_text(
            '\n'.join(path.as_posix() for path in items) + '\n',
            encoding='utf-8',
        )
        counts = Counter(
            class_id
            for path in items
            for class_id in image_classes[path]
        )
        print(f'{name}: {len(items)} images, classes={dict(sorted(counts.items()))}')

    print(f'检查通过,划分文件已写入 {SPLIT_DIR}')

if __name__ == '__main__':
    main()
先安装 Pillow,再运行脚本。将 check_and_split.py 替换为实际保存路径。
python -m pip install pillow
python check_and_split.py
预期输出
train: <TRAIN_COUNT> images, classes={<CLASS_COUNTS>}
val: <VAL_COUNT> images, classes={<CLASS_COUNTS>}
test: <TEST_COUNT> images, classes={<CLASS_COUNTS>}
检查通过,划分文件已写入 data/splits<TRAIN_COUNT>、<VAL_COUNT>、<TEST_COUNT> 和 <CLASS_COUNTS> 会随数据集变化。若脚本输出“检查失败”,应先修复对应文件再重新执行;若某个稀有类别未出现在验证集或测试集,需要按类别和场景手动调整划分,同时保持测试集不参与后续调参。