
计算机视觉 / 系统课时
类别概率与置信度
类别概率与置信度
本课解决“检测框旁边的分数到底表示什么”这一常见困惑。你将区分类别预测、目标存在概率和最终检测置信度,理解它们的组合方式,并能解释分数阈值为什么会同时影响漏检与误检。
学习目标
- 区分类别概率、目标存在概率和最终置信度
- 理解检测分数的组合与筛选过程
- 判断调高或调低阈值带来的结果变化
一个预测包含哪些分数
YOLO 的一个预测通常不仅包含边界框坐标,还包含“这里是否有目标”的分数,以及各类别的预测分数。不同版本在输出形式和训练实现上可能不同,但理解时可以拆成三个层次:
- 目标存在概率:当前位置是否包含一个可检测目标
- 类别概率:在存在目标的前提下,它属于某个类别的可能性
- 最终检测置信度:该框作为某一类别结果被保留时使用的综合分数
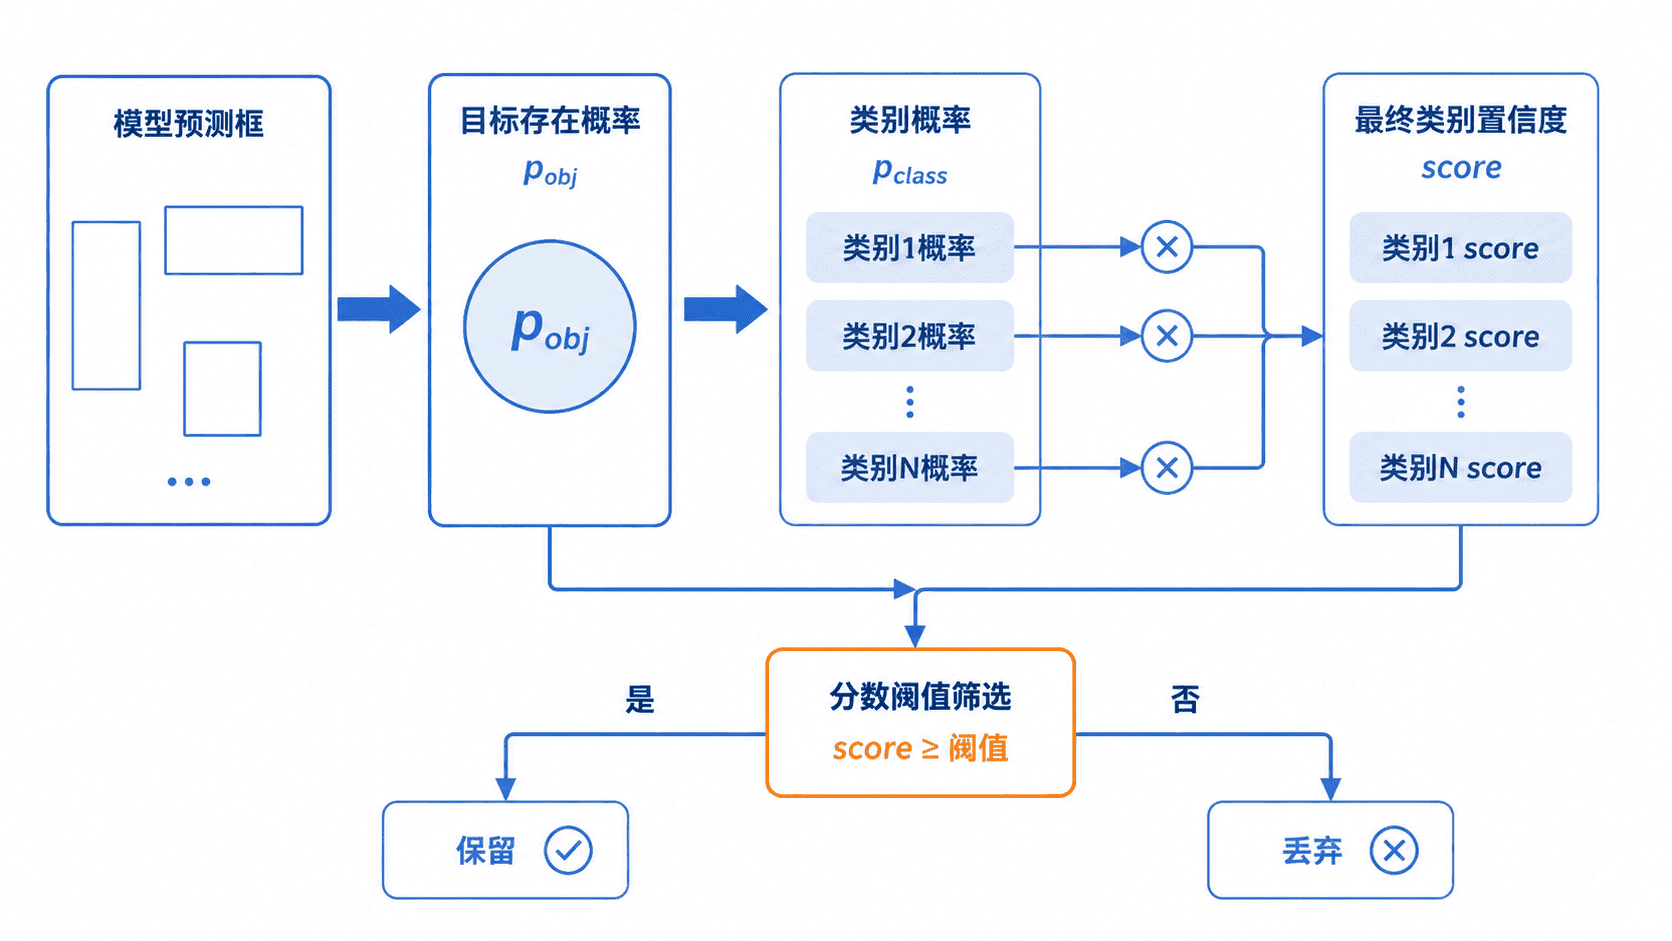
在常见的解释模型中,类别 的最终分数可写为:
其中 表示目标存在概率, 表示该类别的预测概率。这个乘法体现了两层判断:模型既要相信框里有目标,也要相信它属于指定类别。
为什么不能只看类别概率
假设某个预测的目标存在概率为 0.2,类别“猫”的概率为 0.9。虽然类别概率很高,但最终分数只有 。这说明模型在“如果有目标,它像猫”这一点上较确定,却不相信该位置真的存在目标。
反过来,若目标存在概率为 0.95,而“猫”的类别概率为 0.4,最终分数为 0.38。模型相信这里有东西,但对类别判断不够确定。两种情况的最终分数都不会很高,只是原因不同。
因此,排查低置信度问题时要先判断低分来自目标性不足,还是类别区分不清。前者常与目标过小、遮挡或背景复杂有关,后者常与类别相似、数据不平衡或标注质量有关。
分数阈值如何工作
推理阶段通常先计算每个预测框的类别分数,再删除低于阈值的结果。阈值越高,保留下来的框越少,结果更“谨慎”;阈值越低,召回更多候选框,但误检和重复框也会增加。
| 阈值设置 | 主要效果 | 常见风险 |
|---|---|---|
| 较高 | 减少低质量预测和误检 | 小目标、遮挡目标更容易漏检 |
| 较低 | 提高召回率,保留更多候选 | 误检增多,后处理压力变大 |
| 适中 | 在精确率与召回率之间折中 | 仍需结合业务验证 |
阈值没有适用于所有场景的固定答案。安全巡检可能更重视少漏检,因此会适当降低阈值;自动结算或高风险告警更怕误报,则可能提高阈值,并增加人工复核条件。
置信度与 NMS 的关系
分数阈值负责先删除明显不可靠的预测,非极大值抑制 NMS 再处理同一目标附近的重复框。NMS 通常按照置信度从高到低排序,并依据框之间的 IoU 删除重叠度过高的低分框。
这两个阈值作用不同:置信度阈值判断“这个预测是否值得进入候选集”,NMS 的 IoU 阈值判断“两个候选框是否可能指向同一个目标”。调参时必须分开理解,不能用提高置信度阈值来完全替代 NMS。
多类别输出的边界
一个预测框可能同时对多个类别给出分数。若任务允许多标签,同一框可以保留多个类别;若任务采用单标签逻辑,通常选择分数最高的类别。具体行为取决于模型输出、后处理实现和业务规则。
还要注意,工程界面上显示的“confidence”未必总是原始的 。许多推理框架直接展示最终类别分数,因此阅读模型结果或接口字段时,应先确认该字段的定义。
同样是 0.8,不同框架中的含义可能不同。比较模型前,应确认分数是否经过类别组合、归一化或后处理。