
计算机视觉 / 系统课时
AP 与 mAP
AP 与 mAP
单个置信度阈值只能给出一组精确率和召回率,无法完整反映模型从谨慎预测到积极预测时的整体表现。本课将通过 PR 曲线理解 AP 的面积含义,并掌握 mAP 在多类别和多 IoU 阈值评估中的计算方式。
学习目标
PR 曲线如何形成
模型会为每个预测框输出置信度。评估时先按置信度从高到低排列预测框,再逐步降低保留阈值。每加入一个预测框,就重新累计 TP 和 FP,并计算一次精确率与召回率。
当阈值较高时,模型只保留最有把握的预测,精确率通常较高,但召回率较低。随着阈值下降,更多预测框被纳入,召回率通常逐步提高,精确率则可能因为误报增加而波动或下降。
把每个阈值对应的召回率作为横坐标、精确率作为纵坐标,就得到 Precision-Recall 曲线,简称 PR 曲线。理想曲线应尽量靠近图像的右上方,表示模型既能找到大多数目标,又能保持较少误报。
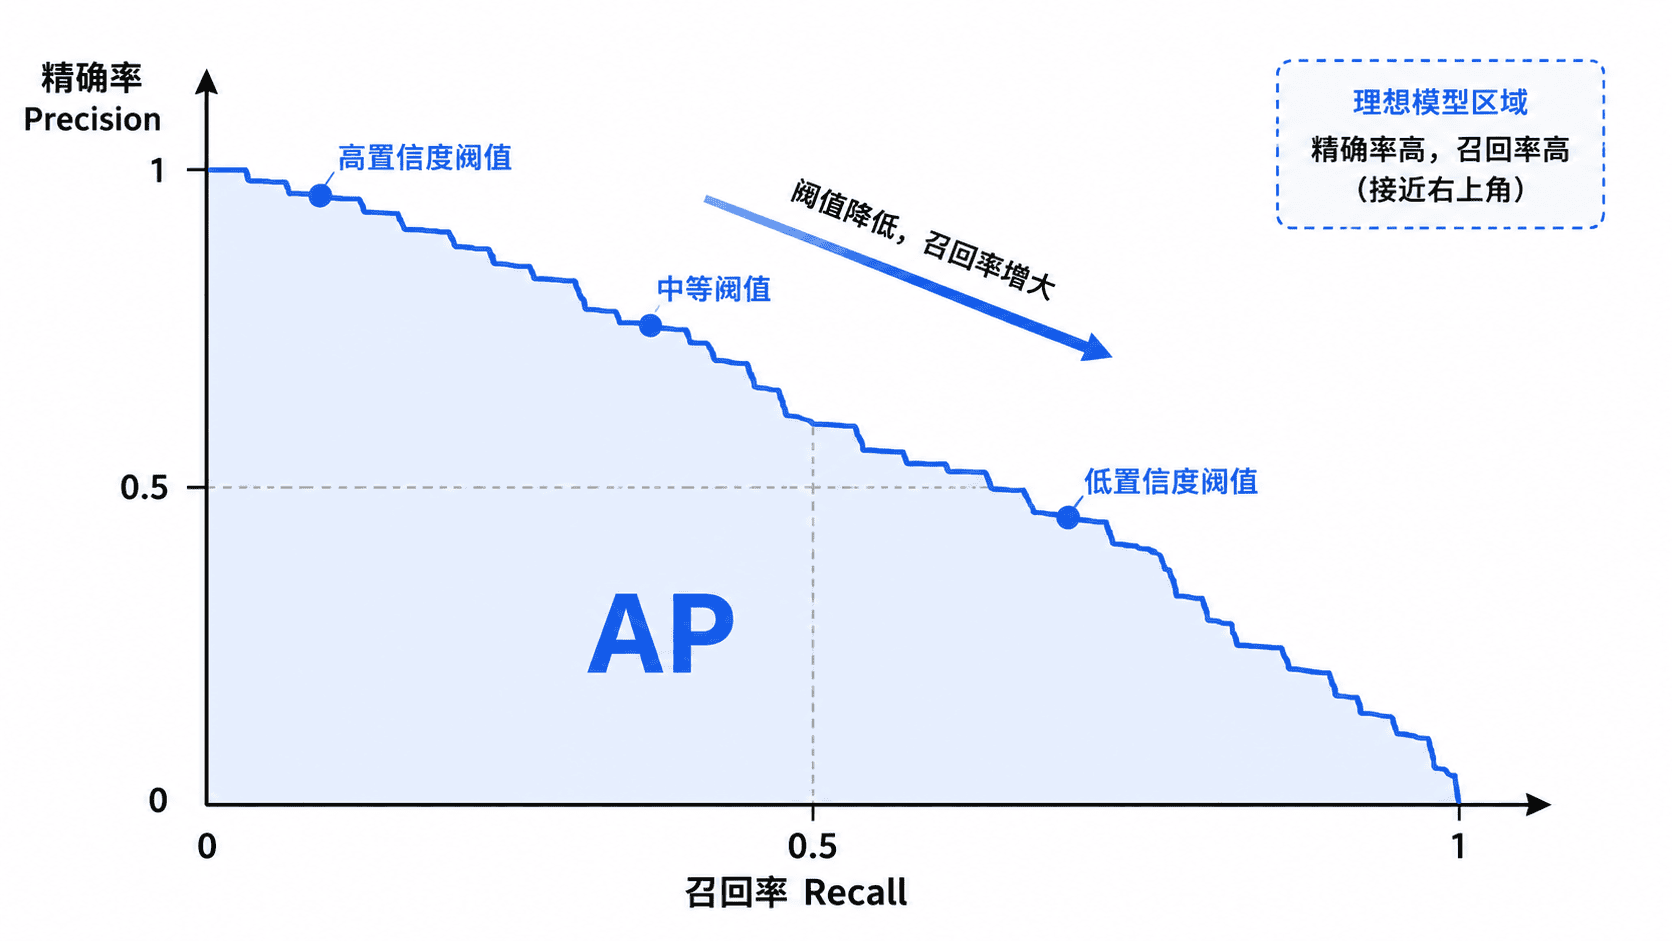
PR 曲线不一定平滑。新增一个正确预测时,召回率会上升;新增一个错误预测时,精确率会下降。不同评估实现可能对曲线进行插值,使结果更稳定、便于比较。
AP 表示一个类别的综合精度
AP 是 Average Precision,即平均精度。它可以理解为 PR 曲线下方的面积,用于综合衡量模型在不同召回率水平上的精确率:
其中 表示召回率为 时对应的精确率。AP 的取值通常位于 0 到 1 之间,也常写成百分比。曲线越接近右上角,覆盖面积越大,AP 越高。
实际计算不会直接对连续曲线积分,而是根据有限的预测结果进行离散求和或插值。常见方法包括早期的 11 点插值、对所有召回率变化点求和,以及 COCO 评估中的 101 点插值。阅读结果时,应确保比较对象采用相同数据集、IoU 阈值和评估实现。
AP 通常针对某一个类别计算。例如,数据集包含“人”和“汽车”,评估系统会分别得到 与 。同一模型在大目标、纹理明显的类别上可能 AP 较高,在小目标或易混淆类别上可能 AP 较低。
IoU 阈值决定匹配严格程度
计算 AP 前,必须先确定预测框与真实框达到多大重叠程度才算正确匹配。常见写法 AP@0.5 表示使用 IoU 0.5 作为 TP 判定阈值。
IoU 阈值越高,对框的位置要求越严格。一个大致覆盖目标但边界不准确的预测框,在 IoU 0.5 下可能记为 TP,在 IoU 0.75 下却可能记为 FP。因此,较高 IoU 阈值下的 AP 通常更低,但更能反映定位精度。
| 指标写法 | 评估含义 | 主要关注点 |
|---|---|---|
| AP@0.5 | 在 IoU 为 0.5 时计算某类别 AP | 能否基本检测到目标 |
| AP@0.75 | 在 IoU 为 0.75 时计算某类别 AP | 边界框定位是否准确 |
| AP@0.5:0.95 | 在 0.5 到 0.95 的多个 IoU 阈值上取平均 | 检测与定位的综合质量 |
mAP 汇总多个类别
mAP 是 mean Average Precision,即多个 AP 的平均值。若数据集有 个类别,在固定 IoU 阈值下,可表示为:
假设三个类别的 AP 分别为 0.90、0.75 和 0.60,则 mAP 为 。这种平均方式通常让每个类别拥有相同权重,不会因为某个类别样本数量特别多而自动占据更大比重。
mAP@0.5 表示先在 IoU 0.5 下计算每个类别的 AP,再对类别取平均。它对框的位置要求相对宽松,数值通常较高,常用于快速观察模型是否具备基本检测能力。
mAP@0.5:0.95 常见于 COCO 评估。它会在 IoU 为 0.50、0.55、0.60,直到 0.95 的十个阈值上分别评估,再对 IoU 阈值和类别共同取平均。该指标更严格,也更能反映模型的综合定位能力。
如何阅读检测评估结果
看到评估结果时,先确认指标名称和评估条件,而不是只比较数字大小。同一个模型的 mAP@0.5 通常明显高于 mAP@0.5:0.95,两者不能当作同一指标直接比较。
还应同时查看各类别 AP。较高的整体 mAP 可能掩盖少数关键类别表现很差的问题。例如安全检测系统即使整体 mAP 较高,只要“火焰”类别 AP 很低,模型仍不适合直接上线。
最后要确认数据集划分、输入尺寸、置信度处理、NMS 设置和评估脚本是否一致。只有评估条件相同,mAP 的横向比较才有意义;跨数据集或跨评估协议的数字不能直接代表模型优劣。