
计算机视觉 / 系统课时
置信度筛选
置信度筛选
边界框解码后,模型通常会产生大量候选框,其中许多只是弱响应。置信度筛选的任务,是为每个候选框计算可比较的类别得分,并在进入 NMS 前删除明显不可靠的预测。
学习目标
- 理解目标置信度、类别概率和最终类别得分的关系
- 能使用阈值筛选候选框并保留对应类别
- 能根据业务需求调整阈值,避免误检或漏检失衡
最终得分如何计算
在经典 YOLO 中,一个候选框通常包含目标置信度 和各类别条件概率 。某一类别的最终得分可以写为:
单标签检测通常取最高类别得分及其类别编号,再与阈值比较。部分新版本的检测头不再单独输出 objectness,而是直接输出类别置信度,此时不能重复相乘,应按模型实现解释输出张量。
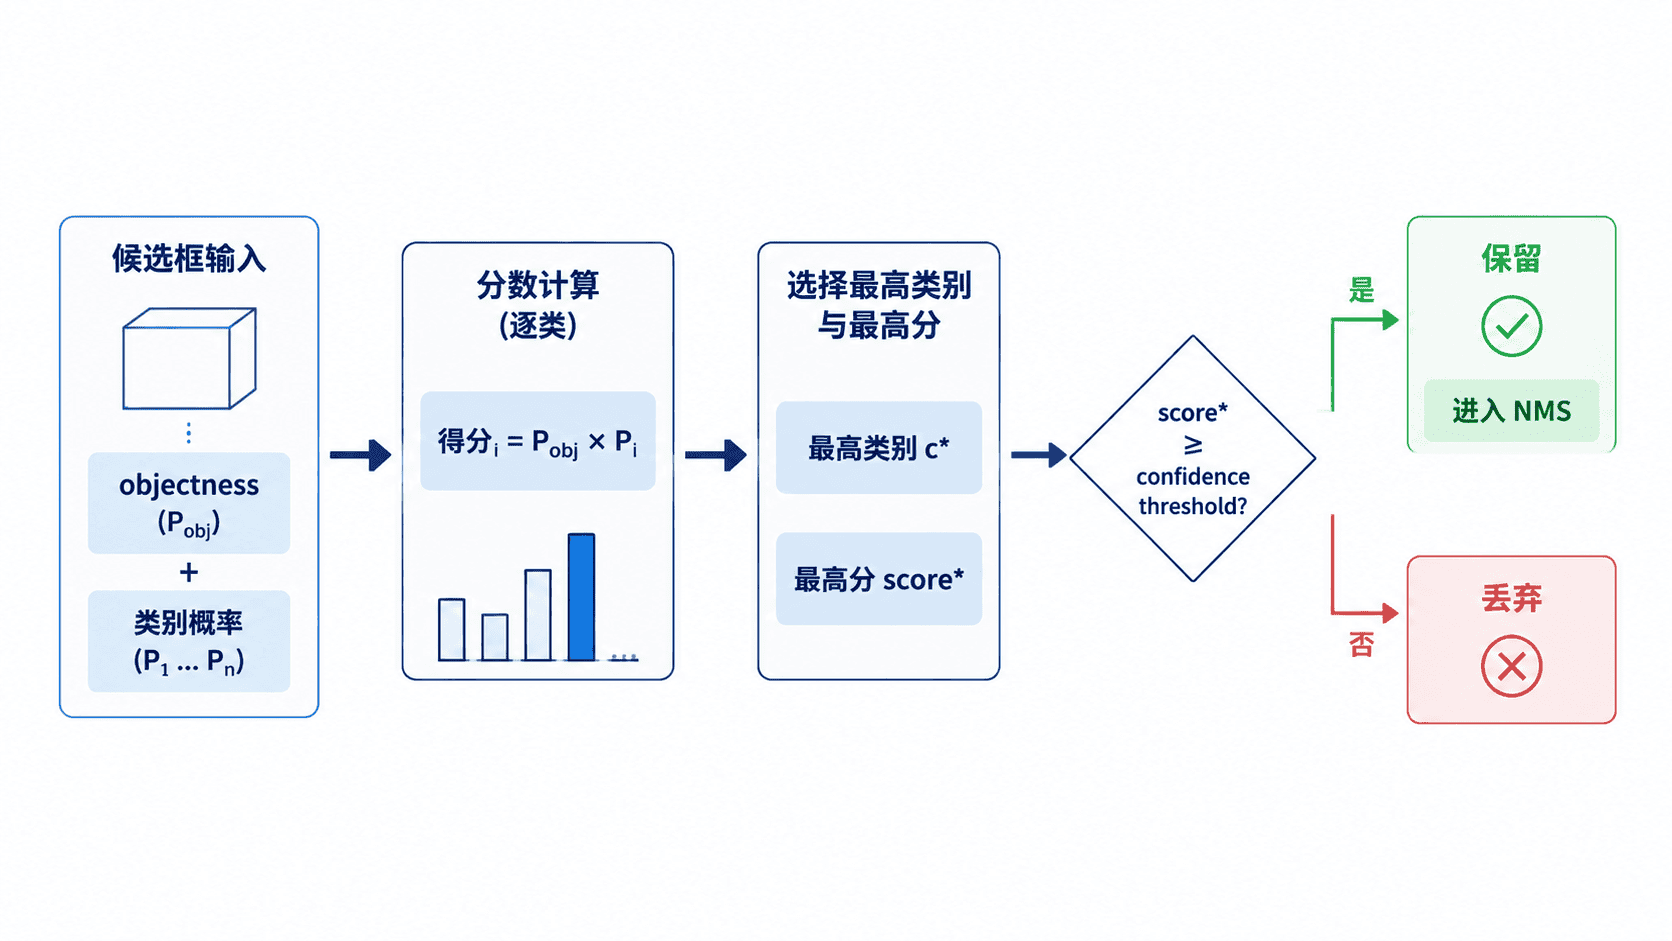
用阈值过滤候选框
下面的完整示例使用单标签策略:先找到最高类别概率,再乘以目标置信度;只有最终得分不低于 0.25 的候选框才会保留。
python
from dataclasses import dataclass

@dataclass
class Candidate:
    box_id: str
    objectness: float
    class_probabilities: list[float]

def filter_candidates(
    candidates: list[Candidate],
    class_names: list[str],
    threshold: float,
) -> list[tuple[str, str, float]]:
    kept: list[tuple[str, str, float]] = []

    for candidate in candidates:
        class_id = max(
            range(len(candidate.class_probabilities)),
            key=candidate.class_probabilities.__getitem__,
        )
        class_probability = candidate.class_probabilities[class_id]
        final_score = candidate.objectness * class_probability

        # 阈值判断必须使用最终类别得分,而不是只看 objectness。
        if final_score >= threshold:
            kept.append((candidate.box_id, class_names[class_id], final_score))

    return kept

classes = ["cat", "person", "dog"]
samples = [
    Candidate("A", 0.90, [0.10, 0.80, 0.10]),
    Candidate("B", 0.40, [0.70, 0.20, 0.10]),
    Candidate("C", 0.70, [0.20, 0.30, 0.50]),
    Candidate("D", 0.50, [0.20, 0.40, 0.40]),
]

for box_id, class_name, score in filter_candidates(samples, classes, 0.25):
    print(f"{box_id}: class={class_name}, score={score:.3f}")
预期输出:
text
A: class=person, score=0.720
B: class=cat, score=0.280
C: class=dog, score=0.350
候选框 D 的最高类别概率为 0.40,最终得分只有 0.20,因此会在 NMS 之前被删除。这样可以减少后续两两重叠计算的数量。
阈值高低带来的影响
阈值不是越高越好。较高阈值会让结果更干净,但可能漏掉小目标、遮挡目标或低对比度目标;较低阈值能保留更多候选框,但误检数量和 NMS 开销都会增加。
| 阈值策略 | 主要效果 | 常见场景 |
|---|---|---|
| 较高阈值 | 精确率通常提高,召回率可能下降 | 自动告警、误报成本高 |
| 较低阈值 | 召回率通常提高,误检可能增加 | 人工复核、漏检成本高 |
| 分类别阈值 | 针对不同类别分别平衡 | 类别难度或业务风险差异明显 |
工程中应在验证集上观察 Precision、Recall 和 PR 曲线,再选择满足业务目标的阈值,而不是直接照搬示例中的 0.25。
常见错误与边界
第一类错误是只用 objectness 做筛选。一个框可能“像某个物体”,却没有任何类别得到高分,因此必须确认模型的最终得分定义。
第二类错误是先执行 NMS,再进行低阈值过滤。通常应先做置信度筛选以缩小候选集,再按类别执行 NMS。对于多标签检测,还要允许同一候选框保留多个超过阈值的类别,不能只取最大值。
按自己的节奏,确认真正理解。