
自动化测试 / 系统课时
排查 CI 与并行问题
排查 CI 与并行问题
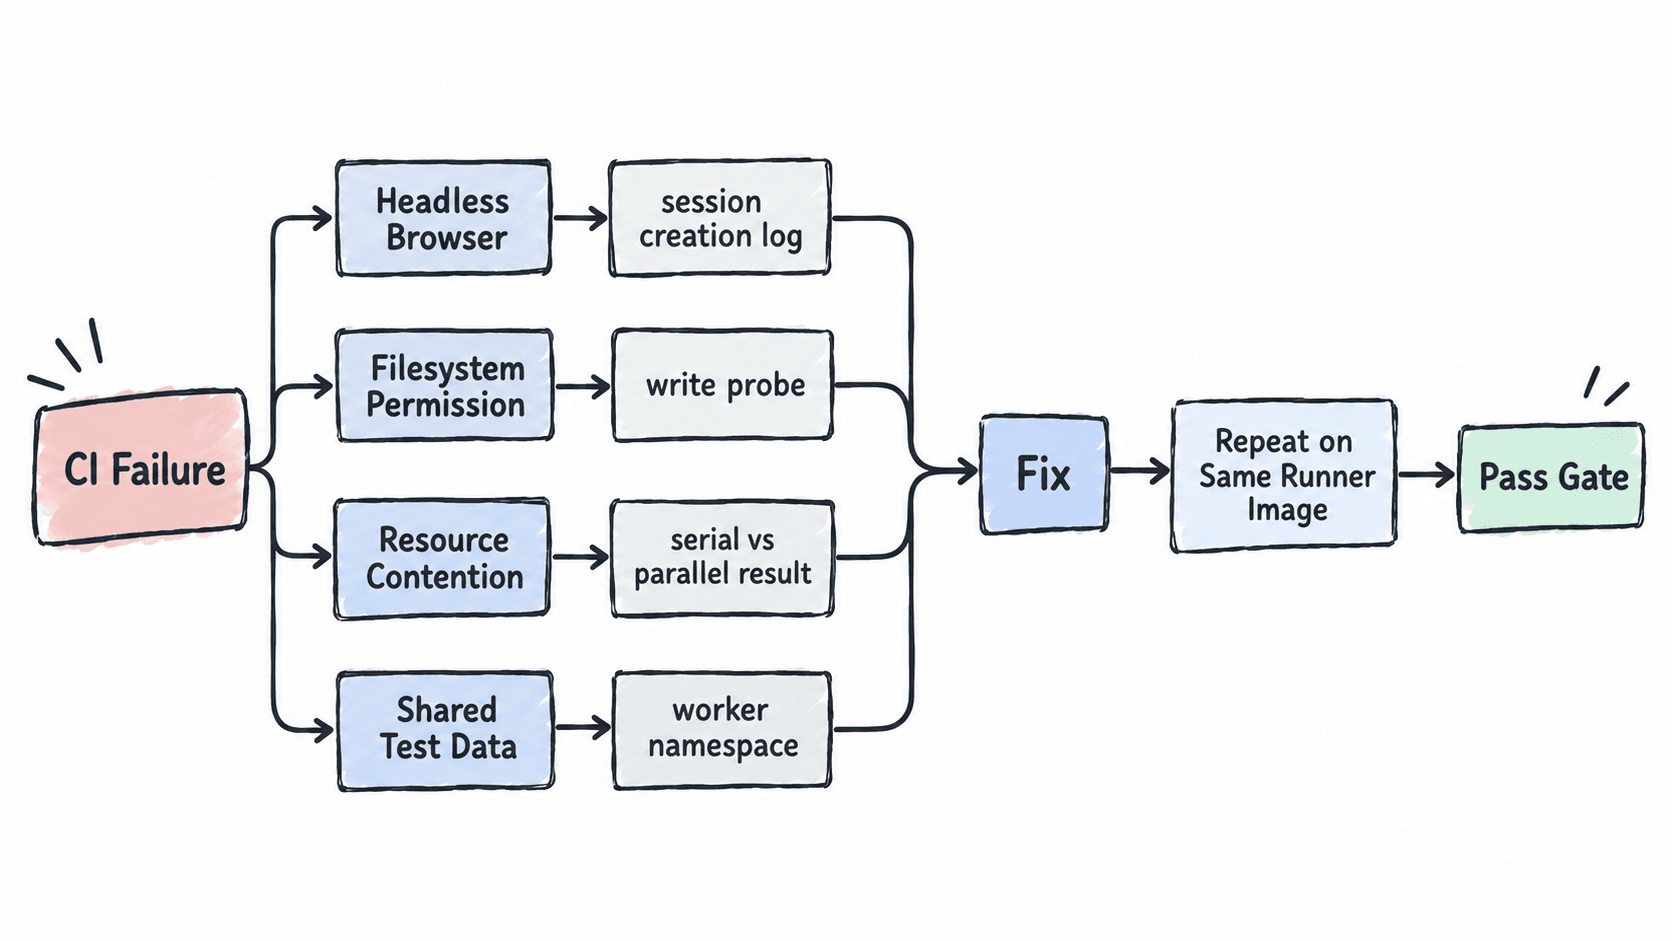
CI 上的 Selenium 失败如果只靠“重跑一次”很难定位。本篇把问题拆成无头浏览器、文件权限、资源竞争和并发数据冲突四类,并给出最小探针、隔离命名和复现顺序,让本地通过但 CI 失败的问题可以被重复验证。
学习目标
- 用最小探针区分浏览器启动失败、工作目录不可写和测试本身失败。
- 通过降低并行度、隔离目录与数据命名空间定位资源竞争和共享状态。
- 用同一 Runner 镜像和重复运行结果判断修复是否真正生效。
先把失败分成四类
先看第一处稳定出现的证据,不要从最后一行异常反推原因。下面这张表适合作为 CI 失败后的第一轮分诊。
| 现象 | 优先检查 | 常见误判 |
|---|---|---|
| 浏览器启动即失败 | Chrome 是否存在、版本是否可启动、无头参数、Driver 会话创建日志 | 把所有 SessionNotCreatedException 都归因于 Selenium 代码 |
| 截图、下载或日志写入失败 | 当前工作目录、目标目录是否存在、执行用户是否有写权限 | 直接对整个工作区执行 chmod -R 777 |
| 串行稳定、并行才失败 | CPU、内存、文件句柄、下载目录、端口与浏览器进程数量 | 只把显式等待从 10 秒改成 30 秒 |
| 失败用例互相“污染” | 测试账号、业务记录、Cookie、缓存键和清理逻辑是否共享 | 把数据冲突当成元素定位不稳定 |
用最小探针验证 CI 环境
先让探针只做三件事:写临时文件、启动无头 Chrome、打开一个不依赖网络的 data: 页面。这样失败时不会混入业务站点、DNS、账号或测试数据因素。示例适用于 Selenium 4 的 Python 绑定,Runner 需要已经安装 Python、Chrome 和 selenium 包。
from pathlib import Path
import sys
import tempfile

import selenium
from selenium import webdriver

with tempfile.TemporaryDirectory() as temp_dir:
    probe = Path(temp_dir) / "write-probe.txt"
    probe.write_text("ok", encoding="utf-8")

    options = webdriver.ChromeOptions()
    options.add_argument("--headless=new")
    options.add_argument("--window-size=1280,800")

    driver = webdriver.Chrome(options=options)
    try:
        driver.get("data:text/html,<title>ci-probe</title><h1>ok</h1>")
        print(f"python={sys.version_info.major}.{sys.version_info.minor}")
        print(f"selenium={selenium.__version__}")
        print(f"write={probe.read_text(encoding='utf-8')}")
        print(f"browser={driver.capabilities.get('browserName')} {driver.capabilities.get('browserVersion')}")
        print(f"title={driver.title}")
    finally:
        driver.quit()
保存为 ci_probe.py 后执行:
python ci_probe.py预期输出中版本号会随 Runner 实际环境变化:
python=<VERSION>
selenium=<VERSION>
write=ok
browser=chrome <VERSION>
title=ci-probe
如果 write=ok 都无法出现,先修工作目录或挂载权限;如果文件可写但 WebDriver 会话创建失败,再查 Chrome 安装、启动参数和 Driver 日志。不要把 --no-sandbox 当默认修复手段;若容器确实因沙箱策略无法启动,应优先让浏览器以非 root 用户运行,并记录为什么需要改变沙箱设置。
用串行对照定位资源竞争
并行失败最有效的对照不是继续加等待,而是保持测试代码不变,只改变 worker 数。假设项目已安装 pytest-xdist,在同一个 Runner 镜像里先跑串行,再恢复目标并行度,同时记录两个进程退出码。
set +e
python -m pytest -q -n 1 tests/e2e
serial_exit=$?
python -m pytest -q -n 4 tests/e2e
parallel_exit=$?
printf 'serial_exit=%s
parallel_exit=%s
' "$serial_exit" "$parallel_exit"
预期输出末尾会出现两个退出码,具体 pytest 统计取决于测试集:
serial_exit=<CODE>
parallel_exit=<CODE>
如果 serial_exit=0 而 parallel_exit 非 0,并且多次运行都保持这个差异,把排查重点转向共享目录、共享账号、数据库唯一键、固定端口以及机器资源。可先把 -n 4 降到 -n 2 做二分定位;若失败率随并行度上升,资源或共享状态比单纯页面等待更值得优先检查。
给 worker 独立目录与数据命名空间
文件和业务数据都应带上运行批次与 worker 标识。pytest-xdist 会为 worker 设置 PYTEST_XDIST_WORKER,本地串行运行时可以回退为 main。下面的脚本生成可直接用于测试账号后缀、订单外部编号或下载目录名的隔离键。
import os
import uuid

def isolation_key(case_name: str) -> str:
    run_id = os.getenv("CI_RUN_ID", "local")
    worker = os.getenv("PYTEST_XDIST_WORKER", "main")
    suffix = uuid.uuid4().hex[:8]
    return f"{run_id}-{worker}-{case_name}-{suffix}"

if __name__ == "__main__":
    print(isolation_key("create-order"))
预期输出中的最后一段每次都会不同:
local-main-create-order-<ID>在 CI 中可把 CI_RUN_ID 设置为流水线运行号,例如 1042,并把该键写入测试数据的 owner、外部编号或临时目录。清理时按同一运行号删除本次创建的数据,禁止使用“删除所有测试数据”这类会影响其他 worker 的清理逻辑。
修复后用重复运行闭环
偶发问题不能以“一次通过”作为修复证据。对原失败用例先在相同 Runner 镜像上串行重复 10 次,再用生产配置的并行度重复目标测试集;每次都保存 JUnit、pytest 日志和失败截图。若仍有失败,应比较失败是否集中在同一 worker、同一账号或同一机器资源峰值。
可以把验收门槛定成三项:原异常 10 次定向复现不再出现;目标并行度下完整测试集连续通过至少 3 轮;每个失败都能从日志追到 run_id、worker、用例名和对应测试数据。只有这三项同时满足,才把问题从“临时重跑可过”改为“已定位并修复”。