
自动化测试 / 系统课时
建立标准项目结构
建立标准项目结构
当 Selenium 用例从几个脚本增长到几十条后,最先失控的常是职责混在一起。本课给出可直接落地的 Python + pytest 结构,把测试、页面对象、数据、配置、日志和报告分开,并用最小用例验收目录能否真正运行。
学习目标
- 为
tests、pages、data、config、logs和reports划清职责与依赖方向。 - 用 pytest fixture 统一创建和销毁 WebDriver,避免每个测试重复生命周期代码。
- 跑通一个最小 Page Object 用例,并验证测试发现、导入路径和资源清理都正常。
先给目录职责定边界
推荐从下面六类目录开始,不要一开始就按“登录、订单、支付”复制整套基础设施。业务模块应该主要体现在测试文件和页面对象命名上,公共配置与运行产物保持集中。
| 位置 | 放什么 | 不该放什么 |
|---|---|---|
tests/ |
测试场景、断言、fixture | 页面定位器实现 |
pages/ |
定位器、页面动作、页面级读取方法 | 业务测试断言 |
data/ |
JSON/CSV 等非敏感测试数据 | 密码、Token、环境密钥 |
config/ |
基础 URL、超时、浏览器等环境配置 | 测试结果 |
logs/ |
运行日志 | 手工维护的输入数据 |
reports/ |
HTML/JUnit XML 等报告产物 | 页面对象源码 |
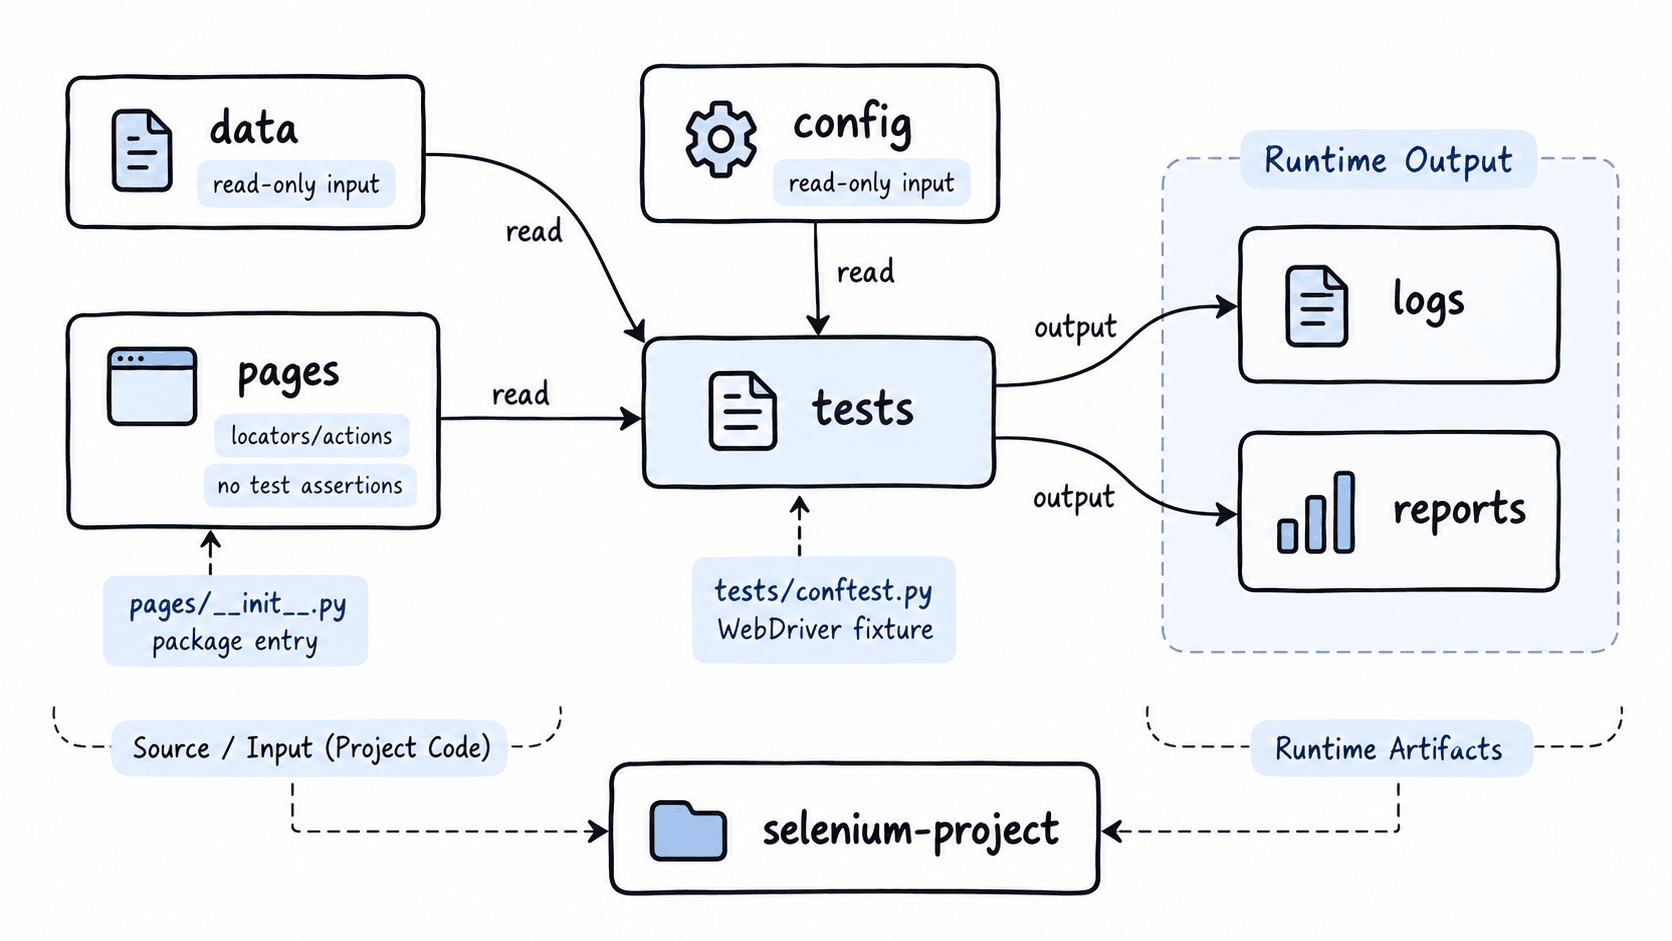
具体落地时,建议把 logs/ 与 reports/ 加入 .gitignore,而 tests/、pages/、data/、config/ 和 pytest.ini 纳入版本控制。页面对象只返回状态或执行动作,最终断言留在 tests/ 中,这样页面改版时不会把业务判断一起改乱。
用最小项目跑通结构
先创建 pages/__init__.py、pages/demo_page.py、tests/conftest.py、tests/test_demo.py 和根目录的 pytest.ini。下面四个文件共同组成一个可运行主示例,依赖 selenium 与 pytest 已安装。
片段示例:pages/demo_page.py 是被测试导入的页面对象模块,不能单独完成测试。
from urllib.parse import quote

from selenium.webdriver.common.by import By

class DemoPage:
    STATE = (By.ID, "state")

    def __init__(self, driver):
        self.driver = driver

    def open(self):
        html = "<title>Project Demo</title><h1 id='state'>ready</h1>"
        self.driver.get("data:text/html;charset=utf-8," + quote(html))

    def state_text(self):
return self.driver.find_element(*self.STATE).text片段示例:tests/conftest.py 由 pytest 自动加载,用 fixture 集中管理会话。
import pytest
from selenium import webdriver

@pytest.fixture
def driver():
    browser = webdriver.Chrome()
    browser.set_window_size(1280, 720)

    try:
        yield browser
    finally:
browser.quit()片段示例:tests/test_demo.py 依赖上面的页面对象与 fixture,断言只放在测试层。
from pages.demo_page import DemoPage

def test_demo_page(driver):
    page = DemoPage(driver)
    page.open()

    assert page.state_text() == "ready"
pytest.ini 是项目级配置文件,下面配置让 pytest 只从 tests 目录发现测试,并使用简洁输出。
[pytest]
testpaths = tests
addopts = -q
从项目根目录运行:
python -m pytest预期输出
.                                                                        [100%]
1 passed in <TIME>s
<TIME> 会随机器和浏览器启动速度变化。若出现 ModuleNotFoundError: No module named 'pages',先确认命令是在项目根目录执行,并确认存在 pages/__init__.py;不要在测试文件里临时修改 sys.path 来掩盖目录问题。
配置与数据不要混进页面对象
环境差异建议放进 config/,例如基础 URL、显式等待秒数、浏览器类型;测试数据放进 data/。一个可直接采用的起点是默认等待 5 秒、基础 URL 由环境变量覆盖,敏感值只从环境变量读取。
片段示例:config/settings.py 供测试或 fixture 导入,不负责启动浏览器。
import os

BASE_URL = os.getenv("BASE_URL", "https://example.com")
WAIT_SECONDS = int(os.getenv("WAIT_SECONDS", "5"))
BROWSER = os.getenv("BROWSER", "chrome")
生效行为是:没有环境变量时使用默认值;CI 可以通过 BASE_URL、WAIT_SECONDS、BROWSER 覆盖。验证时可在测试启动日志里打印最终配置,但不要打印密码、Cookie、Bearer Token 或客户端密钥。
测试数据文件建议按业务对象命名,例如 data/login_cases.json,而不是 data/test1.json。每条数据至少包含能说明用途的字段,如 case_id、输入值与期望业务状态;秘密信息改用环境变量或 CI secret。
日志与报告作为运行产物
logs/ 和 reports/ 应该是测试执行后生成的目录,而不是人工维护的源码。常见做法是把应用级日志写到 logs/test.log,把 CI 可读取的 JUnit XML 写到 reports/junit.xml,失败截图再按用例名和时间戳落到报告目录。
pytest 生成 JUnit XML 可以直接运行:
python -m pytest --junitxml=reports/junit.xml预期结果
1 passed in <TIME>s
generated xml file: <PATH>/reports/junit.xml
实际终端还会带进度符号和分隔线;关键验收项是测试通过且生成 reports/junit.xml。如果目录不存在,先创建 reports/;在 CI 中可把该目录作为构建产物上传,而不是提交进 Git。日志中出现动态 session id、端口或临时路径时,排查文档统一用 <ID>、<PORT>、<PATH> 表示,不要把一次运行的具体值写成固定配置。
扩展结构时守住依赖方向
项目扩大后可以增加 components/、utils/ 或按业务拆分 pages/account/、pages/orders/,但依赖方向仍保持简单:测试层调用页面对象;页面对象调用 Selenium;配置和数据被读取;日志和报告只接收输出。
一个容易检查的规则是:在 pages/ 搜索 assert,正常情况下不应出现业务断言;在 tests/ 搜索 By.ID、By.CSS_SELECTOR 等定位器,如果大量出现,说明定位细节正在从页面对象泄漏回测试层。每次重构后重新执行 python -m pytest,以“所有测试可发现、导入无错误、会话正常退出、报告可生成”作为结构调整的验收条件。