
自动化测试 / 系统课时
组织测试套件
组织测试套件
测试数量从十几个增长到几百个后,仅靠文件名堆在一个目录里很快会失控。可维护的 Selenium 套件应同时解决代码放在哪里、一次运行哪些用例、共享初始化写在哪里三个问题,并让失败报告能直接定位到业务模块和场景。
学习目标
- 按业务能力和测试场景划分 Selenium 用例目录与文件
- 使用 pytest marker 组合冒烟集与回归集,而不是复制测试代码
- 判断 fixture 应放在测试文件还是
conftest.py,避免共享范围失控
先按业务能力拆目录
对中型 Web 项目,优先使用业务能力作为第一层目录,例如认证、结算和账户,而不是建立一个巨大的 tests/test_all.py。测试文件再按可独立描述的业务场景命名,失败报告能直接反映问题所在。
| 路径 | 负责内容 | 示例 |
|---|---|---|
tests/auth/ |
登录、登出、会话恢复 | test_login.py |
tests/checkout/ |
购物车到支付确认 | test_checkout_flow.py |
tests/account/ |
资料、密码、地址 | test_profile.py |
tests/conftest.py |
多模块共享 fixture | driver、base_url |
同一页面可能同时参与多个业务场景,因此不要简单按网页 URL 建一层目录。比如登录页既可能服务认证冒烟测试,也可能是结算流程的前置步骤;测试归属应以要验证的业务行为为准。
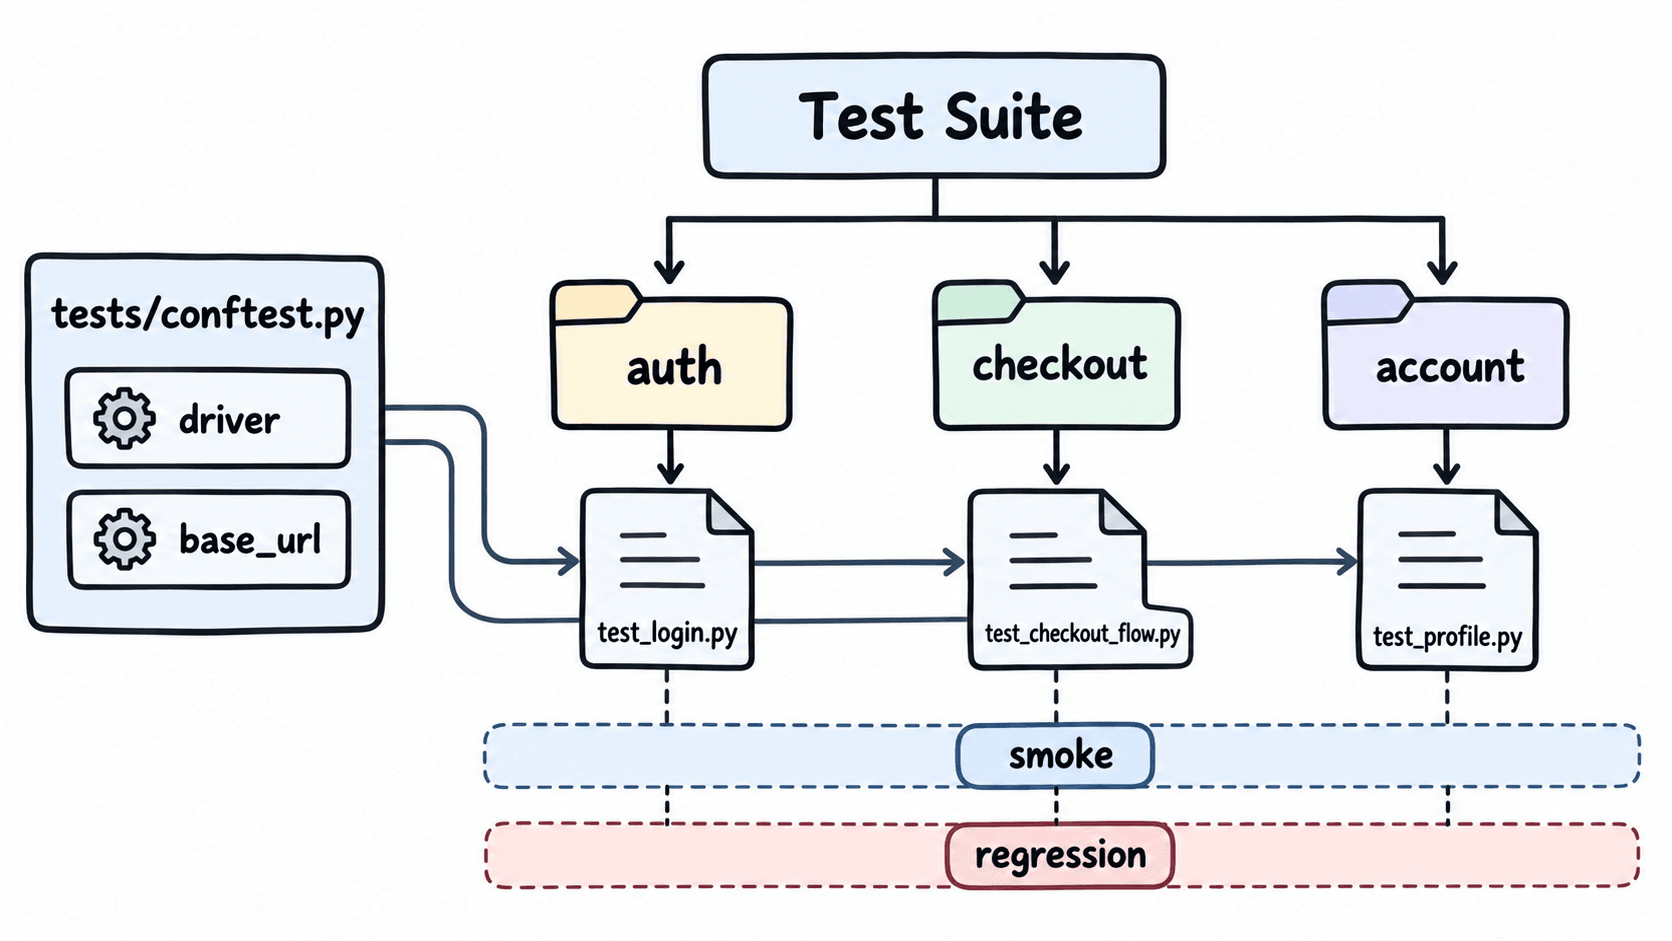
用 marker 维护不同运行集合
冒烟测试与回归测试不应该复制成两套文件。更合适的方式是让同一用例保留唯一实现,再通过 marker 描述运行属性。下面的文件包含一个 smoke 场景和一个仅属于 regression 的场景,可直接由 pytest 执行。
import pytest
from selenium import webdriver
from selenium.webdriver.common.by import By


@pytest.fixture(scope="module")
def driver():
    options = webdriver.ChromeOptions()
    options.add_argument("--headless=new")
    browser = webdriver.Chrome(options=options)
    yield browser
    browser.quit()


@pytest.mark.smoke
@pytest.mark.regression
def test_checkout_entry(driver):
    driver.get(
        "data:text/html,<button id='checkout'>Checkout</button>"
    )
    assert driver.find_element(By.ID, "checkout").is_displayed()


@pytest.mark.regression
def test_discount_message(driver):
    driver.get(
        "data:text/html,<p id='discount'>Coupon accepted</p>"
    )
    assert driver.find_element(By.ID, "discount").text == "Coupon accepted"
同时在项目根目录注册 marker,避免 pytest 把拼错的标记悄悄当成未知 marker 警告:
[pytest]
markers =
    smoke: critical flows checked on every build
    regression: broader regression coverage
配置文件的生效结果是 pytest 能识别两个 marker。执行冒烟集合时使用:
python -m pytest tests/checkout/test_checkout_flow.py -m smoke -q预期输出
.                                                                        [100%]
1 passed, 1 deselected in <TIME>s
若改成 -m regression,两个测试都会被选中。marker 表达的是执行集合,不宜拿它代替业务目录;否则随着标签增加,很容易出现 login、checkout、critical、nightly 等维度混在一起而无法判断文件应放在哪里。
控制 fixture 的共享范围
fixture 应放在它真正需要共享的最小范围。只被一个文件使用的准备逻辑直接留在该测试文件;多个同级目录都需要浏览器或基础地址时,再上移到 tests/conftest.py。不要因为方便就把所有 fixture 都放到根目录。
pytest 的 scope 会直接决定资源复用周期。Selenium 浏览器常见选择如下:
| scope | 创建频率 | 适用情况 | 主要风险 |
|---|---|---|---|
function |
每个测试一次 | 用例必须完全隔离 | 启动浏览器次数最多 |
class |
每个测试类一次 | 同一类共享有限状态 | 类内状态可能互相影响 |
module |
每个测试模块一次 | 一组只读或可重置场景 | 前一用例可能污染后一用例 |
session |
整个 pytest 会话一次 | 启动成本极高且状态可彻底重置 | 污染影响整套测试 |
例如 40 个测试每次启动 Chrome 需要约 1.5 秒,function scope 单浏览器启动成本就约为 60 秒;改成 4 个模块各复用一次理论上约为 6 秒。但如果业务状态无法可靠清理,节省的几十秒不值得换取随机失败,此时仍应选择 function。
让测试名称直接表达业务场景
测试函数名称应描述可观察行为,而不是操作步骤。test_click_button() 无法说明业务失败了什么,test_valid_user_can_submit_order() 则能让报告直接指出验证对象。pytest 默认发现以 test_ 开头的函数和文件,因此命名同时影响可读性与收集结果。
可运行整个结算目录,检查目录划分是否能形成独立测试集合:
python -m pytest tests/checkout -q预期输出
..                                                                       [100%]
2 passed in <TIME>s
如果命令显示 no tests ran,先检查文件名是否以 test_ 开头、测试函数是否以 test_ 开头,以及目标目录是否写错。真正可维护的套件通常同时使用业务目录确定归属、清晰函数名表达场景、marker 决定运行集合,这三个维度各自承担一种职责。