
自动化测试 / 系统课时
管理测试产物
管理测试产物
Selenium 失败时仅保存一句 AssertionError 往往不够,因为真正原因可能是遮挡层、错误页面、跳转异常或 DOM 状态变化。本篇建立一套可直接用于 CI 的产物规则:失败时保存截图、页面源码和浏览器信息,同时持续归档日志与 JUnit 报告。
学习目标
- 为日志、截图、页面源码和测试报告定义固定目录与命名规则。
- 在 pytest 的失败阶段自动捕获浏览器证据,并保证发生在 WebDriver 销毁之前。
- 在 CI 中无论测试成功还是失败都上传产物,并控制保留时间与敏感信息范围。
先定义产物边界
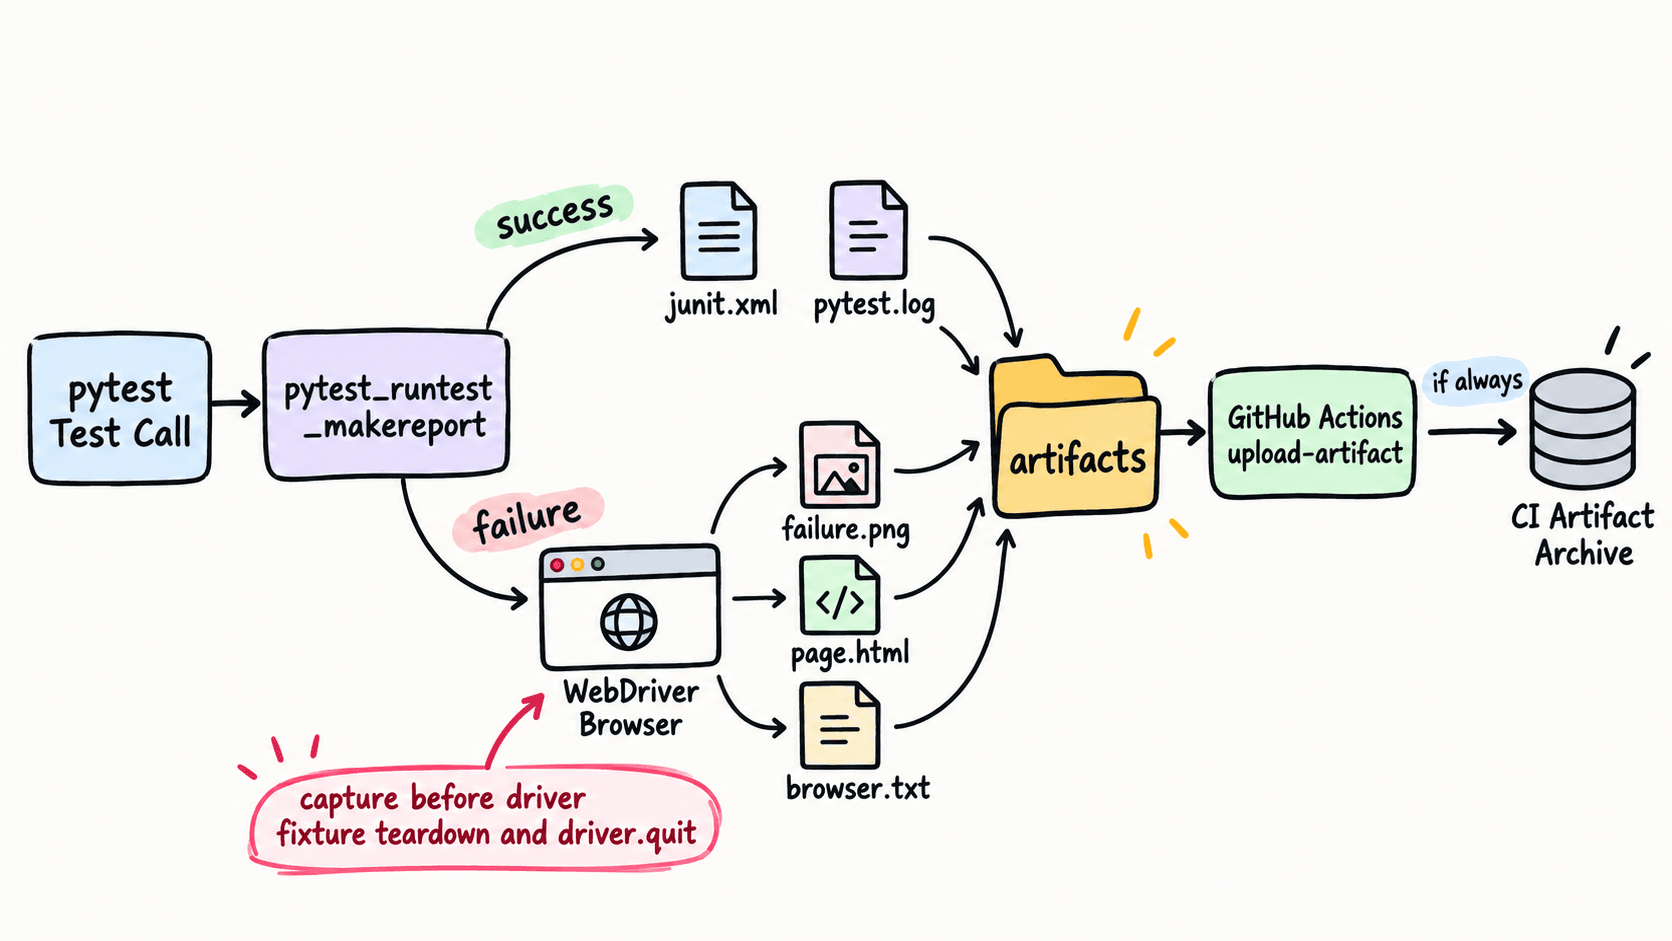
推荐把当前运行产生的文件统一放入仓库根目录的 artifacts/,不要散落到测试源码目录。基础集合可以控制在四类,既足够排错,也方便 CI 一次上传。
| 产物 | 推荐路径 | 生成时机 | 用途 |
|---|---|---|---|
| JUnit XML | artifacts/junit.xml |
每次执行 | 汇总通过、失败、跳过和耗时 |
| pytest 日志 | artifacts/pytest.log |
每次执行 | 查看测试代码和 fixture 日志 |
| 失败截图 | artifacts/<CASE>/failure.png |
仅失败 | 判断页面当时真正显示了什么 |
| 页面源码 | artifacts/<CASE>/page.html |
仅失败 | 检查 DOM、错误页和元素状态 |
<CASE> 应来自 pytest 的 nodeid,但要先替换 /、:、[ 等不适合作为文件名的字符。并行执行时尤其不能把所有失败都写成同一个 failure.png,否则后完成的 worker 会覆盖前面的证据。
在失败阶段捕获浏览器证据
pytest 的 pytest_runtest_makereport 可以取得 setup、call、teardown 三个阶段的结果。真正的测试断言失败通常发生在 call 阶段,因此在 report.when == "call" 且 report.failed 时保存证据;此时 fixture 尚未进入 teardown,浏览器仍然可用。
下面的 conftest.py 是完整示例。它提供 Chrome fixture,并在失败时保存截图、页面源码、当前 URL 和标题。
from pathlib import Path
import re

import pytest
from selenium import webdriver


ARTIFACT_ROOT = Path("artifacts")


def safe_name(nodeid: str) -> str:
    return re.sub(r"[^A-Za-z0-9_.-]+", "_", nodeid)


@pytest.fixture
def driver():
    options = webdriver.ChromeOptions()
    options.add_argument("--headless=new")
    browser = webdriver.Chrome(options=options)
    yield browser
    browser.quit()


@pytest.hookimpl(hookwrapper=True)
def pytest_runtest_makereport(item, call):
    outcome = yield
    report = outcome.get_result()

    if report.when != "call" or not report.failed:
        return

    browser = item.funcargs.get("driver")
    if browser is None:
        return

    case_dir = ARTIFACT_ROOT / safe_name(item.nodeid)
    case_dir.mkdir(parents=True, exist_ok=True)

    browser.save_screenshot(str(case_dir / "failure.png"))
    (case_dir / "page.html").write_text(
        browser.page_source,
        encoding="utf-8",
    )
    (case_dir / "browser.txt").write_text(
        f"url={browser.current_url}\ntitle={browser.title}\n",
        encoding="utf-8",
    )
为了验证钩子确实工作,可以创建一个故意失败的测试。它只用于本地或临时 CI 验证,确认完成后应删除或恢复正确断言。
def test_artifact_capture(driver):
    driver.get("data:text/html,%3Ctitle%3EArtifact%20Demo%3C/title%3E")
    assert driver.title == "Expected Title"
运行时同时生成 JUnit XML 和 pytest 日志。
rm -rf artifacts
mkdir -p artifacts
python -m pytest tests/test_artifact_demo.py -q --junitxml=artifacts/junit.xml --log-file=artifacts/pytest.log --log-file-level=INFO
预期输出:这个演示断言被故意写错,因此退出码为非零并显示 1 个失败用例。
F                                                                        [100%]
1 failed in <TIME>s
随后执行文件检查。
find artifacts -maxdepth 2 -type f | sort预期输出中的用例目录名由 nodeid 转换而来,具体前缀会随测试路径变化,但应至少包含这些文件。
artifacts/junit.xml
artifacts/pytest.log
artifacts/tests_test_artifact_demo.py_test_artifact_capture/browser.txt
artifacts/tests_test_artifact_demo.py_test_artifact_capture/failure.png
artifacts/tests_test_artifact_demo.py_test_artifact_capture/page.html
在 CI 中无条件归档
测试命令失败后,GitHub Actions 默认不会继续执行普通后续步骤,因此产物上传必须使用 if: always()。下面是放在同一个 job 的 steps 中的片段示例;retention-days: 14 表示希望保存 14 天,实际可用范围还受仓库或组织的 Artifact 保留策略限制。
- name: Upload Selenium artifacts
  if: always()
  uses: actions/upload-artifact@v4
  with:
    name: selenium-artifacts-${{ github.run_id }}
    path: artifacts/
    if-no-files-found: warn
    retention-days: 14
生效行为很明确:测试步骤返回 0 时上传报告和日志;测试步骤返回非零时仍执行上传,因此失败截图和页面源码不会因为 job 标红而丢失。验证时可以故意运行上一节的失败测试,确认 Actions 运行失败,但 Artifact 仍然存在。
控制体积和敏感信息
浏览器证据越多并不代表越好。截图和页面源码建议只在失败时生成;JUnit XML 与日志每次生成即可。普通 Pull Request 可以把 Artifact 保留期设为 7~14 天,长期审计或发布验证再根据组织规则延长,而不是永久保存所有临时失败文件。
页面源码可能包含用户名、订单号、表单值或服务端渲染数据,日志也可能意外打印 Token。不要归档完整浏览器 Profile、Cookie 数据库、cookies.json、密码文件或包含认证头的网络转储。确实需要记录请求信息时,应先对 Authorization、Cookie、手机号和邮箱等字段做脱敏。
并行执行还要保证文件名唯一。可以继续使用 pytest nodeid 作为用例目录,并在需要区分 worker 时加入 PYTEST_XDIST_WORKER 等运行标识;判断一套产物管理是否合格的标准很简单:看到一个失败用例后,能够从对应目录找到它自己的截图、DOM、浏览器位置和测试报告,而不会被另一条并行用例覆盖。