
自动化测试 / 系统课时
分离测试与页面逻辑
分离测试与页面逻辑
当定位器、等待条件和点击细节直接散落在测试函数里,页面一次改版就会迫使大量用例一起修改。把这些细节收进 Page Object 后,测试只保留业务动作与断言,页面变化通常只需要修改一个类。
学习目标
- 区分测试用例、Page Object 与 WebDriver 各自应承担的职责。
- 用 Page Object 封装定位器、页面操作和必要的等待逻辑。
- 判断断言、测试数据和页面细节应该放在哪一层。
把变化频率不同的代码拆开
例如登录按钮从 #login-btn 改成 `[data-testid=login-submit],这是页面实现变化,不应该迫使“有效账号能够登录”这条业务测试重写。可以按下面的边界划分代码:
| 内容 | 推荐位置 | 示例 |
|---|---|---|
| 定位器 | Page Object | By.ID, "username" |
| 输入、点击、等待 | Page Object | login()、status_text() |
| 测试数据 | 测试或数据层 | 用户名、密码、角色 |
| 业务步骤 | 测试用例 | 打开登录页、登录 |
| 业务断言 | 测试用例 | 登录后状态等于“登录成功” |
错误做法是让测试函数重复出现find_element()、CSS 选择器和显式等待;正确做法是让测试调用具有业务含义的方法,例如 page.login(user, password)。这样测试失败时仍能看到“登录失败”这一业务意图,而不是被几十行页面操作淹没。
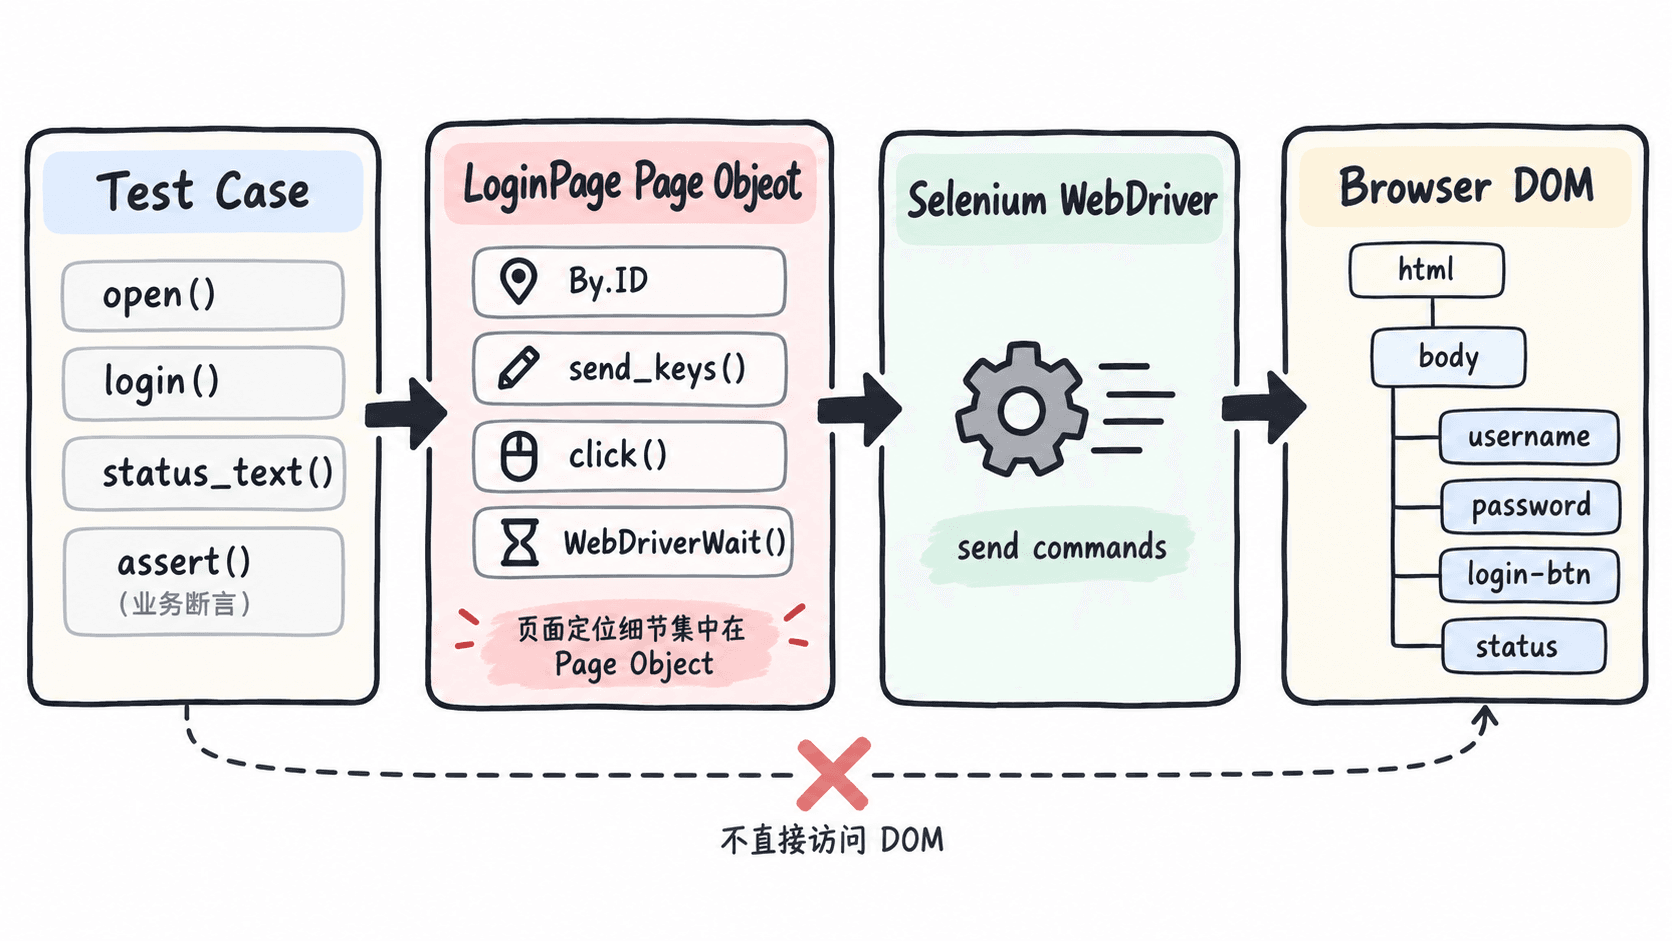
用 Page Object 封装页面细节
下面的示例使用本地 data: 页面,不依赖外部网站。环境需要已安装 Selenium Python Bindings,并有可启动的 Chrome。test_valid_login()中没有定位器,也没有直接调用find_element();这些细节全部留在 LoginPage。
from urllib.parse import quote

from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.support.ui import WebDriverWait


class LoginPage:
    USERNAME = (By.ID, 'username')
    PASSWORD = (By.ID, 'password')
    SUBMIT = (By.ID, 'login-btn')
    STATUS = (By.ID, 'status')

    def __init__(self, driver):
        self.driver = driver

    def open(self):
        html = '''
        <input id="username">
        <input id="password" type="password">
        <button id="login-btn" onclick="login()">登录</button>
        <p id="status"></p>
        <script>
        function login() {
          const ok = username.value === 'alice' && password.value === '123456';
          status.textContent = ok ? '登录成功' : '登录失败';
        }
        </script>
        '''
        self.driver.get('data:text/html;charset=utf-8,' + quote(html))
        return self

    def login(self, username, password):
        # 页面层负责怎样找到并操作控件。
        self.driver.find_element(*self.USERNAME).send_keys(username)
        self.driver.find_element(*self.PASSWORD).send_keys(password)
        self.driver.find_element(*self.SUBMIT).click()

    def status_text(self):
        # 等待页面进入可断言的稳定状态,而不是固定 sleep。
        WebDriverWait(self.driver, 5).until(
            EC.text_to_be_present_in_element(self.STATUS, '登录成功')
        )
        return self.driver.find_element(*self.STATUS).text


def test_valid_login(driver):
    page = LoginPage(driver).open()
    page.login('alice', '123456')
    assert page.status_text() == '登录成功'


def main():
    options = webdriver.ChromeOptions()
    options.add_argument('--headless')
    driver = webdriver.Chrome(options=options)
    try:
        test_valid_login(driver)
        print('PASS: 用户登录后看到成功状态')
    finally:
        driver.quit()


if __name__ == '__main__':
    main()
预期输出
PASS: 用户登录后看到成功状态如果以后按钮 ID 改变,只需要修改 LoginPage.SUBMIT。测试函数仍然描述同一个业务事实,因此不需要跟随 DOM 结构一起修改。
保留清晰的断言边界
Page Object 可以判断“元素是否出现”“页面是否已经进入可操作状态”,但通常不要在 login()内写assert。例如,login()负责输入账号并提交,测试用例负责断言管理员菜单是否出现、URL 是否变化或错误提示是否符合预期。
一个可操作的检查标准是:如果一句代码回答的是“页面上怎样做”,放进 Page Object;如果回答的是“业务结果是否正确”,保留在测试中。等待#status出现属于页面同步,断言其内容必须是“登录成功”属于测试预期。
检查是否真正完成分离
重构现有用例时,可以用三个具体条件验收。测试函数中不再出现 CSS、XPath、ID 等定位字符串;同一个页面元素的定位器只定义一次;页面等待集中在产生该状态的页面方法附近,而业务断言仍留在测试函数中。
例如页面把login-btn改名时,只修改一个定位器即可;如果需要同时修改十几个测试文件,说明页面逻辑仍然泄漏到了测试层。