
自动化测试 / 系统课时
配置文件下载
配置文件下载
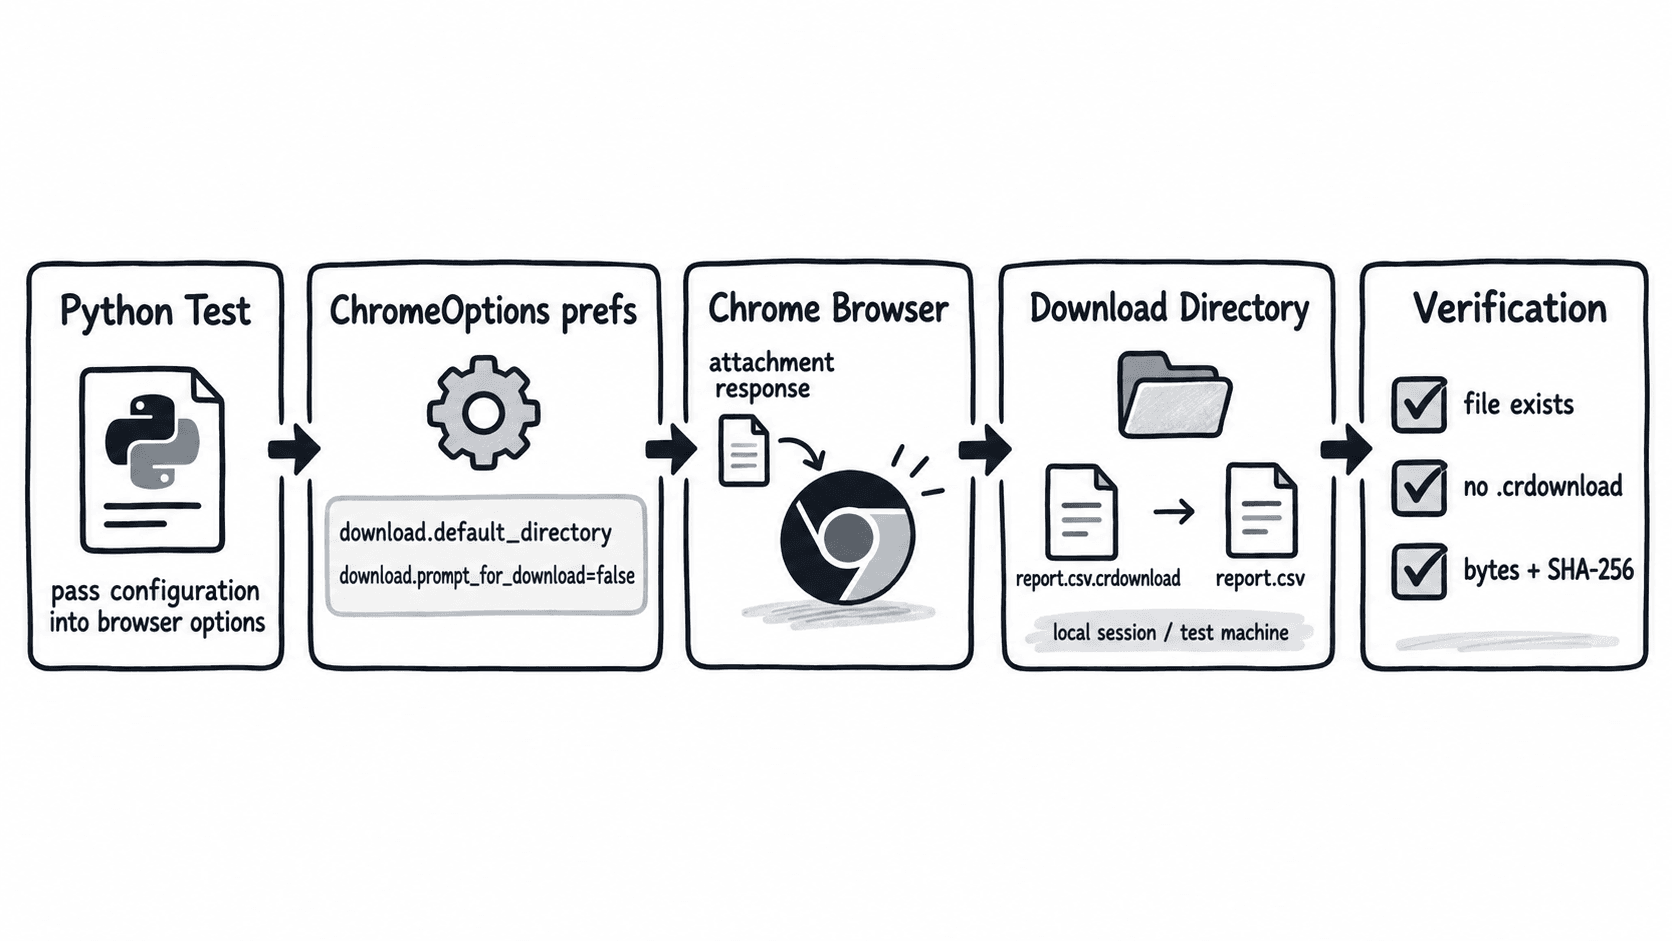
文件下载测试要同时控制“浏览器把文件写到哪里”和“测试何时认定下载完成”。本课使用 Selenium 4 的 Python 绑定与本地 Chrome 会话,把下载目录固定到独立临时目录,再用文件名、临时扩展名、字节数和 SHA-256 校验结果,避免只看到文件出现就误判成功。
学习目标
- 为 Chrome/Chromium 设置绝对下载目录并关闭下载确认弹窗。
- 等待下载真正完成,而不是只等待点击动作结束。
- 用文件大小与内容哈希验证下载结果,并识别本地会话与远程 Grid 的差异。
设置下载目录与浏览器选项
Chrome/Chromium 的下载目录通过浏览器首选项传入。download.default_directory 应使用绝对路径;download.prompt_for_download 设为 False 后,普通附件下载不会停在“另存为”交互上。测试目录最好每次新建,避免旧文件或浏览器自动生成的 report (1).csv 干扰断言。
| 选项 | 推荐值 | 用途 |
|---|---|---|
download.default_directory |
绝对路径 | 固定文件落盘位置 |
download.prompt_for_download |
False |
关闭下载确认提示 |
download.directory_upgrade |
True |
允许使用指定目录 |
以下做法针对 Chrome/Chromium。本地 Edge 同属 Chromium,可用 EdgeOptions 传入同类 prefs;Firefox 使用不同的浏览器首选项,不应直接照搬这些键名。
完成一次可复现的下载与验证
下面的完整示例在本机启动一个临时 HTTP 服务,提供固定内容的 report.csv,因此不依赖外部网站。测试点击下载链接后轮询目录,直到目标文件存在且目录中没有 Chromium 的 .crdownload 临时文件,再校验字节数和 SHA-256。
import hashlib
import tempfile
import threading
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from pathlib import Path

from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait

CONTENT = b"order_id,amount\nA1001,39.90\n"

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        if self.path == "/report.csv":
            self.send_response(200)
            self.send_header("Content-Type", "text/csv; charset=utf-8")
            self.send_header(
                "Content-Disposition", 'attachment; filename="report.csv"'
            )
            self.send_header("Content-Length", str(len(CONTENT)))
            self.end_headers()
            self.wfile.write(CONTENT)
            return

        page = b'<a id="download" href="/report.csv">Download report</a>'
        self.send_response(200)
        self.send_header("Content-Type", "text/html; charset=utf-8")
        self.send_header("Content-Length", str(len(page)))
        self.end_headers()
        self.wfile.write(page)

    def log_message(self, format, *args):
        pass

download_dir = Path(tempfile.mkdtemp(prefix="selenium-download-")).resolve()
server = ThreadingHTTPServer(("127.0.0.1", 0), Handler)
threading.Thread(target=server.serve_forever, daemon=True).start()

options = webdriver.ChromeOptions()
options.add_experimental_option(
    "prefs",
    {
        "download.default_directory": str(download_dir),
        "download.prompt_for_download": False,
        "download.directory_upgrade": True,
    },
)

driver = None
target = download_dir / "report.csv"

try:
    driver = webdriver.Chrome(options=options)
    driver.get(f"http://127.0.0.1:{server.server_port}/")
    driver.find_element(By.ID, "download").click()

    # 点击结束不代表下载结束:同时等待最终文件和临时文件消失。
    WebDriverWait(driver, 10).until(
        lambda _: target.is_file()
        and not any(download_dir.glob("*.crdownload"))
    )

    actual = target.read_bytes()
    expected_hash = hashlib.sha256(CONTENT).hexdigest()
    actual_hash = hashlib.sha256(actual).hexdigest()

    print(f"file={target.name}")
    print(f"bytes={len(actual)}")
    print(f"sha256_ok={actual_hash == expected_hash}")
finally:
    if driver is not None:
        driver.quit()
    server.shutdown()
    server.server_close()
预期输出:
file=report.csv
bytes=28
sha256_ok=True
如果 10 秒内没有完成,WebDriverWait 会抛出超时异常;实际项目应把 10 秒改成符合文件体积与网络环境的上限,例如内部 5 MB 报表可先用 30 秒,而不是用固定 time.sleep() 猜下载耗时。
把“文件存在”升级为“文件正确”
只断言 Path.exists() 只能证明目录里有同名文件,不能证明它是本次下载且内容完整。至少再做一层可检查断言:固定文本或测试夹具可比较 SHA-256;动态报表可检查文件大小大于 0、CSV 表头、记录数或业务字段。
对于 Chromium,本地下载过程中常见临时扩展名是 .crdownload。测试等待最终文件出现并确认临时文件消失,比“看到目标文件就继续”更稳。若业务会生成随机文件名,应先清空独立下载目录,再用时间范围或文件模式筛选新文件。
远程 Grid 时不要检查错文件系统
本地 webdriver.Chrome() 中,浏览器与测试通常共享同一台机器,因此 Python 可以直接读取下载目录。Remote WebDriver 或 Selenium Grid 中,下载目录默认位于远端节点;客户端的 Path("<PATH>") 不会自动指向节点上的同名目录。
需要把远端文件拉回客户端时,可使用 Selenium Grid 的 managed downloads:服务端启动时开启 --enable-managed-downloads true,客户端浏览器选项设置 enable_downloads = True,随后通过 Remote WebDriver 的 get_downloadable_files() 和 download_file() 获取文件。若团队改用共享卷,也应明确挂载路径由谁创建、谁清理,并把“节点文件存在”和“客户端成功拿到文件”分成两个断言。