
自动化测试 / 系统课时
加载外部测试数据
加载外部测试数据
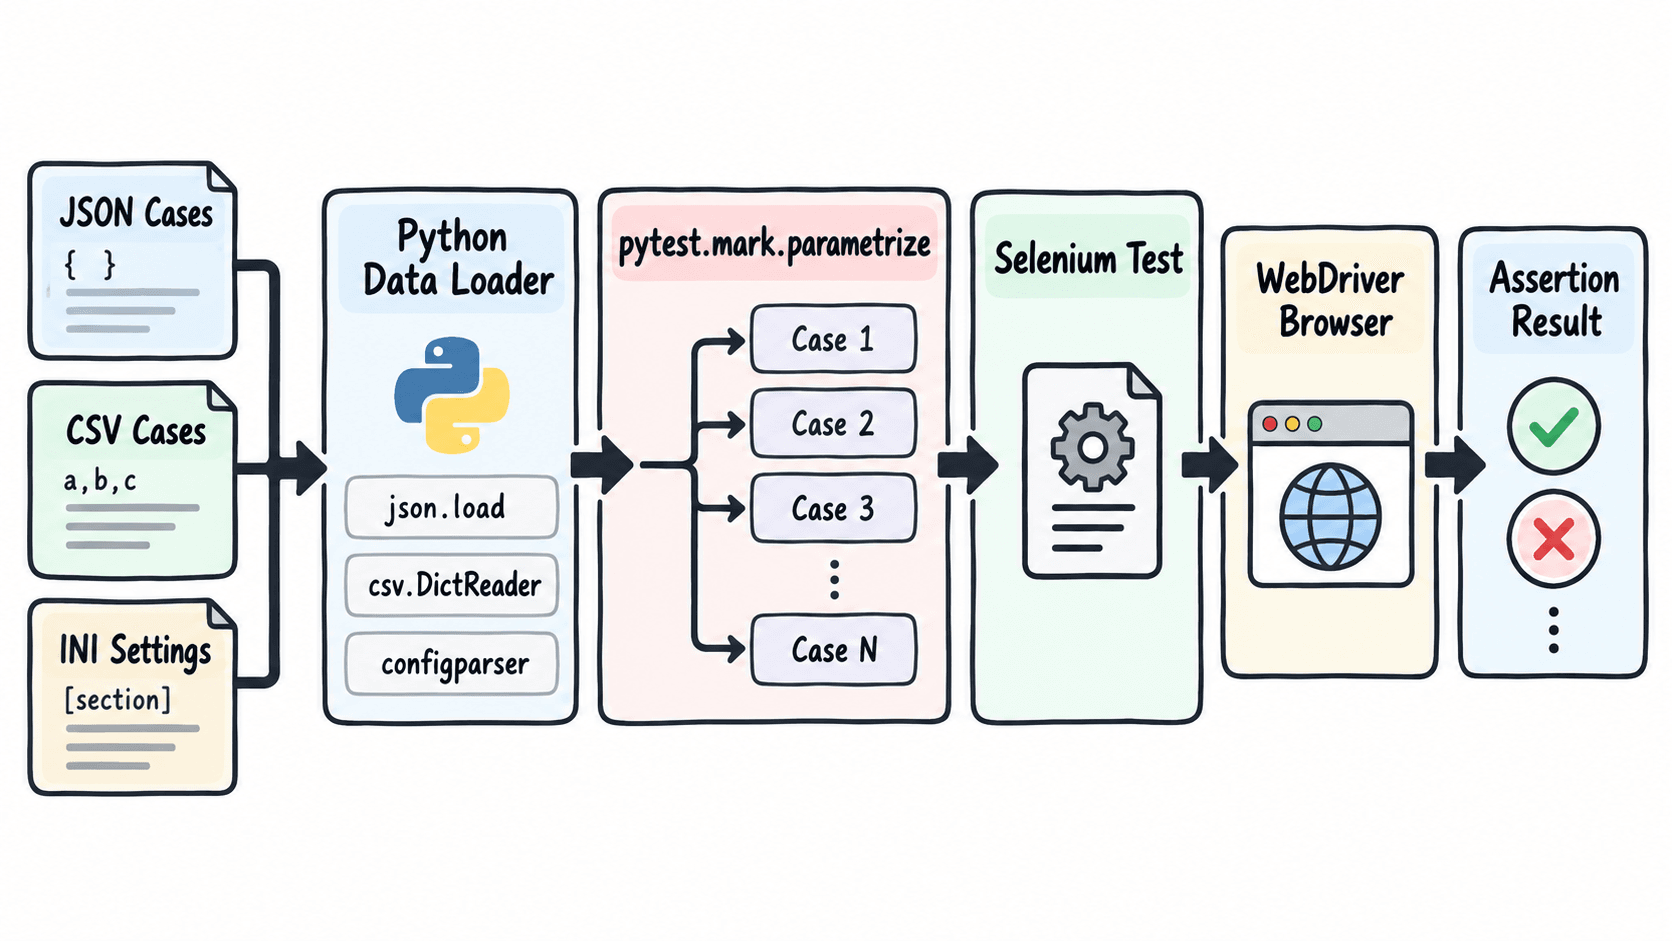
把账号、输入组合和环境参数写死在测试函数中,会让新增案例变成复制代码。将测试输入放进 JSON、CSV 或配置文件,再由统一加载器转换成 Python 数据,可以在不修改 Selenium 操作逻辑的情况下扩展测试覆盖面。
学习目标
- 根据数据结构选择 JSON、CSV 或配置文件。
- 将外部数据转换成可供pytest.mark.parametrize使用的测试案例。
- 处理路径、类型转换和敏感数据等常见边界问题。
根据数据形态选择文件格式
三种格式解决的问题不同,不必为了统一而强行只用一种:
| 格式 | 适合的数据 | 具体例子 |
|---|---|---|
| JSON | 有层级、字段可能扩展的案例 | 登录案例、订单对象、权限组合 |
| CSV | 列固定、案例数量较多的表格数据 | 100 组用户名与密码 |
| INI 配置 | 少量环境参数 | timeout=5、browser=chrome |
测试案例中可以保存公开的测试账号,但生产密码、访问令牌等秘密值不要提交到仓库,应从 CI Secret 或环境变量读取。
建立可重复的数据加载器
下面以登录测试为例。先创建cases.json,每个对象都包含稳定的 id,这样 pytest 报告会显示具体案例名称,而不是难以定位的序号。
[
  {
    "id": "valid-user",
    "username": "alice",
    "password": "123456",
    "expected": "登录成功"
  },
  {
    "id": "wrong-password",
    "username": "alice",
    "password": "wrong",
    "expected": "登录失败"
  }
]
再创建 settings.ini,把等待时间这类环境参数与业务数据分开。timeout 使用整数秒,示例取 5 秒。
[test]
timeout = 5
test_login_data.py同时负责加载文件和执行参数化 Selenium 测试。路径通过Path(file)计算,因此从项目根目录或其他工作目录启动 pytest 都能找到数据文件。
import configparser
import json
from pathlib import Path
from urllib.parse import quote

import pytest
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.support.ui import WebDriverWait

BASE_DIR = Path(__file__).resolve().parent


def load_json_cases(path):
    with path.open('r', encoding='utf-8') as file:
        return json.load(file)


def load_timeout(path):
    config = configparser.ConfigParser()
    config.read(path, encoding='utf-8')
    return config.getint('test', 'timeout')


CASES = load_json_cases(BASE_DIR / 'cases.json')
TIMEOUT = load_timeout(BASE_DIR / 'settings.ini')

HTML = '''
<input id="username">
<input id="password" type="password">
<button id="submit" onclick="login()">登录</button>
<p id="status"></p>
<script>
function login() {
  const ok = username.value === 'alice' && password.value === '123456';
  status.textContent = ok ? '登录成功' : '登录失败';
}
</script>
'''


@pytest.mark.parametrize('case', CASES, ids=lambda case: case['id'])
def test_login(case):
    options = webdriver.ChromeOptions()
    options.add_argument('--headless')
    driver = webdriver.Chrome(options=options)
    try:
        driver.get('data:text/html;charset=utf-8,' + quote(HTML))
        driver.find_element(By.ID, 'username').send_keys(case['username'])
        driver.find_element(By.ID, 'password').send_keys(case['password'])
        driver.find_element(By.ID, 'submit').click()

        # 外部配置决定等待上限,案例文件决定预期文本。
        WebDriverWait(driver, TIMEOUT).until(
            EC.text_to_be_present_in_element((By.ID, 'status'), case['expected'])
        )
        assert driver.find_element(By.ID, 'status').text == case['expected']
    finally:
        driver.quit()
安装了pytest、selenium且本机有 Chrome 后,在这三个文件所在目录运行:
python -m pytest -q预期输出
..                                                                       [100%]
2 passed in <TIME>s其中<TIME>取决于浏览器启动速度和机器性能,实际数字会不同。两条测试来自同一个测试函数,而不是复制出的两个函数。
换成 CSV 时保持测试逻辑不变
当案例主要由固定列组成时,CSV 更方便由测试人员批量编辑。可以把同样两条案例保存为cases.csv:
id,username,password,expected
valid-user,alice,123456,登录成功
wrong-password,alice,wrong,登录失败
对应加载器使用标准库 csv.DictReader。它返回的所有字段默认都是字符串,因此年龄、金额、布尔值等字段需要在加载阶段显式转换。
import csv


def load_csv_cases(path):
    with path.open('r', encoding='utf-8', newline='') as file:
        return list(csv.DictReader(file))
片段示例;它依赖上方测试文件中的路径和参数化逻辑。将案例加载行替换为下面这一行即可复用同一个测试函数:
CASES = load_csv_cases(BASE_DIR / 'cases.csv')CSV 中如果增加第三行案例,下次执行 pytest 就会自动增加一个参数化实例,不需要复制 Selenium 操作代码。
在加载阶段阻止坏数据进入浏览器
外部文件最常见的问题不是 Selenium 本身,而是字段缺失和类型错误。实际项目可以在创建 WebDriver 前验证必填字段,例如每条登录案例至少要包含 id、username、password、expected;缺少字段时立即终止测试收集,比浏览器启动后才报 KeyError 更容易定位。
配置参数同样要做边界限制。例如等待时间可以规定为 1~30 秒;config.getint()` 能完成字符串到整数的转换,但不会替你判断 300 秒是否合理。对于 URL、账号池和浏览器名称,也应在加载后先检查合法值,再交给 Selenium。
当测试数据的新增和页面操作代码能够独立修改时,数据驱动才真正发挥作用:新增案例只改数据文件,页面结构变化只改页面逻辑,两种变化不会互相复制代码。