
自动化测试 / 系统课时
配置并行测试
配置并行测试
并行执行能把 Selenium 套件的总耗时压下来,但前提是每个 worker 拥有独立浏览器会话、账号和测试数据。本篇使用 pytest-xdist 控制并发数量,并给出一套可以在本机 Chrome 或远程 Grid 上直接运行的最小示例。
学习目标
- 使用
pytest-xdist启动固定数量的并行 worker。 - 根据用例特征选择
load、loadscope或worksteal分配策略。 - 避免多个 worker 争用同一浏览器状态、账号、文件或后端数据。
先把并发数设成可控值
以下示例按 Python 3.10+、Selenium 4.50.0、pytest-xdist 3.8.0 编写。CI 中不要一开始就用 -n auto;浏览器比普通单元测试更吃 CPU 和内存,先固定 2~4 个 worker,更容易观察资源是否饱和。
python -m pip install -q "selenium==4.50.0" "pytest-xdist==3.8.0" pytest
python -c "from importlib.metadata import version; print(version('selenium'), version('pytest-xdist'))"
预期输出(最后一行):
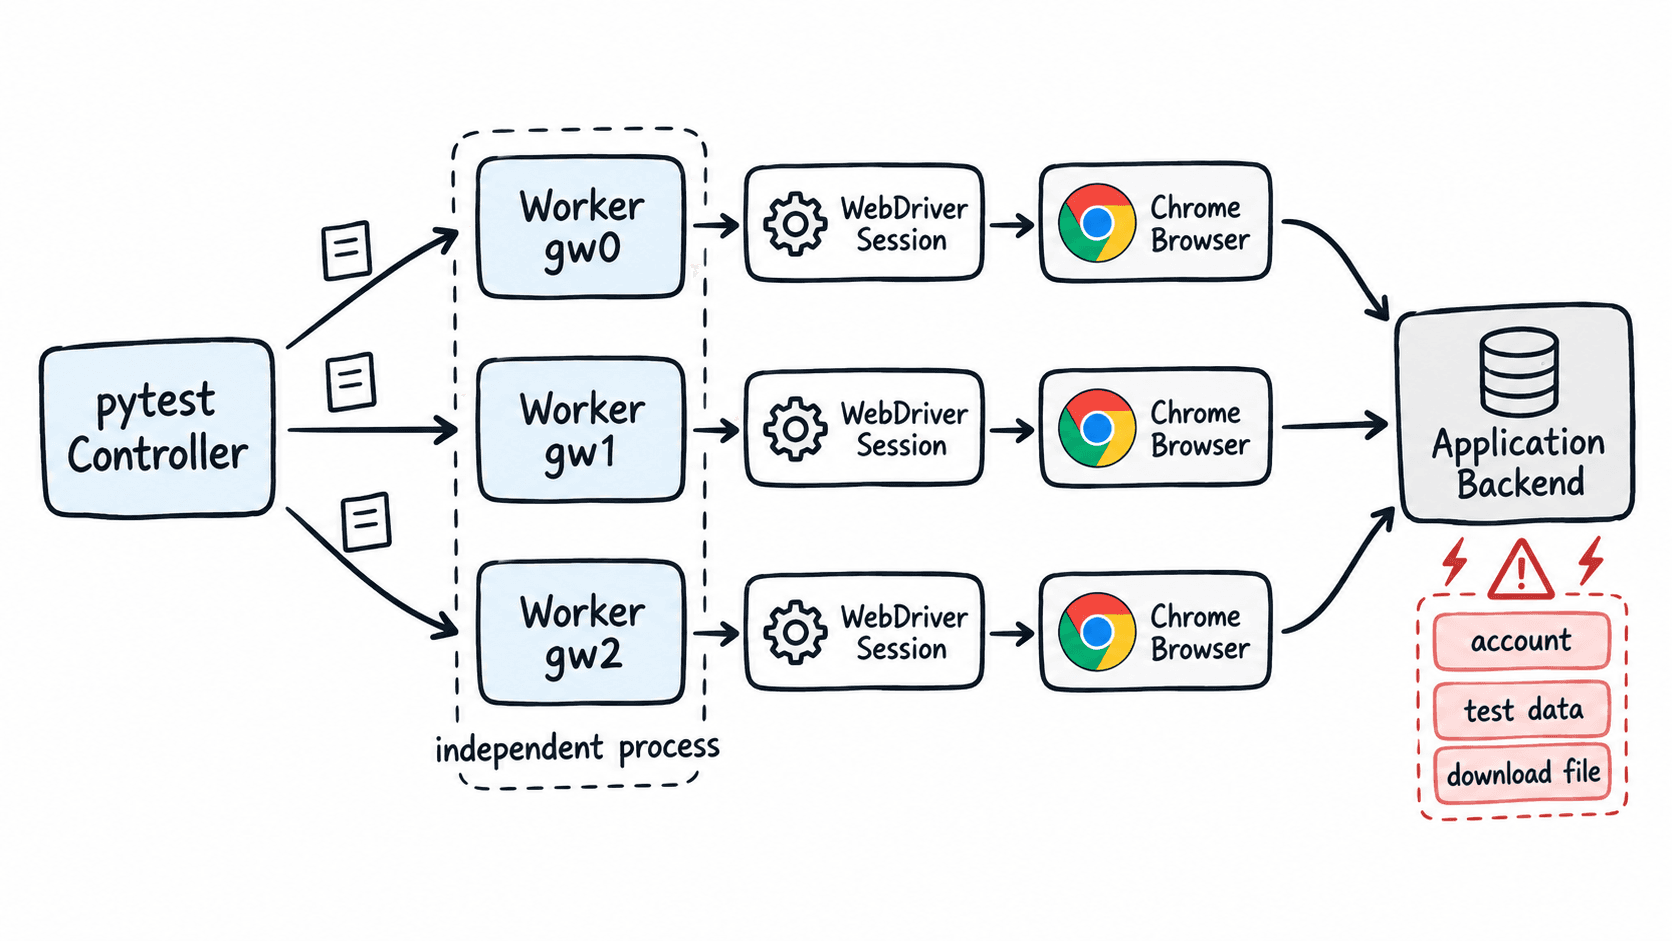
4.50.0 3.8.0并发上限应按实测资源决定。例如单个 Chrome 会话平均占用 1.1 GB,而 CI runner 可留给浏览器约 5 GB,则内存理论上限约为 4 个会话;实际可以先设 -n 3,给测试进程、截图和页面峰值留余量。
写一个能并行执行的 Selenium 用例
下面的测试每个 case 都创建自己的 WebDriver。若设置了 SELENIUM_REMOTE_URL,它会连接远程 Grid;否则直接启动本机 Chrome。页面使用 data: URL,因此测试本身不依赖外网。
import os
from urllib.parse import quote

import pytest
from selenium import webdriver
from selenium.webdriver.chrome.options import Options

@pytest.fixture
def driver():
    options = Options()
    options.add_argument("--headless=new")
    remote_url = os.getenv("SELENIUM_REMOTE_URL")

    browser = (
        webdriver.Remote(command_executor=remote_url, options=options)
        if remote_url
        else webdriver.Chrome(options=options)
    )
    browser.set_page_load_timeout(10)
    yield browser
    browser.quit()

@pytest.mark.parametrize("case_id", range(4))
def test_parallel_smoke(driver, case_id):
    html = f"<title>case-{case_id}</title><h1 id='marker'>case-{case_id}</h1>"
    driver.get("data:text/html;charset=utf-8," + quote(html))
    assert driver.title == f"case-{case_id}"
    assert driver.find_element("id", "marker").text == f"case-{case_id}"
预期结果:
pytest 能收集 4 个独立用例;每个用例创建并关闭自己的 WebDriver,会话之间不共享 Cookie。把代码保存为 tests/test_parallel.py 后,以两个 worker 执行:
pytest tests/test_parallel.py -n 2 --dist load -q预期输出(末行,实际耗时会不同):
4 passed in <TIME>s选择测试分配策略
-n 2 明确创建两个 worker。-n auto 会按物理 CPU 核心数推导 worker 数量;若希望自动探测但仍限制浏览器压力,可以使用 -n auto --maxprocesses=4。
| 参数 | 调度行为 | 适用场景 |
|---|---|---|
--dist load |
空闲 worker 领取待执行测试 | 用例彼此独立、耗时接近 |
--dist loadscope |
同一模块的函数、同一类的方法尽量放到同一 worker | 需要复用模块或类级 fixture |
--dist worksteal |
先分配任务,空闲 worker 再从繁忙 worker 窃取剩余任务 | 用例耗时差异很大 |
--dist loadgroup |
带相同 xdist_group 标记的测试固定在同一 worker |
某组测试必须共享受限资源 |
隔离浏览器和测试数据
并行失败最常见的原因不是 xdist,而是多个 worker 写入同一资源。把资源命名和生命周期做到可区分,失败才能稳定复现。
| 共享资源 | 容易出现的错误 | 推荐做法 |
|---|---|---|
| 测试账号 | 一个 worker 登出导致另一个会话失效 | 每个 worker 分配独立账号,如 e2e-gw0、e2e-gw1 |
| 下载目录 | 同名 report.csv 相互覆盖 |
使用 pytest 的 tmp_path 为每个测试生成独立目录 |
| 后端记录 | 固定订单号被并发修改或删除 | 测试数据 ID 加 worker 标识或 UUID |
| 浏览器实例 | 多个测试同时操作同一个 driver | 每个 worker 或每个测试创建独立 WebDriver |
若必须串行访问一个稀缺资源,不要依赖测试文件顺序;把相关测试归入同一个 xdist_group,或从并行套件中单独拆出。
用总耗时判断并发是否值得
先测串行基线,再逐步增加 worker。假设 40 条 UI 用例串行平均每条 12 秒,总耗时约 480 秒;使用 4 个 worker 后若实测 155 秒,加速比约为 3.1 倍,已经接近可接受范围。若提高到 6 个 worker 仍是 150 秒左右,瓶颈通常已转移到 Grid、应用后端、数据库或 CI 主机资源。
判断并发数时同时观察测试总耗时、失败率和浏览器启动时间。并发从 4 提到 6 只省 5 秒,却让失败率从 0% 升到 4%,就应把并发上限保留在 4,而不是继续堆 worker。