
自动化测试 / 系统课时
隔离测试账号与数据
隔离测试账号与数据
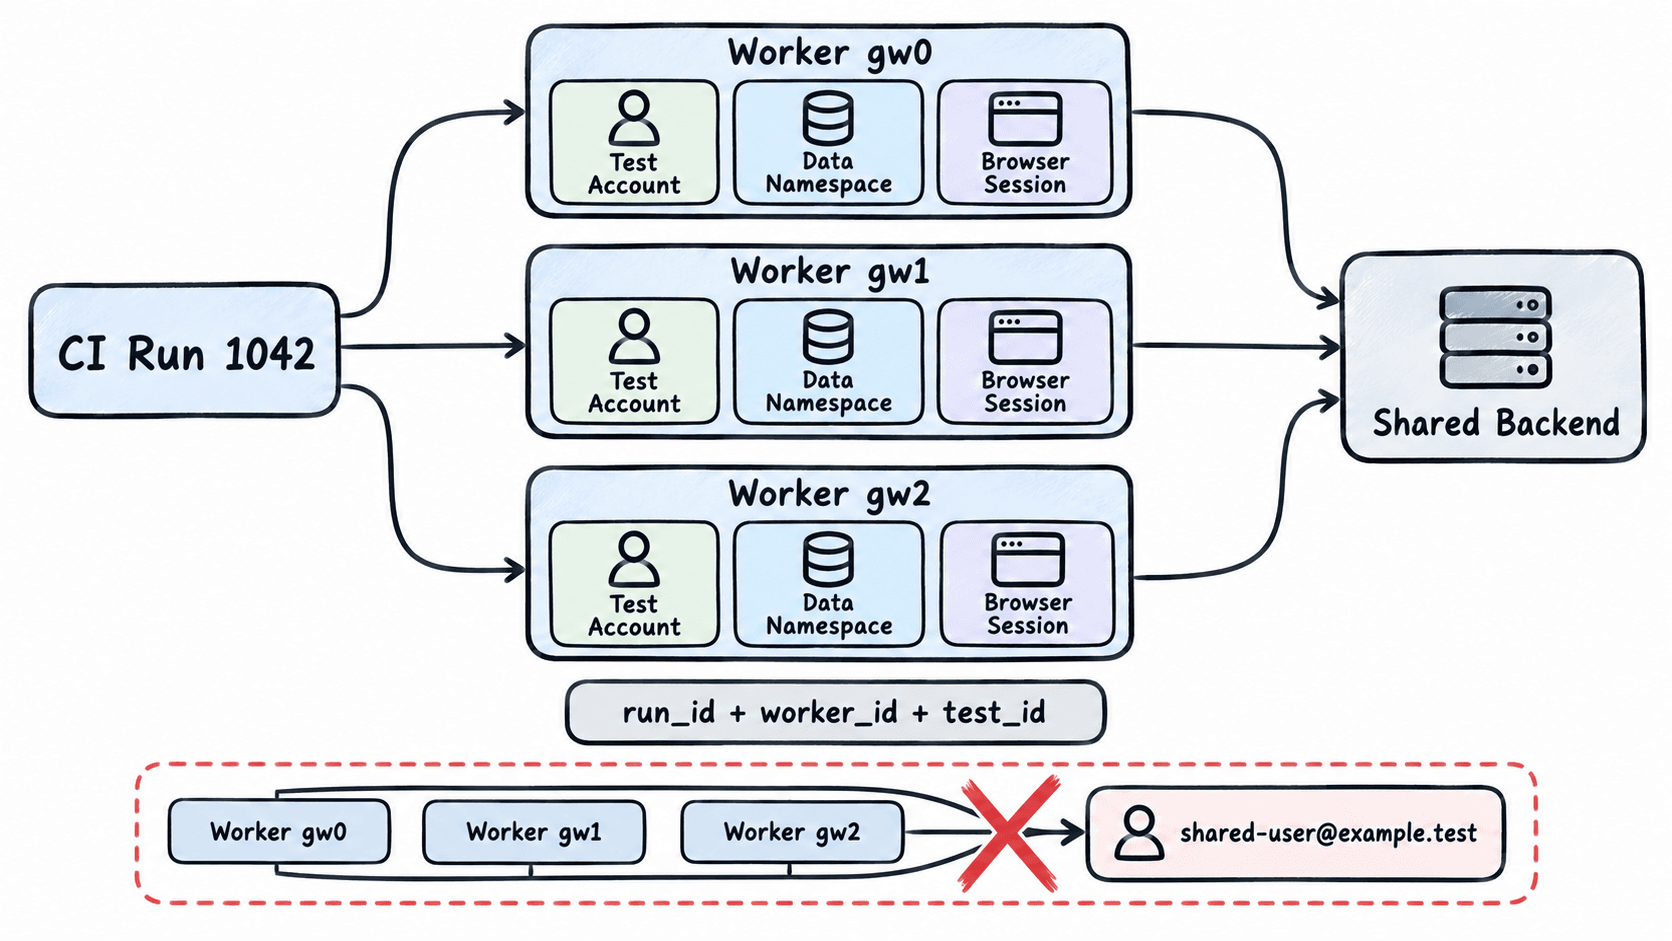
并行 Selenium 用例最常见的串扰来自共享后端,而不是浏览器窗口本身:两个 worker 同时使用同一账号、同一购物车或同一订单号,就会互相覆盖。本节用可计算的隔离键、账号容量规则和并行示例,把每个 worker 的数据边界明确下来。
学习目标
- 设计同时包含运行批次、worker 和用例身份的隔离键。
- 判断何时使用账号池,何时为每个测试动态创建账号。
- 验证两个并行浏览器只读写各自的数据集合。
隔离键要覆盖运行批次和并发维度
只在用户名后加 -1、-2 不够,因为下一次 CI 运行仍可能复用同样名字。推荐把隔离键拆成 run_id + worker_id + test_id,例如 e2e-1042-gw1-checkout。对应邮箱可以是 e2e-1042-gw1-checkout@example.test,订单外部号可以是 E2E-1042-GW1-001。
| 维度 | 示例 | 解决的问题 |
|---|---|---|
run_id |
1042 |
两次 CI 运行同时执行时不重名 |
worker_id |
gw1 |
同一批次并行 worker 不共享数据 |
test_id |
checkout |
同一 worker 内不同测试不互相覆盖 |
如果使用 pytest-xdist,worker 名通常可从环境变量 PYTEST_XDIST_WORKER 读取;未并行时可以回退为 main。CI 的运行批次号应由流水线注入到自定义环境变量,例如 CI_RUN_ID,不要假定所有 CI 平台都有同名变量。
用两个浏览器验证命名空间隔离
下面脚本启动一个本地共享 HTTP 服务,并同时打开两个 Chrome 会话。两个 worker 都写入同一个后端进程,但使用不同的 owner;服务端只返回当前 owner 的记录。这个模型对应真实测试环境中的“共享数据库 + 独立账号/租户/测试前缀”。
from concurrent.futures import ThreadPoolExecutor
from html import escape
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from threading import Lock, Thread
from urllib.parse import parse_qs, quote, urlparse

from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.support.ui import WebDriverWait

records = {}
lock = Lock()

class Handler(BaseHTTPRequestHandler):
    def log_message(self, format, *args):
        pass

    def do_GET(self):
        parsed = urlparse(self.path)
        query = parse_qs(parsed.query)
        owner = query.get("owner", [""])[0]

        if parsed.path == "/create":
            name = query.get("name", [""])[0]
            with lock:
                records.setdefault(owner, []).append(name)
            self.send_response(302)
            self.send_header("Location", f"/?owner={quote(owner)}")
            self.end_headers()
            return

        with lock:
            items = list(records.get(owner, []))

        rows = "".join(f"<li>{escape(item)}</li>" for item in items)
        page = f"""<!doctype html>
<meta charset="utf-8">
<form action="/create">
  <input type="hidden" name="owner" value="{escape(owner)}">
  <input id="name" name="name">
  <button id="create">Create</button>
</form>
<ul id="items">{rows}</ul>""".encode()

        self.send_response(200)
        self.send_header("Content-Type", "text/html; charset=utf-8")
        self.send_header("Content-Length", str(len(page)))
        self.end_headers()
        self.wfile.write(page)

server = ThreadingHTTPServer(("127.0.0.1", 0), Handler)
Thread(target=server.serve_forever, daemon=True).start()
base_url = f"http://127.0.0.1:{server.server_address[1]}"

def run_worker(worker_id):
    owner = f"e2e-local-{worker_id}"
    record = f"order-{worker_id}"
    driver = webdriver.Chrome()

    try:
        driver.get(f"{base_url}/?owner={quote(owner)}")
        driver.find_element(By.ID, "name").send_keys(record)
        driver.find_element(By.ID, "create").click()

        WebDriverWait(driver, 5).until(
            EC.text_to_be_present_in_element((By.ID, "items"), record)
        )
        assert driver.find_element(By.ID, "items").text.strip() == record
        return owner
    finally:
        driver.quit()

try:
    with ThreadPoolExecutor(max_workers=2) as pool:
        owners = sorted(pool.map(run_worker, ["gw0", "gw1"]))

    with lock:
        counts = {owner: len(records[owner]) for owner in sorted(records)}

    print("owners:", owners)
    print("counts:", counts)
finally:
    records.clear()
    server.shutdown()
预期输出:
owners: ['e2e-local-gw0', 'e2e-local-gw1']
counts: {'e2e-local-gw0': 1, 'e2e-local-gw1': 1}
本地 HTTP 端口由操作系统动态分配,实际值等价于 <PORT>。真实项目中应把 e2e-local-gw0 替换为带 CI 批次号的隔离键,例如 e2e-1042-gw0-checkout。
账号池容量必须不小于并发数
只读页面或权限校验常用预置账号池,因为创建账号可能较慢。若账号是 worker 级独占,最简单的容量规则是 可用账号数至少等于最大并发 worker 数。例如 CI 最大并发为 8,就准备至少 8 个互不共享业务状态的账号;只有 4 个账号却启动 8 个 worker,会让两个 worker 被迫共用身份。
写操作密集的用例更适合动态账号:测试开始创建、结束删除,并把隔离键写进用户名、租户或资源外部号。若账号创建耗时 4 秒,而整条 UI 用例耗时 90 秒,这 4 秒通常比排查随机串扰更便宜;若创建账号需要人工审批,则应改用足量的独占账号池。
把隔离条件写进验收和清理
隔离不是“命名看起来不同”就算完成。每个 worker 至少检查三件事:查询结果只包含自己的 isolation_key;新建资源的唯一字段没有与其他 worker 冲突;清理逻辑只匹配自己的前缀或精确 ID。日志也应同时记录 run_id、worker_id 和 test_id,这样失败后能直接定位是哪一组数据被污染。
如果一个用例必须观察另一个用例刚写入的数据,它们就不是独立测试。应把这两个步骤合并成一个完整场景,或把共享前置数据改成只读 fixture;否则并行调度顺序一变,结果就会从稳定断言退化成时序碰运气。