
架构与系统设计 / 系统课时
性能瓶颈排查
性能瓶颈排查
多租户系统变慢时,平均响应时间往往掩盖了热点租户和资源排队。本课建立一条从端到端基线到数据库、连接池、缓存与批量任务的定位路径,并给出可重复验证的修复顺序。
学习目标
- 使用分位延迟和资源等待指标建立性能基线
- 区分索引、连接池、热点租户、批量任务和缓存命中率问题
- 按收益与风险排序修复,并用压测结果完成验收
先建立可比较的基线
至少同时记录请求量、错误率、P50、P95、P99、数据库连接等待时间、慢 SQL 数量、缓存命中率和各租户流量占比。只看 CPU 或平均耗时,无法判断请求是在应用线程、连接池、数据库还是外部依赖处排队。
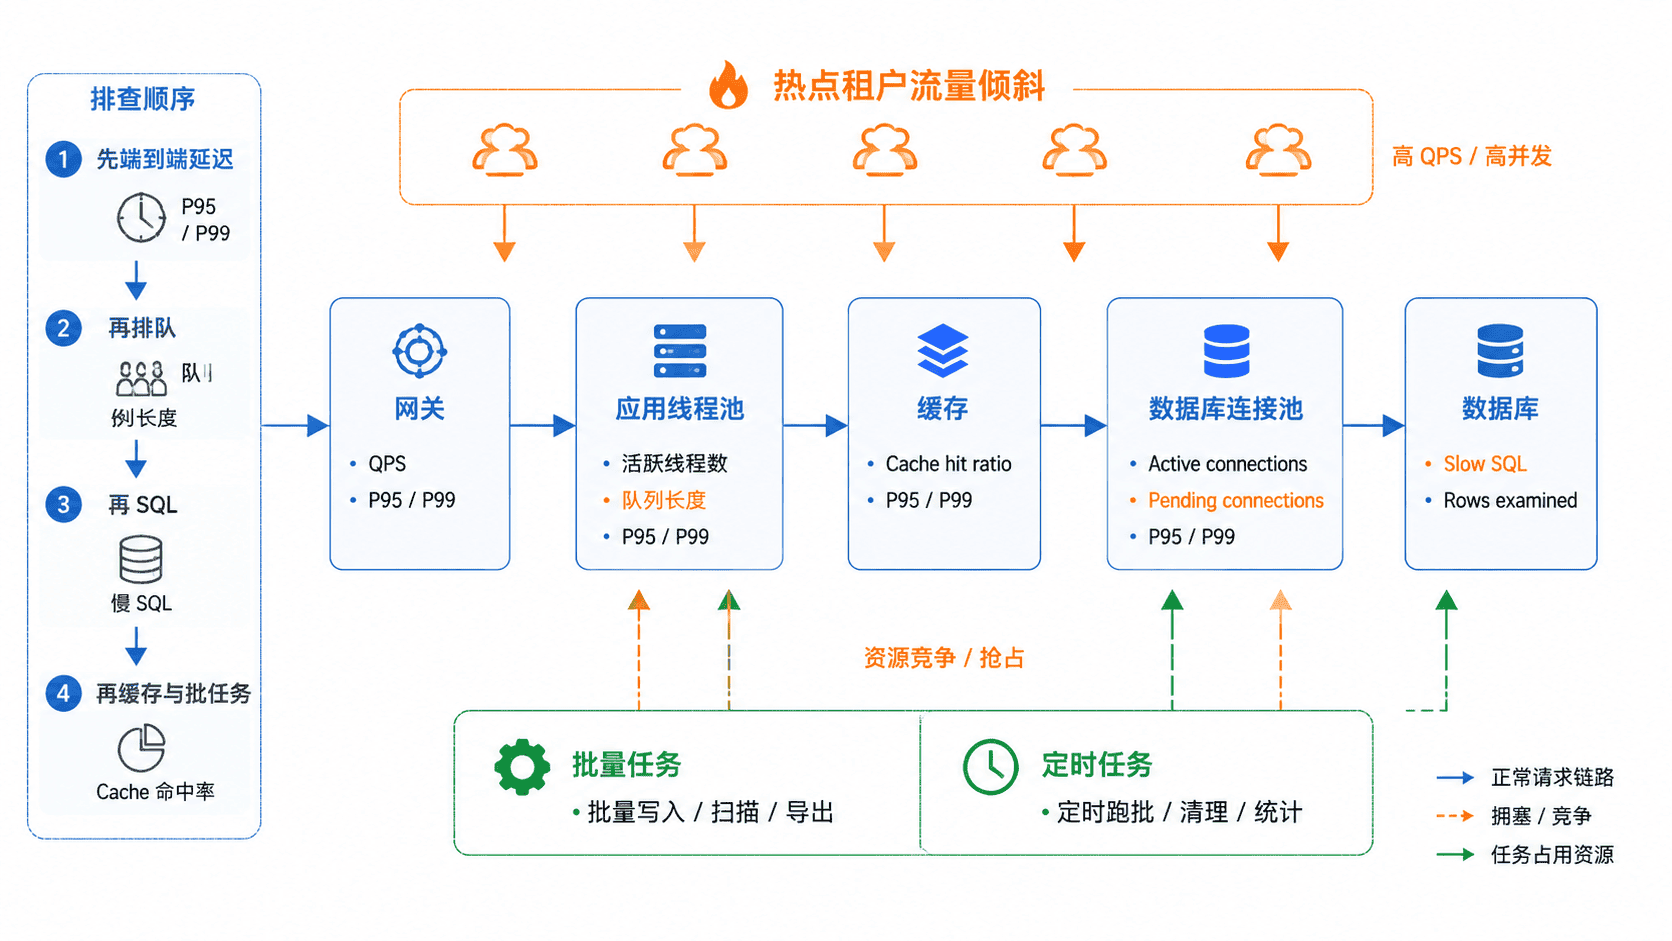
基线必须按租户拆分。全局 P95 正常但某个大租户 P99 很高,说明问题可能是数据量、查询路径或限额差异;所有租户同时变慢,则更像共享资源耗尽或批量任务争抢。
用采样脚本测量单租户延迟
下面的主示例创建并运行采样脚本,依赖 curl、sort 和 awk。实际 URL、租户 ID 和采样次数通过参数传入,便于对不同租户使用同一口径复测。
cat > probe-latency.sh <<'SCRIPT'
#!/usr/bin/env bash
set -euo pipefail

URL="${1:?usage: ./probe-latency.sh <URL> [TENANT_ID] [COUNT]}"
TENANT_ID="${2:-tenant-a}"
COUNT="${3:-20}"
RAW_FILE="$(mktemp)"
SORTED_FILE="$(mktemp)"
trap 'rm -f "$RAW_FILE" "$SORTED_FILE"' EXIT

for ((i = 1; i <= COUNT; i++)); do
  curl -sS -o /dev/null \
    -H "X-Tenant-Id: $TENANT_ID" \
    -w '%{time_total}\n' \
    "$URL" >> "$RAW_FILE"
done

sort -n "$RAW_FILE" > "$SORTED_FILE"

awk '
{
  sum += $1
  values[NR] = $1
}
END {
  p95 = int((NR * 95 + 99) / 100)
  if (p95 < 1) p95 = 1
  printf("count=%d avg=%.3fs p95=%.3fs\n", NR, sum / NR, values[p95])
}
' "$SORTED_FILE"
SCRIPT

chmod +x probe-latency.sh
./probe-latency.sh http://127.0.0.1:8080/api/orders tenant-a 20
预期输出:
count=20 avg=<AVG_SECONDS>s p95=<P95_SECONDS>s<AVG_SECONDS> 和 <P95_SECONDS> 会随环境变化。应对多个租户使用相同次数和相同接口重复执行,并保留修复前后的结果,避免把偶然波动误判为优化收益。
按证据识别瓶颈类型
| 现象 | 关键证据 | 优先处理 |
|---|---|---|
| 少数查询长期占据 P95 | rows examined 很高、执行计划未命中复合索引 |
调整查询条件和索引顺序 |
| 请求耗时高但 SQL 本身不慢 | 连接池 pending 增长、获取连接耗时高 |
缩短事务、排查连接泄漏,再评估池大小 |
| 单个租户拖慢全局 | 该租户 QPS、数据量或并发占比异常 | 配额、限流、分片或专属资源隔离 |
| 定时任务期间整体抖动 | 批任务与在线请求共享线程池或连接池 | 分批、错峰、独立资源池和租户级限速 |
| 数据库压力高且重复查询多 | 缓存命中率下降、穿透或批量失效 | 修复键设计、过期策略和回源保护 |
索引排查要从真实慢 SQL 开始。下面的 SQL 使用范围条件并保留 tenant_id 为复合索引前缀,适合验证订单列表查询是否命中 idx_orders_tenant_status_created。
EXPLAIN
SELECT id, status, created_at
FROM orders
WHERE tenant_id = 1001
  AND status = 'PAID'
  AND created_at >= '2026-08-03 00:00:00'
  AND created_at < '2026-08-04 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
预期结果:
key: idx_orders_tenant_status_created
type: range
Extra: Using index condition
实际 rows 会随数据量变化。若 key 为空、扫描行数远高于返回行数,或对索引列使用函数,应先改写 SQL,再决定是否新增索引,避免仅靠扩大连接池掩盖慢查询。
按收益顺序实施修复
第一优先级是消除确定性的高成本操作,例如全表扫描、过长事务和连接泄漏。第二优先级是减少共享资源竞争,包括热点租户限流、批任务错峰、独立线程池和分页处理。第三优先级才是扩大连接池或增加缓存容量,因为扩容可能把压力继续推向数据库。
缓存命中率不能只看全局值。按租户和业务域拆分后,检查是否存在某个租户频繁使用高基数键、统一过期时间导致雪崩,或批量删除触发集中回源。批量任务则应限制单批数据量,并在每批结束后释放事务和连接。
修复后的验收标准
使用相同接口、相同租户、相同请求次数复测,比较 P95 和 P99,而不是只比较平均值。数据库侧确认执行计划稳定命中目标索引,连接池等待接近零,缓存命中率恢复,批任务运行期间在线请求不再明显抖动。
性能验收还要观察一段完整业务周期。短时压测通过但高峰期再次恶化,通常说明热点租户、任务调度或容量模型仍未解决,而不是代码优化无效。
本课总结
- 性能排查必须同时观察分位延迟、资源等待和租户流量分布
- 索引与事务问题应先于连接池扩容处理,避免把瓶颈向下游转移
- 热点租户、批量任务和缓存策略需要按租户维度验证
下一课预告
下一课将把串租与性能排查方法整合为上线检查清单,用于发布前验证隔离性、稳定性和可观测性。