
架构与系统设计 / 系统课时
缓存穿透与污染防护
缓存穿透与污染防护
本课解决两类容易被混淆的问题:不存在的数据反复击穿缓存,以及错误租户键或共享对象把数据带到其他租户。完成后,你将建立一条从租户识别、查询、空值缓存到结果返回的完整防线。
学习目标
- 区分缓存穿透与缓存污染的根因。
- 正确使用租户级空值缓存,降低无效数据库查询。
- 防止错误键、上下文泄漏和共享可变对象造成串租。
两类风险的本质
缓存穿透是“查不到仍然反复查”。攻击者或异常调用不断请求不存在的资源,每次缓存未命中后都访问数据库。多租户场景中,若空值键没有租户段,一个租户的不存在结果还可能错误影响另一个租户。
缓存污染是“缓存里有值,但归属或内容不可信”。常见原因包括使用错误租户 ID 生成键、异步任务继承了旧线程上下文、数据库查询漏掉 tenant_id 条件,以及多个请求共享并修改同一个可变 DTO。
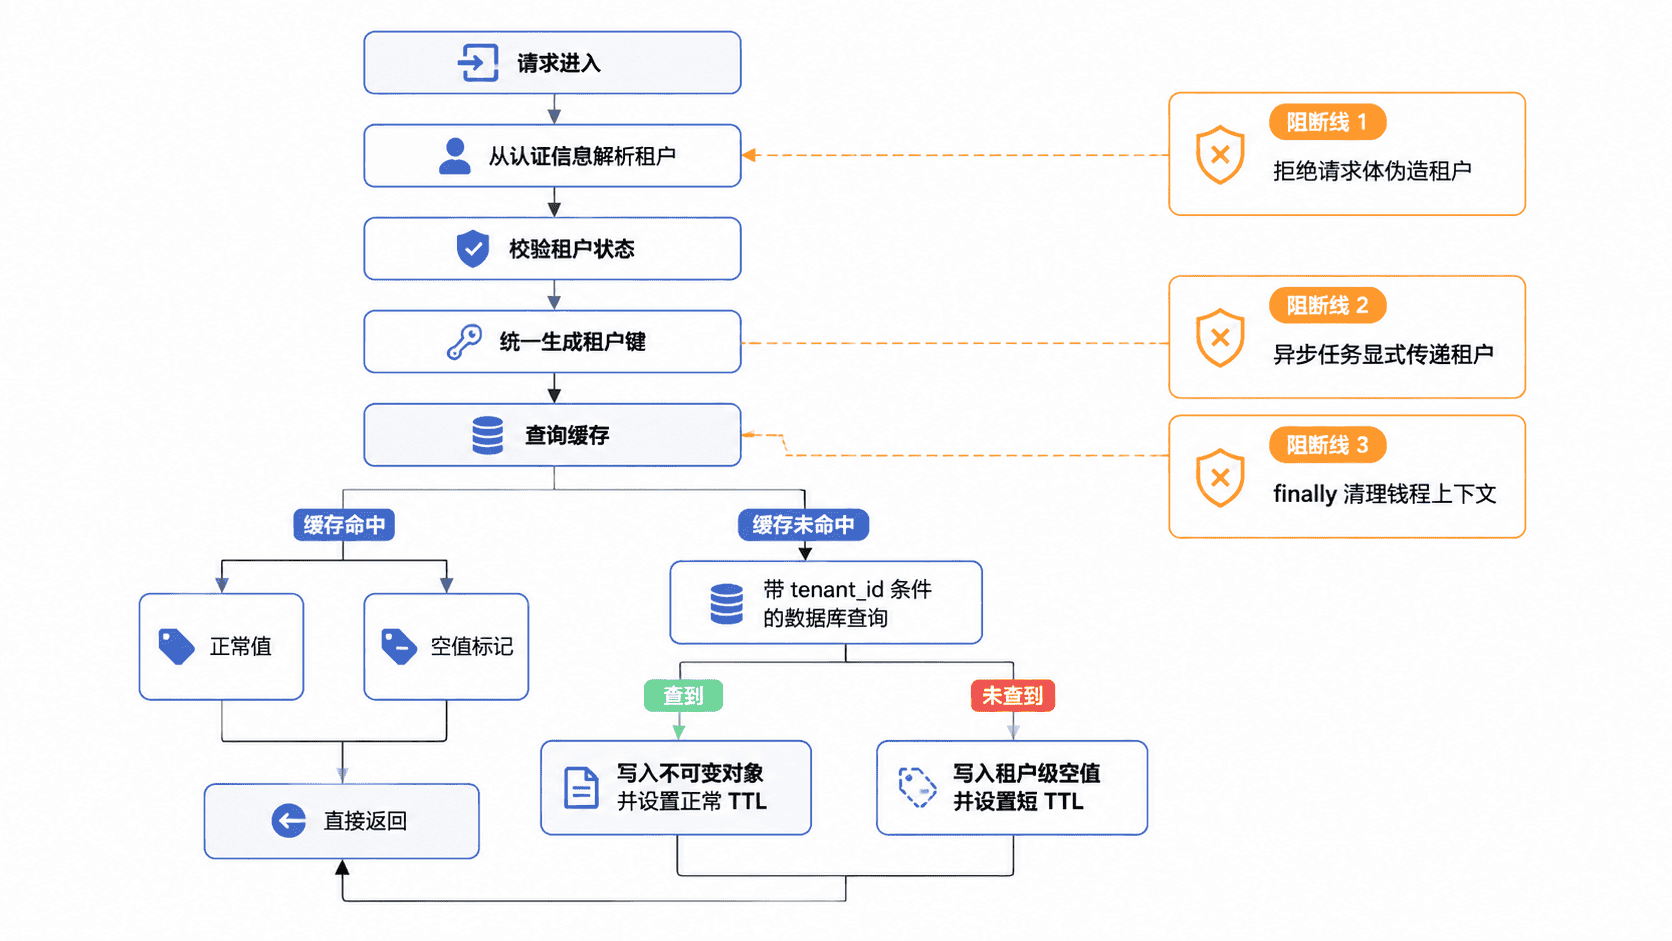
建立查询防线
安全查询应遵循固定顺序:先从令牌、域名或网关签名中解析可信租户,再校验租户状态,然后生成规范缓存键。数据库查询必须同时使用租户 ID 和业务 ID,不能先按业务 ID 查询后再在内存中过滤。
未查询到数据时,可以写入短 TTL 的空值标记,但这个标记必须属于当前租户。正常值适合较长 TTL,空值通常只保留几十秒,并加入少量随机抖动。对于可枚举且规模稳定的 ID,还可以在缓存之前增加布隆过滤器,但它不能替代数据库中的租户条件。
主示例:隔离正常值与空值
下面的 Java 17 示例使用两个租户相同的商品 ID,验证它们会返回各自的数据;不存在的商品第一次访问数据库,第二次命中租户级空值缓存。示例使用不可变 record,避免调用方修改缓存中的共享对象。
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.atomic.AtomicInteger;

public final class TenantSafeCacheDemo {
    // 使用不可变记录,避免调用方修改缓存中的共享对象。
    record ProductKey(String tenantId, String productId) {}
    record ProductView(String id, String name) {}
    record CacheEntry(
            ProductView value,
            boolean nullValue,
            long expireAtMillis) {}

    static final class ProductService {
        private final Map<ProductKey, ProductView> database = Map.of(
                new ProductKey("t1001", "p1"),
                new ProductView("p1", "Tenant A Plan"),
                new ProductKey("t2002", "p1"),
                new ProductView("p1", "Tenant B Plan")
        );

        private final Map<String, CacheEntry> cache =
                new ConcurrentHashMap<>();
        private final AtomicInteger dbQueries = new AtomicInteger();

        ProductView find(String tenantId, String productId) {
            // 键中始终包含可信租户,正常值与空值使用同一隔离规则。
            String key = buildKey(tenantId, productId);
            long now = System.currentTimeMillis();
            CacheEntry entry = cache.get(key);

            if (entry != null && entry.expireAtMillis() > now) {
                return entry.nullValue() ? null : entry.value();
            }

            dbQueries.incrementAndGet();
            ProductView row =
                    database.get(new ProductKey(tenantId, productId));

            // 空值只缓存 30 秒,正常值缓存 10 分钟。
            long ttlSeconds = row == null ? 30 : 600;
            cache.put(
                    key,
                    new CacheEntry(
                            row,
                            row == null,
                            now + ttlSeconds * 1000
                    )
            );
            return row;
        }

        int dbQueryCount() {
            return dbQueries.get();
        }

        private String buildKey(String tenantId, String productId) {
            // 缺少租户时直接失败,禁止回退到默认租户。
            if (tenantId == null || tenantId.isBlank()) {
                throw new IllegalArgumentException("tenantId 不能为空");
            }
            return "saas:prod:" + tenantId
                    + ":product:" + productId;
        }
    }

    public static void main(String[] args) {
        ProductService service = new ProductService();

        System.out.println(service.find("t1001", "p1"));
        System.out.println(service.find("t2002", "p1"));
        System.out.println(service.find("t1001", "missing"));
        System.out.println(service.find("t1001", "missing"));
        System.out.println("dbQueries=" + service.dbQueryCount());
    }
}
预期输出:
ProductView[id=p1, name=Tenant A Plan]
ProductView[id=p1, name=Tenant B Plan]
null
null
dbQueries=3
两次查询 missing 只产生一次数据库访问,因此计数为 3。真实项目还应给 TTL 加随机抖动,并在数据库层建立类似 (tenant_id, product_id) 的联合唯一键或联合索引。
防止污染的关键边界
租户上下文通常保存在请求作用域或 ThreadLocal 中。Web 过滤器必须在 finally 中清理;线程池、消息消费者和定时任务不能依赖调用线程遗留值,而应从任务参数或消息头显式恢复租户。
缓存对象应优先使用不可变 DTO。若必须返回可变集合,应在返回前复制,不能让调用方直接修改缓存实例。写缓存前还应校验查询结果的 tenantId 与当前上下文一致,发现不一致立即拒绝写入并记录安全日志。
| 风险 | 错误做法 | 防护 |
|---|---|---|
| 错误租户键 | 从请求体直接取租户 ID | 使用认证后的租户上下文 |
| 空值串租 | 使用 product:missing |
空值键同样包含租户段 |
| 数据库串租 | 只按业务 ID 查询 | SQL 强制包含 tenant_id |
| 对象污染 | 共享并修改缓存 DTO | 使用不可变对象或防御性复制 |
| 上下文泄漏 | 线程池复用旧 ThreadLocal |
显式传递并在 finally 清理 |
验证与监控
自动化测试至少覆盖三个场景:两个租户使用相同业务 ID 时返回不同结果;同一租户重复查询不存在数据时数据库只访问一次;异步任务缺少租户参数时应直接失败,而不是回退到默认租户。
监控指标应按租户和业务域统计缓存命中率、空值命中量、数据库回源量和租户键校验失败次数。若某个租户的空值命中突然升高,可能是爬虫、参数错误或上游 ID 生成异常,需要结合限流和审计日志处理。
本课总结
- 穿透通过租户级空值缓存、短 TTL 和必要的前置过滤控制。
- 污染必须同时从可信租户来源、数据库条件和对象不可变性三层阻断。
- 请求线程、异步任务和消息消费都要显式建立并清理租户上下文。
下一课预告
下一课将进入消息与异步任务隔离,学习如何在消息头、消费者上下文和失败重试中持续保持租户边界。