
架构与系统设计 / 系统课时
数据范围计算
数据范围计算
本课把用户任职、角色配置与组织树合并成一份可执行的访问范围,并给出可运行的 Java 计算器。完成后,你能把结果稳定地转换为查询条件,同时避免跨租户放大和空范围误放行。
学习目标
- 识别任职、角色范围和组织树在计算中的职责
- 实现多角色范围合并、组织后代展开与结果去重
- 将计算结果安全地映射到不同业务资源的查询条件
计算输入与合并流程
数据范围计算至少需要四类输入:当前租户、当前用户、有效任职、角色范围配置。组织树只负责展开组织层级,不能替代租户边界;任何角色即使配置为 ALL,也只能表示“当前租户全部数据”。
多角色通常采用允许范围并集。例如,一个角色允许组织 100,另一个角色允许商户 9001,最终结果同时包含两部分。若系统支持显式拒绝规则,应在允许范围合并后再应用拒绝规则,避免被其他角色重新放开。
空结果必须解释为“无权访问”,不能为了兼容查询而省略条件。只有确认存在 ALL 时,业务查询才可以不追加组织、门店或商户过滤条件。
计算顺序应固定为:校验租户与任职状态、收集有效角色、解析角色范围、展开组织后代、按资源类型去重、生成不可变结果。固定顺序便于缓存、审计和复现权限问题。
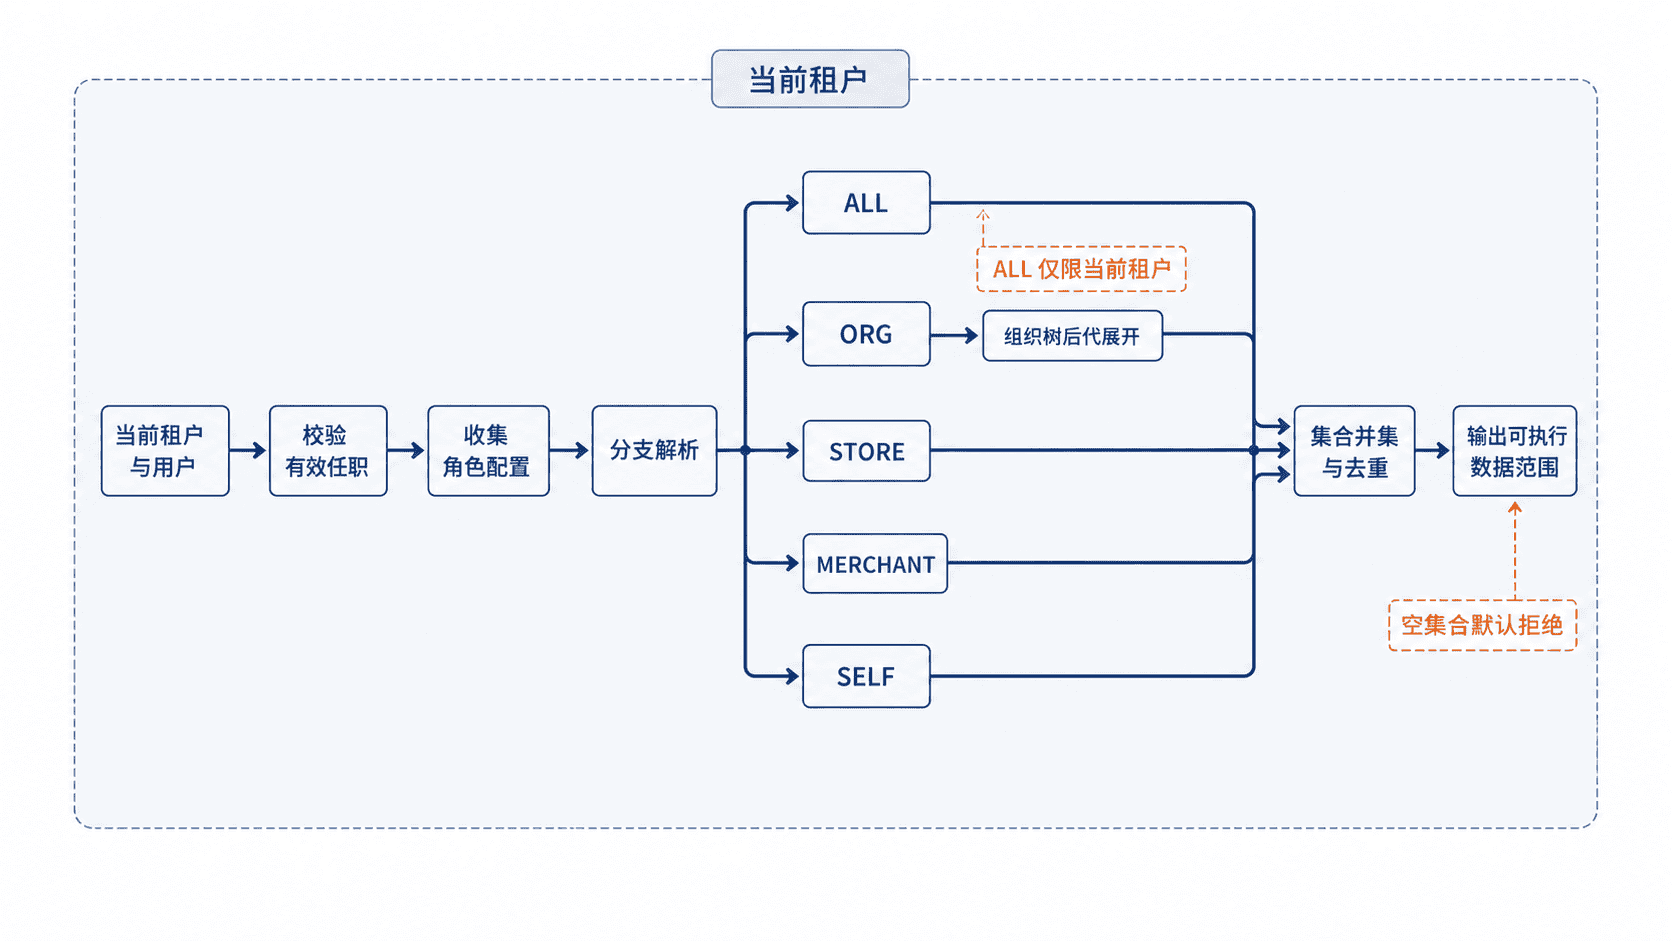
ORG 保存的是组织根节点时,需要把根节点本身与全部后代加入结果;STORE 和 MERCHANT 通常直接使用配置中的目标 ID;SELF 表示仅允许当前用户创建或负责的数据。不同资源类型不要提前混成一个 ID 集合,否则容易把组织 ID 误当成商户 ID。
可运行的最小实现
下面示例使用 Java 17,演示组织后代展开、多角色并集与 ALL 短路。生产环境还应在进入计算前过滤已停用角色、失效任职和不属于当前租户的目标 ID。
import java.util.ArrayList;
import java.util.Collections;
import java.util.HashMap;
import java.util.LinkedHashSet;
import java.util.List;
import java.util.Map;
import java.util.Set;

public class DataScopeCalculatorDemo {

    enum ScopeType {
        ALL, ORG, STORE, MERCHANT, SELF
    }

    record RoleScope(ScopeType type, Set<Long> targetIds) {
    }

    record ScopeResult(
            boolean all,
            Set<Long> orgIds,
            Set<Long> storeIds,
            Set<Long> merchantIds,
            Long selfUserId) {
    }

    static ScopeResult calculate(
            long currentUserId,
            List<RoleScope> roleScopes,
            Map<Long, Set<Long>> orgDescendants) {

        Set<Long> orgIds = new LinkedHashSet<>();
        Set<Long> storeIds = new LinkedHashSet<>();
        Set<Long> merchantIds = new LinkedHashSet<>();
        boolean self = false;

        for (RoleScope roleScope : roleScopes) {
            switch (roleScope.type()) {
                case ALL -> {
                    // ALL 只取消租户内的数据过滤,不得取消 tenant_id 条件。
                    return new ScopeResult(true, Set.of(), Set.of(), Set.of(), currentUserId);
                }
                case ORG -> {
                    for (Long rootOrgId : roleScope.targetIds()) {
                        Set<Long> expanded = orgDescendants.get(rootOrgId);
                        orgIds.addAll(expanded == null ? Set.of(rootOrgId) : expanded);
                    }
                }
                case STORE -> storeIds.addAll(roleScope.targetIds());
                case MERCHANT -> merchantIds.addAll(roleScope.targetIds());
                case SELF -> self = true;
            }
        }

        return new ScopeResult(
                false,
                Collections.unmodifiableSet(new LinkedHashSet<>(orgIds)),
                Collections.unmodifiableSet(new LinkedHashSet<>(storeIds)),
                Collections.unmodifiableSet(new LinkedHashSet<>(merchantIds)),
                self ? currentUserId : null);
    }

    public static void main(String[] args) {
        Map<Long, Set<Long>> orgTree = new HashMap<>();
        orgTree.put(100L, new LinkedHashSet<>(List.of(100L, 101L, 102L)));

        List<RoleScope> roles = new ArrayList<>();
        roles.add(new RoleScope(ScopeType.ORG, Set.of(100L)));
        roles.add(new RoleScope(ScopeType.MERCHANT, Set.of(9001L)));
        roles.add(new RoleScope(ScopeType.SELF, Set.of()));

        ScopeResult result = calculate(42L, roles, orgTree);
        System.out.println("all=" + result.all());
        System.out.println("orgIds=" + result.orgIds());
        System.out.println("storeIds=" + result.storeIds());
        System.out.println("merchantIds=" + result.merchantIds());
        System.out.println("selfUserId=" + result.selfUserId());
    }
}
预期输出如下。示例使用 LinkedHashSet 保留组织展开和角色合并顺序。
all=false
orgIds=[100, 101, 102]
storeIds=[]
merchantIds=[9001]
selfUserId=42
接入查询与关键边界
计算结果不能直接拼成一条通用 SQL,而应交给资源适配器转换。订单查询可以使用 tenant_id = ? 作为永久条件,再依据订单所属模型追加 org_id IN (...)、store_id IN (...)、merchant_id IN (...) 或 owner_user_id = ?。不适用于该资源的集合应被忽略,而不是与其他字段随意做 OR。
组织树缓存必须按租户隔离,并在组织移动、停用或删除后失效。展开时要检测环路和不存在的节点;发现异常时应拒绝授权并记录审计日志,不能回退成 ALL。
验证至少覆盖三组情况:单角色只返回配置范围;多角色返回并集且去重;无有效任职时结果为空并拒绝查询。租户管理员还要验证只能访问本租户,平台管理员则应通过独立的受控入口处理,不能复用普通业务接口绕过过滤器。
本课总结
- 数据范围计算先守住租户边界,再合并任职、角色和组织树结果
- 多角色允许范围通常取并集,空范围必须默认拒绝
- 计算结果应按资源类型适配查询,不能拼成跨字段的万能条件
下一课预告
下一课将把这些范围规则转化为跨租户、跨组织、水平越权和管理员边界测试,验证授权逻辑在真实接口上不会被绕过。