
架构与系统设计 / 系统课时
租户指标与告警
租户指标与告警
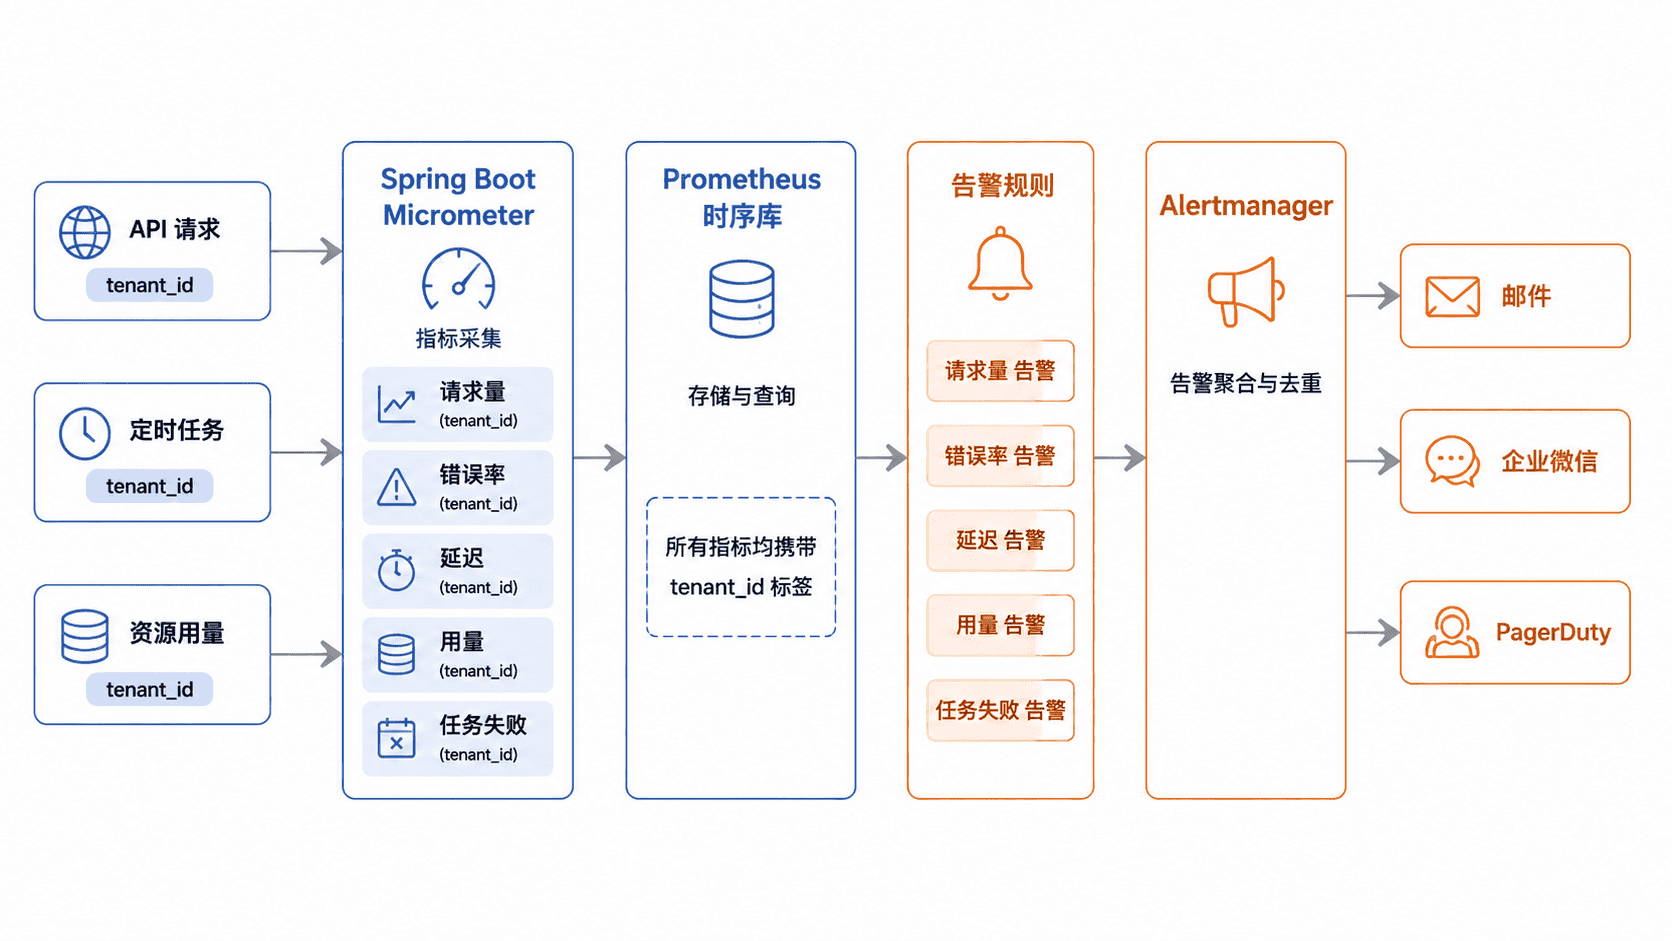
本课建立一套可直接落地的租户级监控方案:在不泄露业务数据的前提下,为每个租户统计请求量、错误率、延迟、用量和任务失败,并把异常自动路由到告警渠道。
学习目标
- 设计可聚合、可告警且不会失控的租户指标标签
- 使用 Micrometer 采集请求、用量和后台任务指标
- 编写按租户计算错误率与失败次数的告警规则
设计租户指标模型
租户监控应围绕请求、错误、延迟、资源用量和异步任务五类信号展开。指标名保持稳定,租户差异放在 tenant_id 标签中;接口只记录归一化路由,如 /orders/{id},不要把订单号、用户 ID 或原始 URL 放进标签,否则会造成时序数量爆炸。
| 目标 | 指标 | 推荐类型 | 关键标签 |
|---|---|---|---|
| 请求量与错误率 | saas_tenant_requests_total |
Counter | tenant_id、route、outcome |
| 请求延迟 | saas_tenant_request_latency |
Timer | tenant_id、route |
| 资源用量 | saas_tenant_usage_units_total |
Counter | tenant_id、resource |
| 任务失败 | saas_tenant_job_failures_total |
Counter | tenant_id、job |
在应用中采集指标
下面的组件可直接放入已引入 Spring Boot Actuator 和 Micrometer 的项目。请求结束时调用 recordRequest,计量事件发生时调用 recordUsage,后台任务失败时调用 recordJobFailure。延迟使用直方图,便于 Prometheus 计算分位数。
package com.example.observability;

import io.micrometer.core.instrument.Counter;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.Timer;
import org.springframework.stereotype.Component;

import java.time.Duration;

@Component
public class TenantMetrics {

    private final MeterRegistry registry;

    public TenantMetrics(MeterRegistry registry) {
        this.registry = registry;
    }

    public void recordRequest(
            String tenantId, String route, int status, Duration latency) {
        String outcome = status >= 500 ? "error" : "success";

        Counter.builder("saas_tenant_requests_total")
                .tag("tenant_id", tenantId)
                .tag("route", route)
                .tag("outcome", outcome)
                .register(registry)
                .increment();

        Timer.builder("saas_tenant_request_latency")
                .tag("tenant_id", tenantId)
                .tag("route", route)
                .publishPercentileHistogram()
                .register(registry)
                .record(latency);
    }

    public void recordUsage(String tenantId, String resource, double units) {
        Counter.builder("saas_tenant_usage_units_total")
                .tag("tenant_id", tenantId)
                .tag("resource", resource)
                .register(registry)
                .increment(units);
    }

    public void recordJobFailure(String tenantId, String job) {
        Counter.builder("saas_tenant_job_failures_total")
                .tag("tenant_id", tenantId)
                .tag("job", job)
                .register(registry)
                .increment();
    }
}
暴露 Prometheus 端点后,先触发一次业务请求,再检查指标。实际端口可能不同。
curl -s http://localhost:<PORT>/actuator/prometheus | grep 'saas_tenant_'预期输出
saas_tenant_requests_total{outcome="success",route="/orders/{id}",tenant_id="tenant-a"} 1.0
saas_tenant_usage_units_total{resource="api_call",tenant_id="tenant-a"} 1.0
编写按租户告警规则
下面的 Prometheus 规则分别检测五分钟错误率超过 5% 和十分钟内任务失败次数增加。for 用于过滤瞬时抖动,告警标签保留 tenant_id,便于 Alertmanager 路由到对应租户负责人。
groups:
  - name: tenant-alerts
    rules:
      - alert: TenantHighErrorRate
        expr: |
          (
            sum by (tenant_id) (
              rate(saas_tenant_requests_total{outcome="error"}[5m])
            )
            /
            sum by (tenant_id) (
              rate(saas_tenant_requests_total[5m])
            )
          ) > 0.05
          and on (tenant_id)
          sum by (tenant_id) (
            increase(saas_tenant_requests_total[5m])
          ) >= 100
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "租户 {{ $labels.tenant_id }} 错误率持续超过 5%"

      - alert: TenantJobFailure
        expr: |
          increase(saas_tenant_job_failures_total[10m]) > 0
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "租户 {{ $labels.tenant_id }} 出现后台任务失败"
将规则文件加载到 Prometheus 后执行校验。
promtool check rules <PATH>/tenant-alerts.yml预期输出
Checking <PATH>/tenant-alerts.yml
  SUCCESS: 2 rules found
控制告警噪声与数据规模
告警必须同时设置阈值、持续时间和最小流量条件。低流量租户可用“错误次数”替代“错误率”,避免一次失败就形成 100% 错误率;高流量租户则适合错误率、P95 延迟和配额消耗比例。
标签值应来自受控枚举。不要使用原始异常信息、请求参数、手机号或订单号作为标签。对于租户数量极大的平台,可将实时明细保留较短时间,再把小时级聚合结果写入长期存储。
本课总结
- 租户指标应覆盖请求、错误、延迟、用量和任务失败,并使用受控标签
- Micrometer 负责采集,Prometheus 负责聚合,Alertmanager 负责路由通知
- 告警规则要加入持续时间、最小流量和标签基数控制,避免噪声与成本失控
下一课预告
下一课将从监控进入安全治理,完成传输加密、敏感字段脱敏、密钥托管和最小权限访问设计。