
架构与系统设计 / 系统课时
用量统计与预警
用量统计与预警
本课完成一套可落地的用量预警方案:按租户采集资源消耗,计算额度使用率,在接近上限时分级提醒,并通过去重机制避免同一阈值被反复通知。
学习目标
- 设计“已用量、总额度、使用率、统计周期”四个核心字段
- 实现多级阈值判断与预警去重
- 建立从采集、计算到通知和验证的完整链路
明确统计口径
用量统计必须先回答“统计什么、按什么周期统计、额度从哪里来”。例如 API 调用次数适合按月累计,存储空间通常统计当前占用量,成员数量则统计当前有效成员数。
每条用量记录至少包含租户、资源类型、统计周期、已用量和更新时间。总额度不应复制到用量表中,而应从租户当前生效的套餐或配额覆盖项读取,避免套餐调整后出现两套额度。
使用率的计算公式为:
当总额度为无限制时,不参与阈值预警;当总额度为零时,应直接视为不可用,而不是进行除法计算。
设计采集与预警链路
推荐把“业务计数”和“预警判断”解耦。业务请求只负责记录增量或更新当前值,定时任务再汇总用量、读取额度、计算等级并发送通知。这样不会把邮件、短信或站内信延迟带入主业务链路。
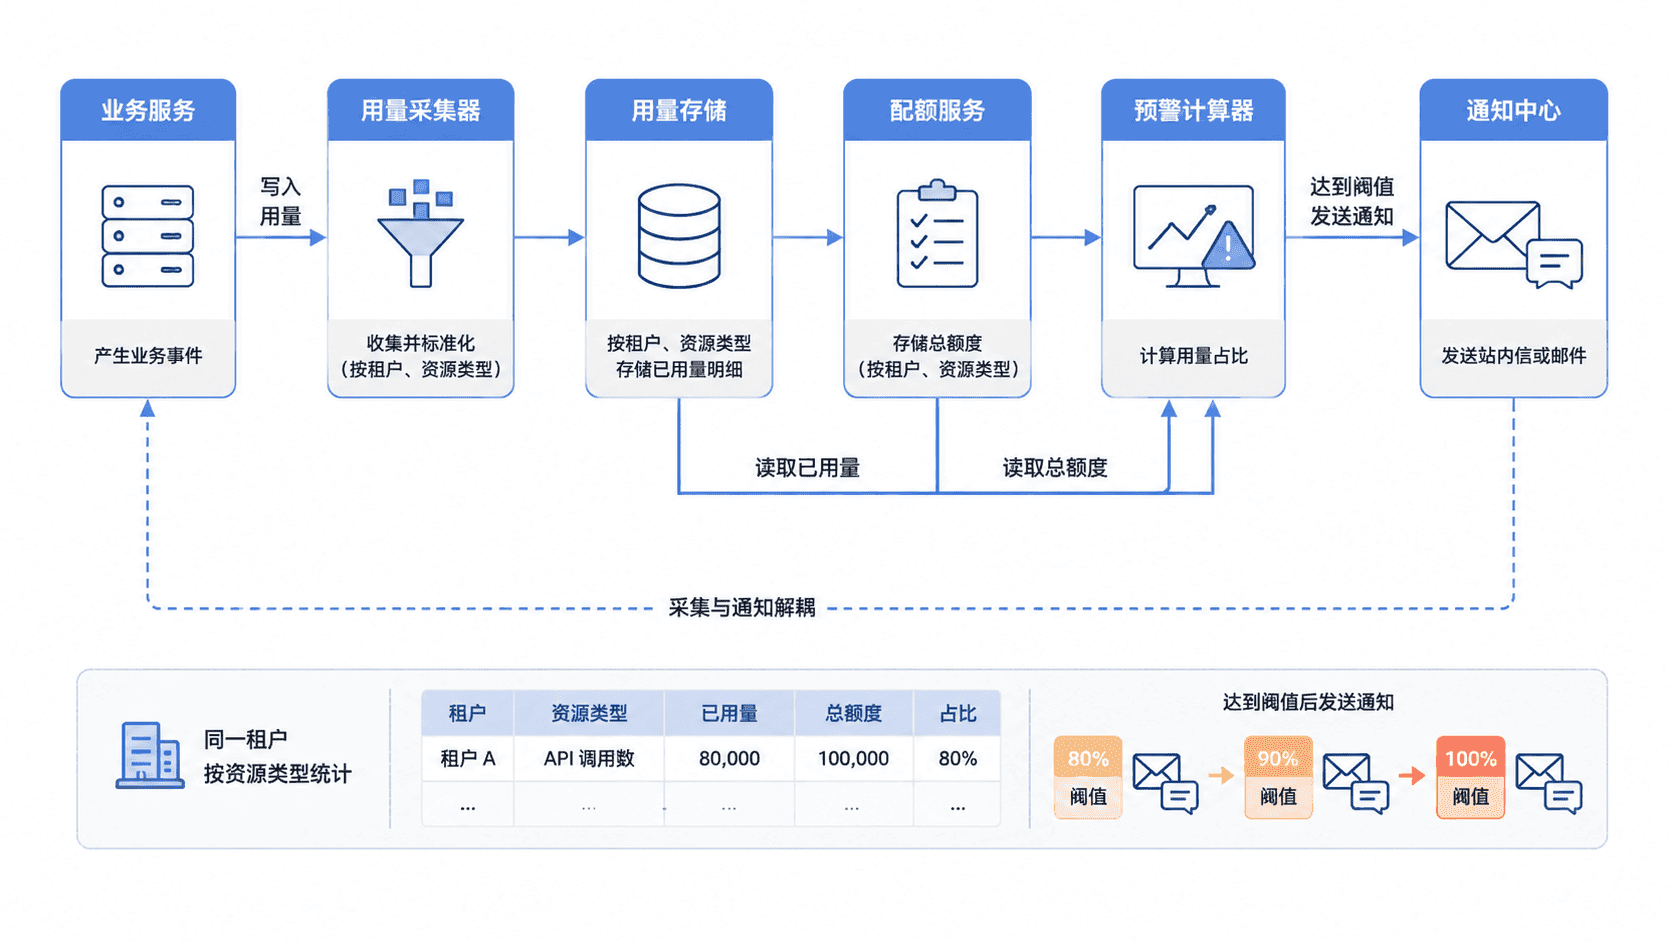
阈值通常分为提醒、严重和耗尽三级。实际比例可以按资源类型配置,例如存储空间使用 80%、90%、100%,而 API 调用量可以增加 70% 的提前提醒。
实现阈值判断与去重
下面的完整 Java 示例根据已用量和总额度判断预警级别,并使用“租户 + 资源 + 周期 + 级别”组成去重键。相同周期内,同一级别只发送一次;进入更高等级时仍会再次提醒。
import java.util.HashSet;
import java.util.Set;

public class UsageWarningDemo {

    enum Level {
        NONE, NOTICE, CRITICAL, EXHAUSTED
    }

    record Usage(String tenantId, String resource, long used, long limit, String period) {
    }

    private static final Set<String> SENT_KEYS = new HashSet<>();

    public static void main(String[] args) {
        check(new Usage("tenant-1001", "API_CALL", 8_200, 10_000, "2026-08"));
        check(new Usage("tenant-1001", "API_CALL", 9_200, 10_000, "2026-08"));
        check(new Usage("tenant-1001", "API_CALL", 9_200, 10_000, "2026-08"));
        check(new Usage("tenant-1001", "API_CALL", 10_000, 10_000, "2026-08"));
    }

    static void check(Usage usage) {
        Level level = evaluate(usage.used(), usage.limit());
        if (level == Level.NONE) {
            return;
        }

        String key = usage.tenantId() + ":" + usage.resource()
                + ":" + usage.period() + ":" + level;

        // 只有首次进入该等级时才发送,避免定时任务重复提醒
        if (SENT_KEYS.add(key)) {
            double rate = usage.used() * 100.0 / usage.limit();
            System.out.printf("%s %.1f%% %s%n", usage.resource(), rate, level);
        }
    }

    static Level evaluate(long used, long limit) {
        if (limit <= 0 || used >= limit) {
            return Level.EXHAUSTED;
        }

        double rate = used * 1.0 / limit;
        if (rate >= 0.9) {
            return Level.CRITICAL;
        }
        if (rate >= 0.8) {
            return Level.NOTICE;
        }
        return Level.NONE;
    }
}
预期输出:
API_CALL 82.0% NOTICE
API_CALL 92.0% CRITICAL
API_CALL 100.0% EXHAUSTED
示例中的集合只用于演示。生产环境应把去重键存入具有唯一约束的预警记录表,或写入带过期时间的 Redis;周期结束后自然生成新的去重键,不需要手工清理历史记录。
处理采集误差与并发
计数型资源优先使用原子增量,避免并发请求覆盖彼此结果。当前值型资源则应定期全量校准,例如每天重新统计对象存储大小,修正事件丢失或重复消费造成的偏差。
预警任务还要记录本次计算使用的已用量、总额度和套餐版本。这样即使套餐在任务执行期间发生变化,也能解释为什么当时触发了某一级别的提醒。
Tips:预警不是限流。预警负责通知,真正阻止继续使用的逻辑应由配额校验或限流组件执行。
验证预警是否可靠
验收时至少覆盖四种情况:低于首个阈值不通知;首次跨过阈值只通知一次;继续增长到更高阈值再次通知;套餐扩容后使用率下降,不再沿用旧额度判断。
还应检查通知内容是否包含租户、资源名称、已用量、总额度、使用率、统计周期和处理入口。动态时间、任务编号等字段在不同环境中可能不同,不应作为自动化断言的固定值。
本课总结
- 用量记录负责保存事实,套餐或覆盖配额负责提供额度,两者不要混存
- 预警应采用分级阈值,并以租户、资源、周期和等级构造幂等键
- 采集、计算、通知和强制限制应解耦,分别验证
下一课预告
下一课将处理套餐升级、降级、到期宽限和能力回收,建立可预测的订阅状态转换规则。