
命令行与文本处理 / 系统课时
批量处理大型文件
批量处理大型文件
本课解决大型日志或数据文件无法一次性载入内存的问题。你将用 StreamReader 逐行读取、按固定数量分批转换,并通过长期保持打开的 StreamWriter 增量写出结果,从而让内存占用主要由批次大小决定。
学习目标
- 区分一次性加载、流式读取与分批处理
- 实现可复用的读取、批处理和增量写入流程
- 使用计数与结果复读验证处理完整性
为什么一次性加载会失控
把 Get-Content 或 Import-Csv 的全部结果赋给变量,以及调用 ReadAllLines(),都会让大量字符串和对象同时驻留内存。文件转换为 PowerShell 对象后往往占用更多空间,并增加垃圾回收暂停。
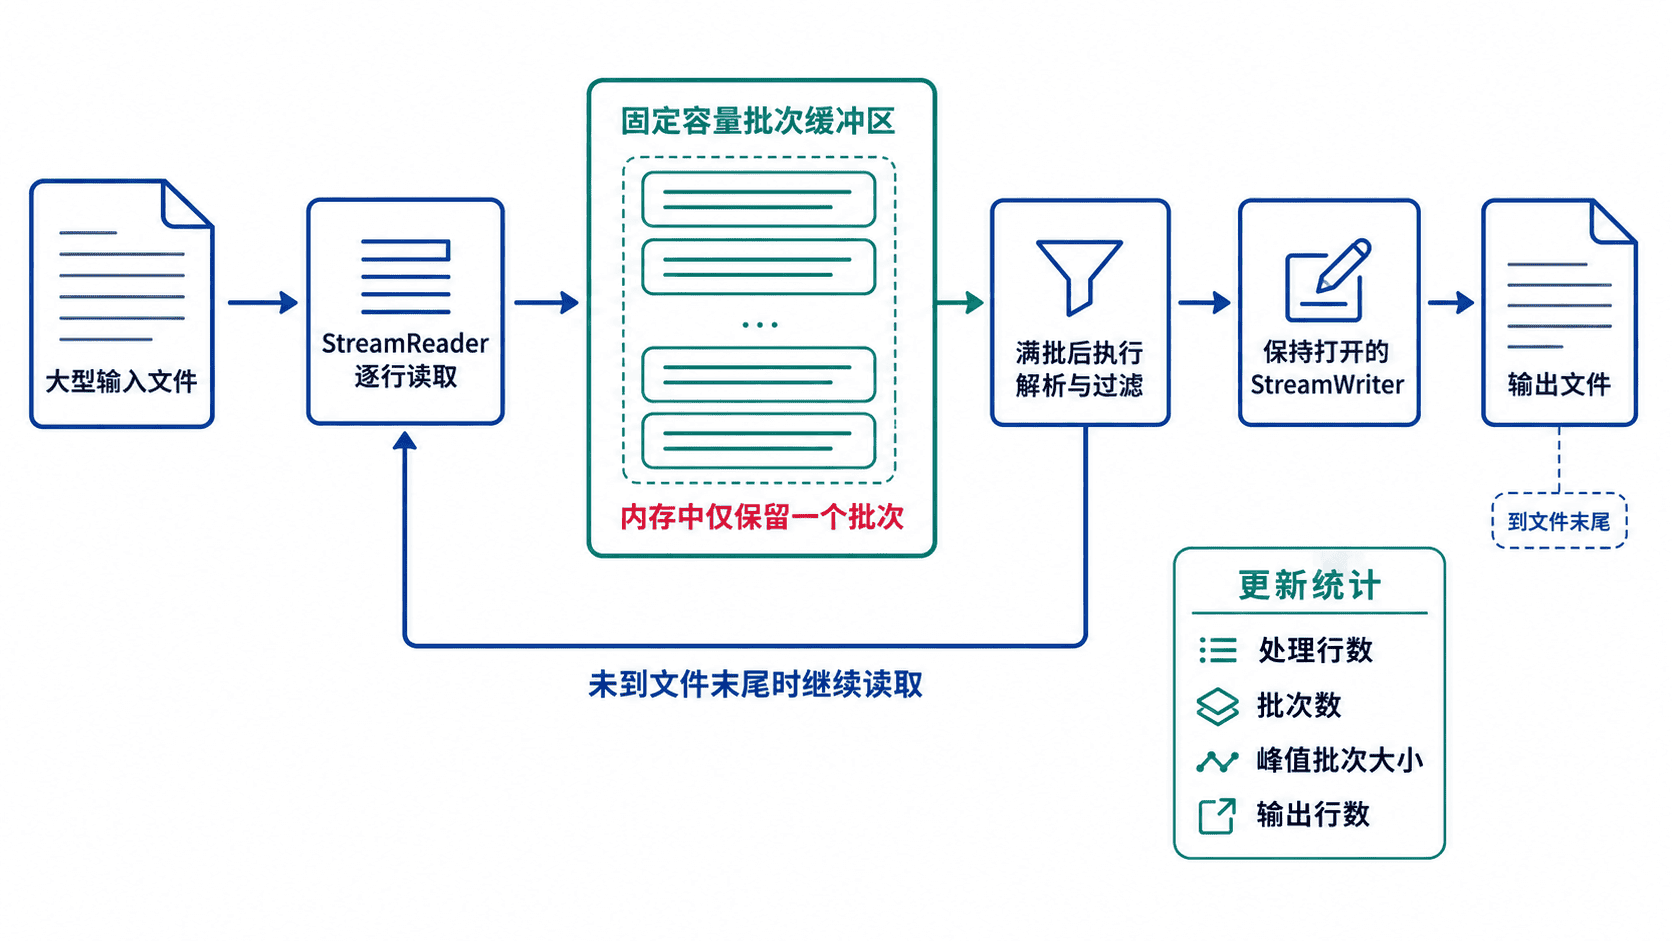
大型文件处理应把内存中的活动数据限制在一个小窗口内:读取一条、累计到固定批次、处理并写出,然后清空批次继续读取。文件总量增长时,内存不再近似随总行数增长。
流式批处理链路
这个任务同时包含读取端、批次缓冲区、转换逻辑、写入端和统计信息。流程图能直观看出任何时刻只有一个批次留在内存中,而不是保存整个文件。
主示例:流式读取并增量写入
脚本先生成 10000 行测试数据,再以每批 1000 行读取。只有状态为 SUCCESS 的记录会写入结果文件。try/finally 确保发生异常时也能关闭文件句柄。
function Write-Batch {
    param(
        [System.Collections.Generic.List[string]]$Lines,
        [System.IO.StreamWriter]$Writer,
        [hashtable]$Stats
    )

    foreach ($line in $Lines) {
        $parts = $line.Split('|')
        $Stats.Processed++

        if ($parts[1] -eq 'SUCCESS') {
            $Writer.WriteLine(
                "{0},{1},{2}" -f $parts[0], $parts[1], $parts[2]
            )
            $Stats.Written++
        }
    }

    $Stats.Batches++
    if ($Lines.Count -gt $Stats.PeakBatch) {
        $Stats.PeakBatch = $Lines.Count
    }
}

$inputPath = Join-Path $env:TEMP "large-input.txt"
$outputPath = Join-Path $env:TEMP "success-output.csv"
$utf8NoBom = [Text.UTF8Encoding]::new($false)

# 生成可重复验证的测试文件,真实任务中可替换为现有大文件。
$generator = [IO.StreamWriter]::new($inputPath, $false, $utf8NoBom)
try {
    for ($i = 1; $i -le 10000; $i++) {
        $status = if ($i % 2 -eq 0) { 'SUCCESS' } else { 'FAILED' }
        $generator.WriteLine("$i|$status|$($i % 1000)")
    }
}
finally {
    $generator.Dispose()
}

$batchSize = 1000
$batch = [Collections.Generic.List[string]]::new($batchSize)
$stats = @{
    Processed = 0
    Written   = 0
    Batches   = 0
    PeakBatch = 0
}

$reader = [IO.StreamReader]::new($inputPath, $utf8NoBom)
$writer = [IO.StreamWriter]::new($outputPath, $false, $utf8NoBom)

try {
    $writer.WriteLine("id,status,amount")

    while (($line = $reader.ReadLine()) -ne $null) {
        $batch.Add($line)

        if ($batch.Count -eq $batchSize) {
            Write-Batch -Lines $batch -Writer $writer -Stats $stats
            $batch.Clear()
        }
    }

    # 文件末尾不足一个完整批次时仍需处理。
    if ($batch.Count -gt 0) {
        Write-Batch -Lines $batch -Writer $writer -Stats $stats
        $batch.Clear()
    }
}
finally {
    $reader.Dispose()
    $writer.Dispose()
}

"Processed rows: $($stats.Processed)"
"Batches: $($stats.Batches)"
"Peak batch size: $($stats.PeakBatch)"
"Output rows: $($stats.Written)"

Remove-Item -Path $inputPath, $outputPath -Force
预期输出如下。示例中的临时目录实际路径会因操作系统和当前用户而不同。
Processed rows: 10000
Batches: 10
Peak batch size: 1000
Output rows: 5000
关键设计选择
StreamReader.ReadLine() 每次只返回一行,不会把整个文件读入内存。批次列表的容量由 $batchSize 控制,因此峰值业务数据量主要受单行大小和批次大小影响。
StreamWriter 在整个处理阶段保持打开,避免每写一条记录就重复打开文件。批次完成后调用 Clear() 会复用列表容量,减少频繁分配;最终批次必须单独处理,否则文件尾部会被遗漏。
编码应在读写两端显式指定。示例统一使用无 BOM 的 UTF-8;处理来源不明的文件时,应先确认编码,否则可能出现乱码、字段切分错误或不可见字符。
验证与调优
先核对输入行数、处理行数、输出行数和批次数,再抽查输出首尾记录。示例中的计数器不会保存每一条记录,因此能在不重新加载文件的前提下验证主流程是否完整。
批次过小会增加函数调用和写入调度次数,批次过大又会抬高内存峰值。可以从 1000 到 10000 行开始压测,并同时观察处理时间与进程内存;不要只追求更大的批次。
| 常见问题 | 直接后果 | 修复方式 |
|---|---|---|
使用 ReadAllLines() |
文件全部进入内存 | 改为 ReadLine() 循环 |
每行调用 Out-File -Append |
频繁打开文件,吞吐下降 | 复用一个 StreamWriter |
| 忘记处理尾批次 | 丢失文件末尾记录 | 循环结束后检查批次数量 |
| 未在异常时关闭流 | 文件锁定或缓冲区未落盘 | 使用 try/finally 调用 Dispose() |